
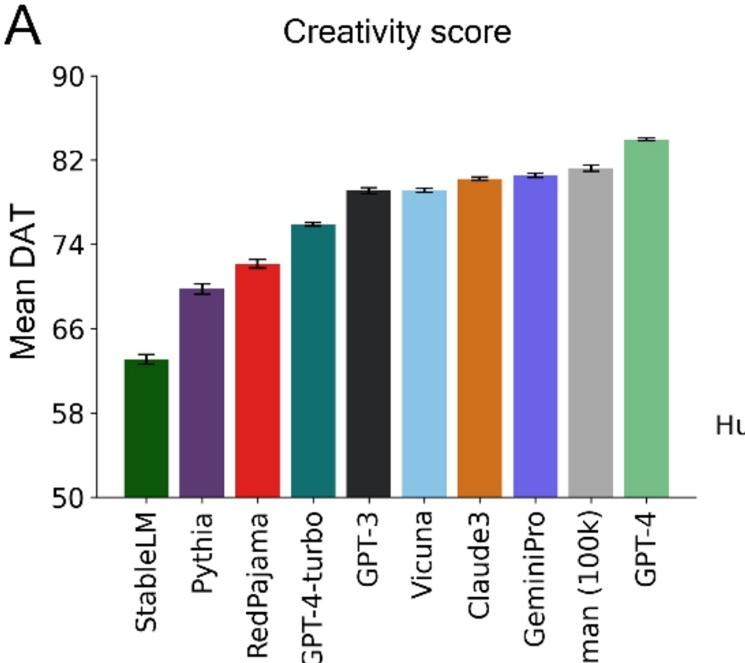
Исследователи сравнили способность к дивергентному мышлению у людей и современных больших языковых моделей. В основе масштабного эксперимента лежит простой тест на (Divergent Association Task, DAT), опубликованный в PNAS в 2021 году.
Его правила минимальны: за четыре минуты нужно назвать 10 существительных, значения которых максимально далеки друг от друга, избегая имен собственных и узкоспециальных терминов. Алгоритм вычисляет семантическое расстояние между парами слов по специальной семантической карте и ставит итоговый балл, оценивая способность находить неочевидные связи между далекими понятиями.
Команда ученых под руководством когнитивного нейробиолога Карима Жерби из Монреальского университета, куда также вошли создатель теста и иллюзионист Джей Олсон, композитор Антуан Бельмар-Пепен, комик из Google DeepMind Кори Мэтьюсон и лауреат премии Тьюринга Йошуа Бенджио, сравнила результаты 100 000 участников и девяти моделей ИИ. В исследовании, опубликованном в журнале Scientific Reports, участвовали GPT-3.5, GPT-4, GPT-4-turbo, Claude 3, Gemini Pro и ряд открытых моделей.
Результаты показали интересную картину:
Модель GPT-4 со стандартными настройками показала средний балл выше, чем среднестатистический человек. Gemini Pro показала результат на уровне среднего человеческого, а остальные модели уступили людям. При этом лучшая половина участников исследования (топ-50% из 100 000 человек) в среднем превзошла все протестированные нейросети, а наиболее креативные 10% людей опередили алгоритмы с еще более заметным отрывом. В творческих заданиях на написание хайку, синопсисов фильмов и микрорассказов тенденция сохранилась: модели справлялись уверенно, но уступали лучшим человеческим авторам.
Эксперимент выявил и влияние параметров генерации: при повышении температуры (параметра вариативности ответов) с 0.5 до 1.5 средний результат GPT-4 вырос до 85,6 балла, опередив 72% участников-людей. Дополнительные подсказки в промпте, например указание опираться на этимологию слов, также улучшали показатели моделей.
В то же время исследователи и эксперты отмечают несколько ограничений подобных тестов:
Во-первых, тест оценивает широту ассоциаций, но не измеряет практическую полезность или смысловую ценность идей, которые считаются обязательными признаками подлинного творчества.
Во-вторых, хотя отдельные модели показывают высокие баллы, ответы разных нейросетей от разных разработчиков часто оказываются поразительно однотипными и скученными в узком диапазоне, тогда как человеческие ответы демонстрируют гораздо большее разнообразие и оригинальность.
В-третьих, не исключен фактор загрязнения обучающих данных открытыми материалами теста, а также влияние регламента: при предоставлении людям большего времени и подробных инструкций разрыв между ними и ИИ существенно сокращается.
Исследование показывает, что современные языковые модели способны быстро генерировать нестандартные ассоциации на уровне выше среднего человека. Однако превзойти самых ярких авторов алгоритмы пока не могут, а само взаимодействие с ИИ через формулировку промптов и настройку параметров становится новым инструментом совместного творчества человека и машины.