
В области медицинского искусственного интеллекта произошло событие, которое можно назвать поворотным. Китайская исследовательская команда из лаборатории Alibaba DAMO Academy разработала модель DAMO RADAR — первый в мире универсальный экспертный ИИ для анализа медицинских изображений, способный диагностировать 146 заболеваний по 18 анатомическим структурам брюшной полости.
Работа была опубликована в журнале Science, что само по себе является редким случаем, поскольку это издание крайне редко принимает статьи, посвященные медицинскому визуальному ИИ, традиционно воспринимаемому как сугубо инженерная задача.
Исторически медицина оставалась одним из самых сложных испытаний для искусственного интеллекта. Еще в 2016 году Джеффри Хинтон предсказывал, что радиологов скоро перестанут готовить, поскольку ИИ вот-вот превзойдет их в распознавании снимков.
Однако спустя десять лет даже базовая задача распознавания изображений в клинических условиях остается трудной. Причина кроется в предельно высокой цене ошибки: если в других сферах галлюцинация модели вызывает лишь улыбку, то в медицине она может стоить жизни. Именно поэтому медицинский ИИ долгое время развивался в узких специализированных моделях, каждая из которых решала одну задачу.
Команда DAMO RADAR решила пойти против этой логики. Накопив опыт в разработке моделей для диагностики рака поджелудочной железы, желудка и кишечника, исследователи осознали тупиковость подхода, при котором на каждую болезнь уходят годы.
Кроме того, реальные пациенты редко приходят с единственным заболеванием: на одном снимке компьютерной томографии могут одновременно присутствовать патологии нескольких органов.
Так родилась идея создать универсальную модель для всей брюшной полости — области, которую клиницисты считают самой сложной. Молодые врачи, как правило, больше всего боятся работать именно с брюшной полостью, поскольку там расположены печень, поджелудочная железа, желчный пузырь, почки, селезенка и кишечник, все органы представляют собой мягкие ткани с близкой плотностью, и различить патологию можно лишь по тончайшим нюансам.
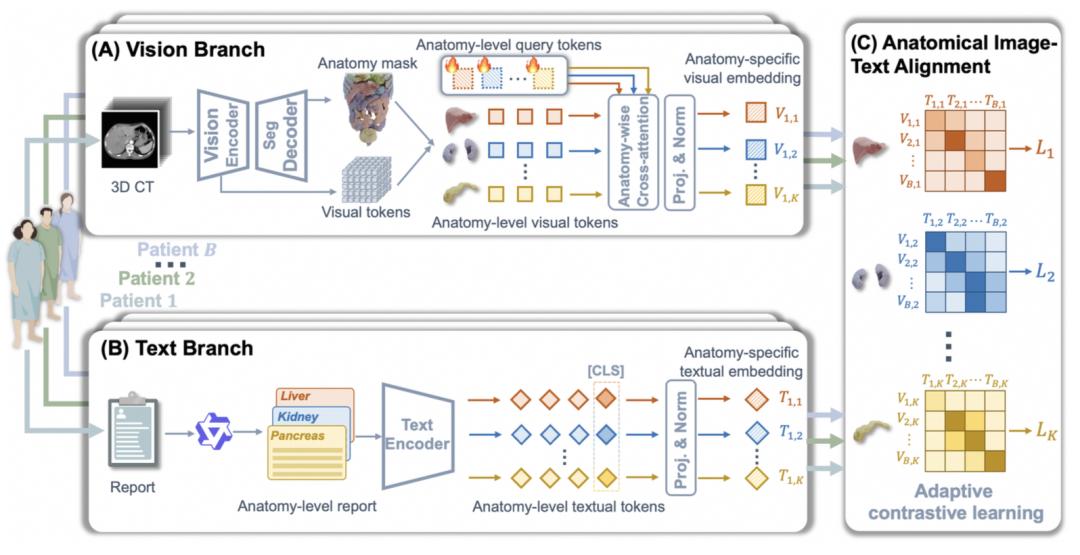
RADAR обучалась не на разметке, которую врачи делали бы вручную, а на естественной связи между снимками и текстовыми заключениями. Этот метод называется визуально-языковым контрастивным обучением.
Однако простое сопоставление целого снимка с целым отчетом оказалось неэффективным: модель улавливала лишь грубые статистические признаки и не могла установить, какой именно орган описан в заключении.
Ключевым прорывом стала так называемая «органо-уровневая мелкозернистая привязка»: система сначала выделяет на снимке каждый орган по отдельности, а затем сопоставляет его с соответствующим фрагментом текста. Это повторяет реальную логику работы радиолога, который последовательно осматривает печень, поджелудочную железу, желчные протоки, почки и кишечник, а не воспринимает живот как единое целое.
Дополнительным новшеством стало адаптивное контрастивное моделирование. В отличие от стандартного подхода, который требует строго разделять признаки разных пациентов, RADAR учитывает медицинские знания: если у двух людей печень здорова, их данные не должны искусственно противопоставляться, а если у двух пациентов одно и то же заболевание, их изображения следует сближать.
Кривая масштабирования, показывает, что с ростом объема данных производительность модели продолжает расти и не выходит на плато. Результаты проверки впечатляют.
На внутренней выборке из почти 39 тысяч реальных случаев средний показатель AUC достиг 0,913. На данных более 24 тысяч исследований из восьми внешних больниц, полученных на разном оборудовании в разных регионах, AUC составила 0,895.
Модель обобщилась даже на неотложные ситуации, где качество снимков хуже из-за спешки и отсутствия оптимального контрастирования: там AUC оказалась на уровне 0,904, хотя такие данные не использовались при обучении.
В четырех видах рака — печени, поджелудочной железы, желудка и кишечника — точность подтверждалась патологоанатомическим заключением как эталоном, и AUC колебалась от 0,891 до 0,984.
В прямом сравнении с 26 радиологами из 14 больниц RADAR превзошла 23 из них, уступив лишь трем опытным специалистам. При совместной работе врача и ИИ чувствительность диагностики выросла примерно на десять процентов, а среднее время чтения снимков сократилось более чем на тридцать процентов. Конфигурация «молодой врач плюс ИИ» по чувствительности превзошла даже опытного специалиста, работающего в одиночку.
Заведующая отделением радиологии Первой больницы Чжэцзянского университета Сяо Вэньбо, имеющая более тридцати лет стажа и руководящая коллективом из трехсот человек, призналась, что сначала не поверила данным проверки.
Описание одного брюшного исследования занимает у опытного врача не менее двадцати минут, а в день через отделение проходят тысячи снимков. Она отметила, что радиологам известно правило: одна болезнь может выглядеть по-разному, а разные болезни — одинаково.
Врач за всю жизнь может увидеть десятки тысяч снимков, но так и не столкнуться со всеми возможными вариантами. Именно в этом заключается главная ценность RADAR — она закрывает слепые зоны человеческого опыта и помогает не пропустить очаг поражения.
При этом Сяо Вэньбо не опасается, что ИИ заменит врачей. Она видит в нем инструмент наставничества: молодой специалист пишет заключение, а затем проверяет себя с помощью модели, мгновенно узнавая, какой очаг был пропущен или какое суждение оказалось ошибочным.
Это похоже на опытного руководителя, который стоит рядом и подсказывает. Кроме того, рамки органо-уровневой привязки применимы не только к компьютерной томографии, но и к магнитно-резонансной томографии, позитронно-эмиссионной томографии и ультразвуку, если есть соответствующие данные.
Все модели, код и техническая документация открыты, и любая команда может их воспроизвести, улучшить и адаптировать под свои задачи.
Успех RADAR выходит за рамки медицинского ИИ. Это доказательство того, что универсальная модель способна решать задачи целой области, даже в сфере с экстремально высокими требованиями к точности и минимальной терпимостью к ошибкам.
Если такой подход работает в медицине, где неверное суждение может изменить план лечения и повлиять на продолжительность жизни, то он с большой вероятностью применим и в других критически важных сценариях. Как отметил старший алгоритмический эксперт DAMO Academy Чжан Лин, Science крайне редко публикует статьи о медицинском визуальном ИИ, поскольку долгое время это воспринималось как инженерная проблема.
RADAR впервые доказала, что универсальный медицинский визуальный ИИ — это реально осуществимый научный путь, и рецензенты начали относиться к нему как к научному вопросу.
Сегодняшняя публикация — это не просто признание одной модели, а подтверждение целой возможности: использовать универсальный искусственный интеллект для решения самых твердых задач. Этот путь оказался рабочим.