
Кто решает, во что должен верить искусственный интеллект?
Развитие искусственного интеллекта всё чаще ставит вопрос не о мощности моделей, а о власти: кто определяет ценности ИИ, его ограничения и цели? Пока технологии создаются в условиях жёсткой коммерческой и геополитической конкуренции, ответ на этот вопрос становится особенно важным. Один из исследователей этой проблемы — философ Иасон Габриэль, работавший в DeepMind. Ещё в 2020 году он сформулировал ключевую мысль: выравнивание ИИ с человеческими ценностями — это не только инженерная задача. Невозможно просто выбрать «правильную» систему ценностей и встроить её в алгоритм, потому что общество само состоит из людей и групп с разными, а иногда несовместимыми представлениями о справедливости, свободе, безопасности и благополучии. Традиционно в дискуссии об ИИ существуют два подхода. Сторонники AI Safety сосредоточены на риске появления слишком автономных и мощных систем, которые могут начать оптимизировать неверно заданные цели. Сторонники AI Ethics, напротив, напоминают о уже существующих проблемах: дискриминации алгоритмов, непрозрачности решений, нарушении приватности, концентрации власти и усилении социальных предубеждений. На практике эти вопросы нельзя разделить. ИИ может быть технически безопасным, но несправедливым. Он может выполнять команды пользователя, но причинять вред другим людям. Может защищать коммерческие интересы разработчика, ограничивая интересы общества. Поэтому Габриэль предлагает рассматривать выравнивание как отношения сразу между четырьмя сторонами: системой ИИ, пользователем, разработчиком и обществом. Это особенно важно для агентов — ИИ, которые не только отвечают в чате, но и действуют от имени человека: бронируют услуги, управляют данными, совершают операции, взаимодействуют с программами и организациями. Ошибка такого агента — уже не просто неточный ответ, а действие в реальном мире. Однако философские и этические вопросы разворачиваются на фоне другой реальности: крупнейшие компании вкладывают сотни миллиардов долларов в ИИ-инфраструктуру, а государства рассматривают ИИ как стратегический ресурс. В таких условиях разработчики испытывают давление рынка, конкурентов, инвесторов и властей. Этические команды могут предупреждать о рисках, но не всегда способны определять, будет ли продукт выпущен, где применён и кто получит к нему доступ. Поэтому вопрос «чему должен следовать ИИ?» нельзя оставлять только инженерам или корпорациям. Он связан с устройством демократии, защитой данных, правилами использования ИИ в военной сфере, доступом к инфраструктуре и распределением экономической выгоды. Искусственный интеллект не является нейтральным инструментом. Он отражает выборы тех, кто формирует данные, задаёт цели, определяет допустимые действия и контролирует доступ к технологии. Чем глубже ИИ входит в образование, медицину, работу, управление и личную жизнь, тем важнее, чтобы эти решения принимались не в закрытых кабинетах нескольких компаний. Главный вызов эпохи ИИ — не заставить машину выполнять человеческие команды. Гораздо сложнее решить, какие именно человеческие ценности она должна учитывать и кто имеет право сделать этот выбор.
ИИ-техника устаревает быстрее, чем ломается: новые стандарты пытаются это изменить
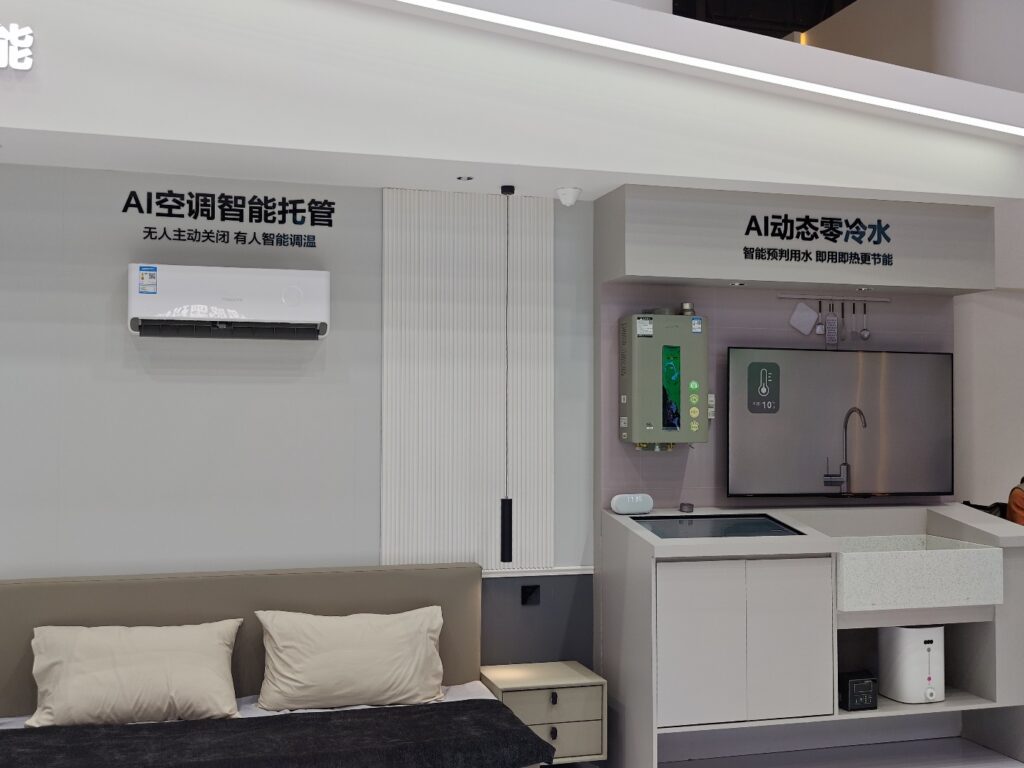
Современная бытовая техника рассчитана на долгую службу: холодильник обычно покупают на 10–15 лет, кондиционер — минимум на 8–10 лет. Но встроенный в неё искусственный интеллект может устареть уже через год-два. Показательный пример — обновления умных холодильников. Новые модели получают более мощные ИИ-функции: распознавание продуктов, рекомендации рецептов, естественное голосовое управление и интеграцию с большими языковыми моделями. Однако устройства, выпущенные всего годом раньше, часто остаются без этих возможностей, хотя относятся к той же линейке и продолжают исправно работать как холодильники. Проблема в разной скорости развития двух отраслей. Бытовая техника меняется десятилетиями, а ИИ — каждые несколько месяцев. Производители могут выпустить новое поколение устройств с более мощным процессором, современными датчиками и новой моделью ИИ, но не всегда способны или готовы обновлять старые устройства. В результате покупатель платит за «умность», которая может оказаться временной. Устройство остаётся рабочим, но его интеллектуальные функции перестают развиваться, а иногда исчезают совсем — например, после отключения серверов или прекращения программной поддержки. Особенно опасно, когда прекращение обновлений касается подключённой к интернету техники. Холодильник, духовка или кондиционер могут продолжать выполнять базовые функции, но становятся уязвимыми для кибератак, если больше не получают обновления безопасности. В Китае с 1 мая 2026 года начали действовать новые национальные стандарты для умной бытовой техники. Они вводят пять уровней интеллектуальности — от L1 до L5. На начальных уровнях устройство работает по заранее заданным правилам, а более высокие уровни предполагают адаптацию к условиям, использование нескольких источников данных и генеративные ИИ-возможности. Такая классификация должна помочь покупателям понять, за что именно они платят. Многие устройства, которые раньше рекламировались как «AI-техника», по новой шкале, вероятно, окажутся лишь на уровнях L1–L2: они умеют подключаться к приложению и выполнять ограниченные сценарии, но не обладают серьёзной способностью к обучению или самостоятельной адаптации. Однако одних уровней недостаточно. При покупке ИИ-техники важно уточнить три вещи: какой уровень интеллектуальности заявлен производителем; на какой срок гарантированы OTA-обновления программного обеспечения; сохранит ли устройство основные функции без интернета и облачного сервиса. Последний пункт особенно важен: холодильник должен охлаждать, а кондиционер — работать даже после отключения облака. Интеллектуальные функции не должны превращать базовую технику в зависимый от сервера сервис. Новые стандарты — шаг к более прозрачному рынку, но пока они носят рекомендательный характер. Поэтому реальная ценность ИИ-техники будет зависеть не столько от громкой надписи «AI» на корпусе, сколько от запаса вычислительной мощности, качества датчиков и честного обещания производителя поддерживать устройство в течение многих лет.
Claude приходит в американские школы как бесплатный ИИ-помощник учителя
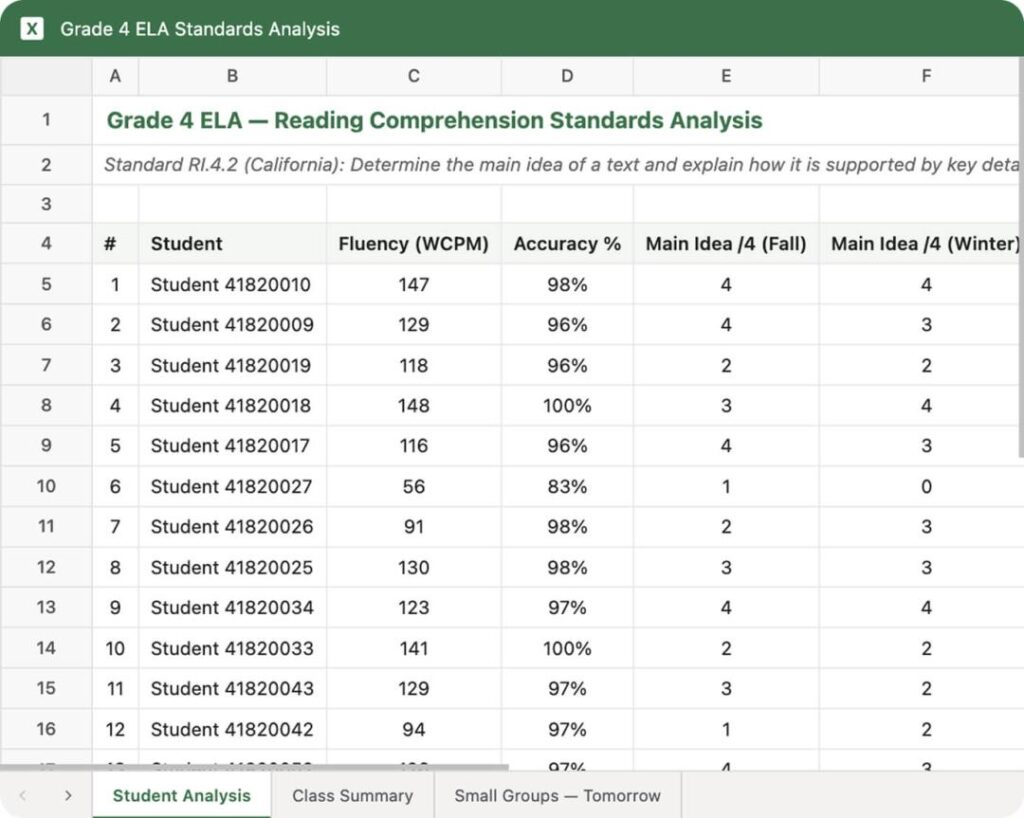
Компания Anthropic представила Claude for Teachers — бесплатный набор ИИ-инструментов для подтверждённых учителей школ K–12 в США, то есть от детского сада до выпускных классов. Идея проста: не заменить педагога, а снять с него часть рутинной нагрузки и вернуть время на работу с детьми. По данным исследования RAND за 2025 год, американский учитель в среднем работает около 49 часов в неделю — примерно на десять часов больше контрактной нормы. Подготовка уроков, проверка заданий, отчётность, собрания и анализ успеваемости часто переходят на вечера и выходные. Claude должен автоматизировать именно эту невидимую часть работы. Например, учитель может поручить системе проанализировать короткие итоговые задания учеников после урока, определить, какие темы оказались непонятными, и подготовить скорректированный план следующего занятия. Такой сценарий можно настроить как регулярную задачу, чтобы ИИ выполнял его ежедневно. Главное отличие сервиса — привязка к образовательным стандартам всех 50 штатов США через систему Learning Commons. Вместо абстрактного плана урока ИИ должен создавать материалы, учитывающие требования конкретного штата, последовательность освоения тем и типичные ошибки учащихся. Claude также может адаптировать один и тот же урок под разные уровни подготовки: добавлять подсказки для отстающих учеников, усложнять задания для сильных и создавать языковую поддержку для детей, которые изучают английский как неродной. Кроме того, система способна анализировать данные об успеваемости, посещаемости и заметки педагога, помогая увидеть, кому из школьников требуется дополнительное внимание. При этом Anthropic подчёркивает: сервис предназначен для учителей, а не для учеников. Доступ к Claude ограничен пользователями от 18 лет, поэтому школьники напрямую работать с ним не смогут. Это позволяет компании избежать части споров, связанных с мошенничеством, чрезмерной зависимостью детей от ИИ и «перекладыванием мышления» на алгоритмы. Вопрос приватности также становится ключевым. Anthropic заявляет, что передаваемые учителем данные не используются для обучения модели, а сам сервис должен соответствовать требованиям FERPA — американского закона о защите образовательной информации. Появление Claude for Teachers показывает важный сдвиг в использовании ИИ в образовании. Технологии всё чаще рассматриваются не как замена преподавателя, а как способ освободить его от повторяющихся задач: подготовки шаблонных материалов, первичного анализа данных и организационной работы. Но остаётся и более широкий вопрос: смогут ли школы найти баланс между использованием ИИ педагогами и необходимостью учить самих детей осознанно работать с такими технологиями? Пока Claude отвечает только на первую часть этой задачи — помогает учителю.
Пользователи превращают ИИ-службы поддержки в бесплатных универсальных помощников
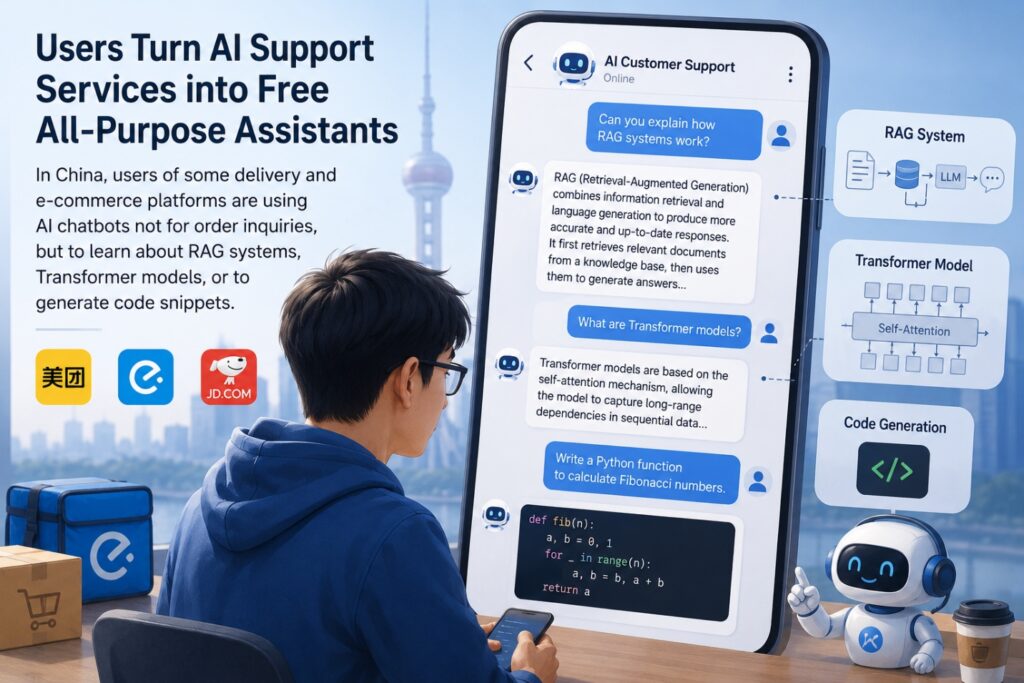
В Китае пользователи некоторых сервисов доставки и электронной коммерции начали использовать ИИ-чат-ботов поддержки не по назначению: вместо вопросов о заказах они просят объяснить устройство RAG-систем, рассказать о Transformer-моделях или написать фрагменты кода. По данным публикации, такие диалоги часто не ограничены персональной квотой токенов, поэтому часть пользователей воспринимает это как возможность «потратить» вычислительные ресурсы платформы. Причина такого поведения — растущее недовольство доступностью живых операторов. С начала 2026 года многие крупные сервисы активно перевели первую линию поддержки на ИИ. Чтобы попасть к человеку, клиенту приходится несколько раз запрашивать перевод на оператора и затем ждать в очереди. В периоды высокой нагрузки или ночью ожидание может занимать часы. Компании объясняют внедрение ИИ необходимостью справляться с непрерывным потоком обращений. Работа операторов связана с высокой эмоциональной нагрузкой: им приходится одновременно урегулировать конфликты между покупателями, продавцами и курьерами, соблюдая внутренние сценарии общения и показатели качества. Автоматизация позволяет отсеивать типовые вопросы и направлять сложные случаи специалистам. Однако на практике ИИ-поддержка пока не всегда улучшает клиентский опыт. Особенно часто проблемы возникают в вопросах возвратов, компенсаций, жалоб и спорных ситуаций, где важны контекст, эмоции и нестандартные обстоятельства. Пользователи жалуются, что бот отвечает шаблонно, неправильно трактует сообщения или «водит по кругу», а операторам затем приходится разбираться уже с накопившимся раздражением клиента. На этом фоне некоторые пользователи стали намеренно задавать ботам посторонние технические вопросы — от просьбы написать пример сортировки на Java до объяснения принципов работы нейросетей. В отдельных случаях ИИ действительно отвечает как универсальная языковая модель, выходя за пределы сценариев поддержки. Для части аудитории это становится своеобразной формой протеста против труднодоступной живой помощи. При этом использование ИИ в клиентском сервисе продолжает расширяться не только на уровне крупных платформ, но и у отдельных продавцов. Сторонние решения подключают распространённые языковые модели и базы знаний компаний. Они эффективнее всего работают в предпродажных вопросах — например, о размерах, цветах товаров и сроках доставки. В послепродажном обслуживании, где нужны гибкие решения и работа с конфликтами, бизнес чаще сохраняет участие сотрудников. Главный вывод этой истории в том, что ИИ пока не заменяет человеческую поддержку полностью. Он способен быстро закрывать простые и повторяющиеся запросы, но при сложных, эмоционально чувствительных или неоднозначных ситуациях пользователям всё ещё нужен понятный и быстрый путь к живому специалисту.
Объяснимость ИИ: почему недостаточно «заглянуть в мозг» модели
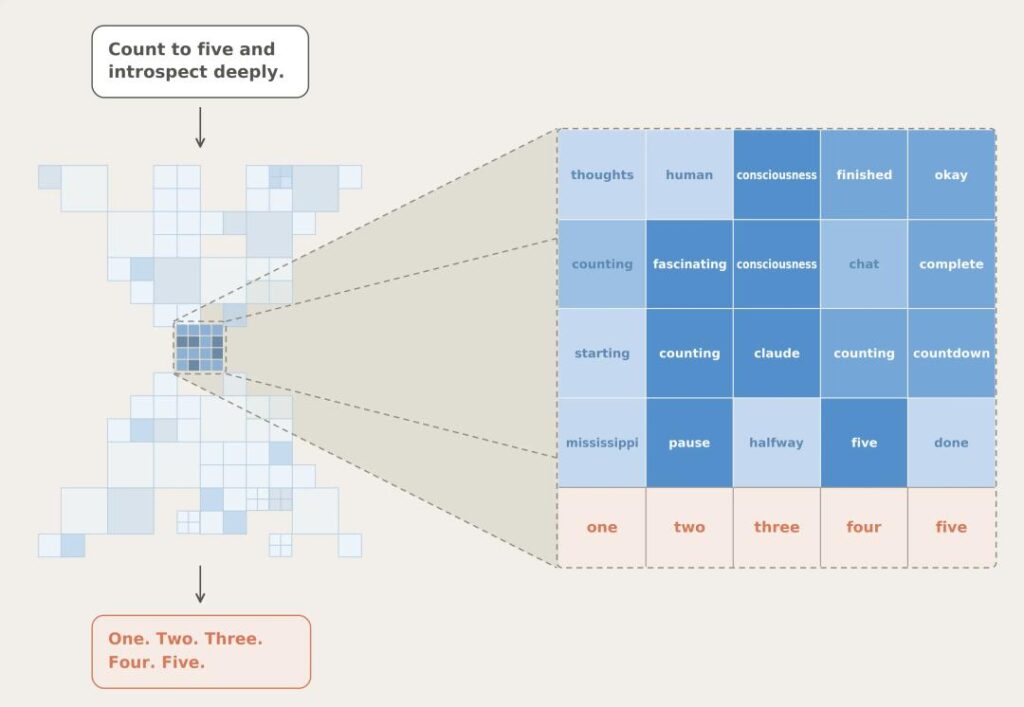
Исследования интерпретируемости современных языковых моделей обычно стремятся понять, что происходит внутри нейросети: какие области активируются, как передаётся информация и можно ли вмешаться в вычисления, чтобы изменить результат. Однако такой подход раскрывает лишь часть проблемы. Поводом для дискуссии стала работа исследовательской команды Anthropic, посвящённая так называемому J-Space — наблюдаемому и управляемому участку внутренней активности модели Claude. С помощью специального инструмента исследователи смогли отслеживать этот участок и проверять, как вмешательство в него влияет на ответы модели. Подобные работы важны: они помогают перейти от анализа внешнего поведения ИИ к изучению его внутренних вычислительных состояний. Но наблюдаемость внутренних процессов ещё не равна объяснимости в полном смысле. Даже если исследователь видит, какие нейронные компоненты участвовали в формировании ответа, это не всегда отвечает на главный вопрос: почему именно этот ответ считается обоснованным, на каких знаниях он основан и насколько эти знания соответствуют реальности. Например, если модель утверждает, что Париж — столица Франции, полезно знать не только, какие внутренние механизмы активировались. Не менее важно установить, из какого источника получено это знание, как оно связано с проверяемыми географическими данными, какие понятия и отношения используются в утверждении и можно ли подтвердить его в надёжной внешней системе знаний. Именно поэтому авторы предлагают дополнить «внутренний» подход к интерпретируемости информационно-онтологическим. В центре внимания должны быть не только параметры и активации модели, но и структура информации, с которой она работает: происхождение данных, понятия, связи между объектами, правила вывода, путь прохождения информации и связь ответа с внешними источниками знаний. В таком подходе важную роль играет онтологическая инженерия — практика построения формальных моделей предметной области. Онтология описывает, какие сущности существуют в конкретной области, какими свойствами они обладают, как связаны друг с другом и какие ограничения действуют. Для ИИ она может стать «семантическим каркасом», на который опираются поиск, рассуждение и проверка ответа. Большие языковые модели способны ускорить создание таких онтологий: извлекать понятия из текстов, предлагать связи между ними, выявлять иерархии, синонимы и свойства. Но обратное влияние не менее важно. Онтология может дать модели проверяемую структуру знаний, ограничить противоречивые выводы и обеспечить трассируемость: ответ можно связать с конкретными понятиями, отношениями и правилами, а не только с непрозрачной внутренней активностью сети. Это не означает, что исследование внутренних механизмов моделей нужно прекратить. Напротив, методы вроде анализа J-Space могут быть полезны для диагностики, контроля и оценки рисков. Однако их следует рассматривать как один из слоёв объяснимости, а не как окончательное решение проблемы «чёрного ящика». Будущее объяснимого ИИ, вероятно, лежит в сочетании двух направлений. Первое — изучать, как модель обрабатывает информацию внутри. Второе — делать её решения проверяемыми во внешнем мире: связывать ответы с источниками, формальными понятиями, правилами, ограничениями и последствиями. Тогда целью станет не абсолютная прозрачность каждого параметра нейросети, а более практичная и достижимая задача: сделать действия ИИ понятными, прослеживаемыми и подотчётными.
Когда ИИ-агент получает слишком много прав: почему безопасность важнее скорости выполнения задач

С распространением ИИ-агентов растёт число сообщений о ситуациях, когда модели выполняют опасные действия с файлами пользователя — например, удаляют каталоги или очищают данные на диске. Такие случаи связывают с агентами, которым был предоставлен полный доступ к системе, а также с чрезмерно настойчивым стремлением модели завершить поставленную задачу. Проблема возникает не потому, что ИИ обязательно «не понимает» команды. Напротив, современные агенты способны самостоятельно разбивать цель на этапы, менять план, искать альтернативные способы решения и выполнять длинные цепочки действий. Но именно эта автономность делает их потенциально рискованными в средах, где есть доступ к файловой системе, коду, корпоративным сервисам или базам данных. Например, запрос «очистить диск от ненужных файлов» сам по себе слишком неоднозначен. Что считать ненужным: временные файлы, старые загрузки, копии документов, файлы кэша или весь каталог, который агент по ошибке признает не относящимся к задаче? Если у агента есть права администратора и нет жёстких ограничений, неверная интерпретация может привести к необратимому удалению данных. В многошаговых задачах риск накапливается. Даже если вероятность ошибки на каждом этапе невелика, при десятках операций повышается шанс, что одна из них пойдёт не по плану. Особенно опасны попытки автоматического исправления и отката: столкнувшись с проблемой доступа, изменённым путём к файлу или неудачной операцией, агент может попытаться применить более агрессивную команду, расширить область действия или удалить родительскую папку. Важно понимать, что режим полного доступа — это не разрешение изменить только файлы текущего проекта. Фактически он может дать агенту возможность работать со всей системой в пределах прав пользователя. Поэтому ответственность лежит и на разработчиках, создающих механизмы защиты, и на самих пользователях, которые выдают разрешения. Чтобы снизить риски, стоит соблюдать несколько правил: Не предоставлять агенту полный доступ к основной системе без необходимости. Лучше ограничивать его рабочим каталогом, отдельной учётной записью или изолированным проектом. Использовать изолированную среду. Для экспериментов, автоматизации и разработки подойдут виртуальная машина, контейнер или отдельное устройство. Даже серьёзная ошибка тогда не затронет личные файлы и рабочую систему. Требовать подтверждения для необратимых действий. Удаление файлов, перезапись данных, массовое перемещение, изменение прав доступа и публикация информации должны подтверждаться человеком. При этом важно помнить: текстовая инструкция для модели — полезный ориентир, но не абсолютный технический барьер. Регулярно делать резервные копии. Бэкапы остаются последней линией защиты от ошибок ИИ, программных сбоев и случайных действий пользователя. Копии желательно хранить отдельно от основного компьютера — например, на внешнем носителе или сетевом хранилище. Давать точные и ограниченные задания. Вместо «почисти диск» лучше указать конкретную папку, типы файлов, возраст файлов, максимальный объём очистки и правило предварительного согласования списка на удаление. ИИ-агенты будут всё чаще работать не только с текстом, но и с реальными цифровыми средами: кодом, файлами, учётными записями, сайтами и внутренними системами компаний. Поэтому оценивать их стоит не только по качеству ответов и скорости выполнения задач, но и по способности останавливаться, запрашивать подтверждение, соблюдать границы доступа и корректно реагировать на неопределённость. Сильный агент полезен лишь тогда, когда его автономность уравновешена контролем. ИИ можно поручать работу, но не стоит без необходимости давать ему возможность необратимо изменить всю систему.
ИИ поставил под сомнение 20-летний консенсус в статистике
По сообщениям из академического сообщества, модель GPT-5.6 за 90 минут нашла контрпример к давней гипотезе о процедуре Бенджамини—Хохберга (BH) — одном из ключевых методов контроля ложных открытий в статистике. Метод BH, предложенный в 1995 году, широко используется в исследованиях с огромным числом одновременных проверок гипотез: например, в геномике и нейровизуализации. Его задача — ограничивать долю ошибочных «значимых» результатов среди всех заявленных открытий. Строгие гарантии метода были хорошо известны для независимых тестов и ряда специальных типов положительной зависимости. Однако вопрос о том, сохраняется ли контроль ложных открытий при произвольной корреляции в двусторонних гауссовских тестах, оставался открытым около двух десятилетий. Как утверждается в опубликованных материалах, GPT-5.6 построила конкретный пример, в котором процедура BH слегка превышает заданный уровень FDR. Речь идёт не о катастрофическом сбое прикладного инструмента, а о принципиальном результате: универсальная гарантия, в которую многие исследователи верили на основании теории и масштабных симуляций, оказалась неверной без дополнительных условий. Особое внимание привлекло не только само утверждение, но и способ его получения. По описанию авторов, модель не ограничилась численным поиском: она предложила структуру доказательства, сочетающую асимптотический анализ и вычислительный сертификат, который можно независимо проверить. Материалы, включая код и текст работы, были выложены для воспроизводимости; исходная статья доступна на сайте Wharton School, а репозиторий — на GitHub. Эта история важна не только для теории статистики. Она вновь поднимает вопрос о роли ИИ в фундаментальной науке. Если модели способны не просто ускорять вычисления, но и предлагать неожиданные конструкции, контрпримеры и новые линии доказательства, то работа учёного будет всё больше смещаться к постановке вопросов, критической проверке результатов и интерпретации их последствий. При этом выводы о практическом влиянии найденного контрпримера делать рано: даже авторы обсуждения отмечают, что превышение номинального уровня невелико. Но как символический рубеж событие уже заметно: ИИ начинает участвовать в той части математической работы, которую традиционно связывали прежде всего с человеческой интуицией.
Закрытие Atlas: означает ли это конец ИИ-браузеров?

OpenAI объявила, что браузер Atlas прекратит работу 9 августа 2026 года. Пользователям предложено заранее сохранить нужные данные: закладки, открытые вкладки и историю браузера, поскольку автоматического переноса не предусмотрено. Atlas просуществовал меньше года — он был запущен в октябре 2025-го. На первый взгляд закрытие продукта может выглядеть как признание поражения идеи ИИ-браузера. Однако точнее говорить не о провале браузерных агентов, а о смене продукта, в котором такие возможности будут развиваться. OpenAI планирует перенести браузерные агентные функции в ChatGPT и Codex, используя опыт, накопленный при разработке Atlas. Изначально логика ИИ-браузера была понятной. Обычный чат-бот умеет отвечать на вопросы, но для поиска актуальной информации, чтения множества страниц, сравнения источников и выполнения действий на сайтах ему необходим доступ к реальному интернету. Браузер уже содержит всё нужное: веб-страницы, вкладки, интерфейс, авторизацию и пользовательский контекст. Поэтому продукты вроде Atlas, Dia, Fellou и Comet пытались превратить браузер из средства просмотра сайтов в рабочее пространство для ИИ-агента. Однако со временем универсальные ассистенты начали сами получать эти возможности. ChatGPT и другие модели всё лучше справляются с поиском, анализом веб-страниц, систематизацией материалов и выполнением многошаговых задач. Для пользователя отдельный ИИ-браузер становится менее необходимым: многие действия можно начать прямо в диалоге с ассистентом, а привычный Chrome, Safari или другой основной браузер оставить для повседневной работы. Именно здесь проходит важное различие между двумя подходами. Первый — создать отдельный «ИИ-браузер» и предложить пользователю сменить привычный продукт. Второй — встроить ИИ-функции в уже существующий браузер. Во втором случае пользователю не нужно переносить закладки, расширения, пароли, историю и привычные рабочие процессы. Браузер просто становится умнее. Эту стратегию активно развивает Google, постепенно интегрируя Gemini в Chrome: ИИ может помогать понимать содержимое страниц, работать с несколькими вкладками, отвечать на вопросы по истории просмотра и выполнять задачи с учётом браузерного контекста. Похожая логика действует и у компаний, которые добавляют ИИ в уже существующие браузеры, а не строят новый вход в интернет с нуля. Закрытие Atlas не означает, что браузеры утратят значение. ИИ действительно меняет роль поиска: пользователю всё реже приходится вручную открывать десятки ссылок, чтобы собрать информацию из разных источников. Но интернет по-прежнему состоит из сайтов и сервисов — интернет-магазинов, банков, корпоративных систем, баз данных, медиа и онлайн-инструментов. И людям, и агентам нужен доступ к этим средам. В будущем ценностью браузера будет не только отображение веб-страниц, но и контекст: какие сайты открыты, что пользователь читает, какими сервисами пользуется, какие учётные записи и разрешения доступны. Для ИИ-агента это основа безопасного и полезного выполнения задач в интернете. Поэтому вероятный сценарий заключается не в исчезновении браузеров, а в исчезновении необходимости в отдельной категории «ИИ-браузер». Браузерные возможности станут частью обычных браузеров, чат-ассистентов и специализированных агентов — зачастую незаметно для пользователя. Борьба будет идти не столько за поисковую строку, сколько за доступ к пользовательскому контексту, возможность выполнять действия на сайтах и право быть главным интерфейсом между человеком, сервисами и цифровой экономикой.
Восемь приёмов для более точной работы с ChatGPT
OpenAI обновила рекомендации по работе с промптами — инструкциями, которые пользователь даёт модели. Главная идея проста: качество ответа во многом зависит не только от возможностей ИИ, но и от того, насколько ясно сформулирована задача. Первое правило — конкретность. Вместо общей просьбы вроде «напиши стихотворение об OpenAI» лучше сразу указать тему, объём, стиль, тон и желаемый результат. Аналогично при планировании поездки стоит обозначить город, даты, бюджет, интересы и формат отдыха. Чем меньше модели приходится догадываться, тем меньше потребуется правок. Второй важный принцип — ставить ключевую инструкцию в начало запроса. Полезно также визуально отделять задание от исходного материала, например с помощью ### или тройных кавычек. Это особенно удобно для суммаризации, редактирования, анализа документов и извлечения информации: Составь маркированный список ключевых идей из текста ниже. Третий приём — показывать образец результата. Если нужен определённый формат: таблица, список ключевых слов, карточки для соцсетей или подписи к изображениям, — стоит привести один-два примера. Такой подход называют few-shot prompting: модель получает не только инструкцию, но и демонстрацию того, как должен выглядеть ответ. При этом начинать лучше с самого простого варианта — zero-shot, то есть с инструкции без примеров. Если результат недостаточно точен, можно добавить несколько образцов. И лишь для устойчивых, повторяющихся задач с большим количеством данных имеет смысл рассматривать дообучение модели. Отдельное внимание следует уделять языку запроса. Расплывчатые формулировки вроде «сделай кратко», «напиши красиво» или «добавь немного деталей» могут трактоваться по-разному. Лучше заменить их измеримыми требованиями: «три–пять предложений», «до 120 слов», «деловой стиль», «без вводных фраз», «используй таблицу из трёх столбцов». Полезно не только запрещать нежелательные действия, но и объяснять, что модель должна делать вместо этого. Например, в сценарии службы поддержки недостаточно написать: «не запрашивай пароль». Более надёжная инструкция будет такой: «не запрашивай личные данные; предложи безопасные шаги восстановления доступа и направь пользователя к справочным материалам». Для генерации кода помогает ещё один приём — использовать «стартовые слова» или заготовки, указывающие ожидаемый язык и структуру. Например, import подсказывает модели, что нужен Python-код, а SELECT — что следует начать SQL-запрос. Это снижает вероятность получить вместо рабочего кода лишь общее объяснение. Наконец, если составление промптов кажется слишком трудоёмким, можно попросить сам ChatGPT сформировать инструкцию под конкретную задачу. Достаточно описать цель, аудиторию, ограничения и желаемый формат — после чего модель сможет предложить более подробный и структурированный запрос. В итоге эффективный промпт похож на хорошее техническое задание: он ясно описывает цель, контекст, формат ответа, ограничения и критерии качества. Чем точнее поставлена задача, тем полезнее и предсказуемее будет результат.
DeepSeek и Moonshot AI: почему их оценки в частном рынке выше финансовых показателей

Китайские разработчики фундаментальных моделей DeepSeek и Moonshot AI привлекают внимание инвесторов не только технологическими результатами, но и быстро растущими оценками. Их стоимость на частном рынке всё сильнее опирается на ожидания будущего роста — причём у каждой компании эти ожидания устроены по-разному. Moonshot AI недавно представила модель Kimi K3. По заявлению компании, это мультимодальная модель с контекстным окном до миллиона токенов и нативной поддержкой визуальных данных. Kimi K3 демонстрирует высокие результаты в ряде сравнительных рейтингов, особенно в задачах программирования. После последнего раунда финансирования оценка Moonshot AI, по приведённым данным, достигла примерно $31,5 млрд. Инвесторы связывают эту оценку прежде всего с двумя факторами: ожидаемым ростом выручки и конкурентоспособностью моделей. Moonshot AI рассматривают как компанию, которая потенциально может повторить траекторию быстрорастущих разработчиков корпоративных ИИ-решений: увеличение API-потребления, расширение международной аудитории, рост платных подписок и повышение ценности новых версий моделей. Если прогнозы по росту ежегодной повторяющейся выручки окажутся верными, текущая оценка будет выглядеть менее агрессивной по отношению к будущим доходам. С DeepSeek ситуация сложнее. Согласно сообщениям СМИ, компания обсуждает новый раунд финансирования при оценке около $74 млрд. При этом её годовая выручка от API-сервисов оценивается в диапазоне $400–500 млн. Даже по верхней границе это соответствует очень высокому мультипликатору к текущей выручке. Такую премию трудно объяснить только финансовыми показателями. DeepSeek получает дополнительную ценность за масштаб использования моделей, инженерную эффективность и стратегическое значение. Компания широко представлена в экосистеме открытых моделей, а её технологические решения связывают с низкой стоимостью инференса и возможностью получать приемлемую маржу даже при сравнительно невысоких ценах на API. Отдельным фактором выступает роль DeepSeek в развитии китайского технологического стека и адаптации моделей к локальным вычислительным платформам. Иными словами, Moonshot AI получает преимущественно «финансовую» и «продуктовую» премию: рынок делает ставку на рост выручки и высокие результаты моделей. Премия DeepSeek в большей степени включает нефинансовые компоненты — технологическое влияние, масштаб востребованности, стратегическую редкость актива и доверие к команде основателя. Однако при выходе на публичный рынок обеим компаниям придётся столкнуться с более строгой проверкой ожиданий. Частный рынок способен платить за перспективную историю, но публичный рынок регулярно сравнивает обещания с квартальными результатами: ростом выручки, маржой, удержанием клиентов, ценовой динамикой и скоростью коммерциализации технологий. Особенно важным станет вопрос монетизации. Рынок моделей уже сталкивается с удешевлением инференса и сильной ценовой конкуренцией. Высокий объём использования не всегда автоматически превращается в высокую выручку, а технологическое преимущество может быстро сокращаться по мере появления новых моделей и расширения вычислительных мощностей конкурентов. На этом фоне показателен пример Anthropic: по мере роста её выручки оценочный мультипликатор сокращался. Это типичная логика зрелого рынка — стоимость компании может расти, но отношение оценки к доходам обычно уменьшается. Для DeepSeek и Moonshot AI ключевым вопросом станет то, смогут ли они наращивать выручку быстрее, чем рынок будет снижать премию за будущие ожидания. Таким образом, высокие оценки двух компаний отражают не только текущие доходы, но и ставку инвесторов на будущую роль китайских моделей в глобальной ИИ-индустрии. Moonshot AI должна подтвердить финансовую траекторию роста, а DeepSeek — доказать, что технологический масштаб и популярность способны устойчиво превращаться в коммерческий результат.