
Почему Claude Code может «тупить»: дело не всегда в модели
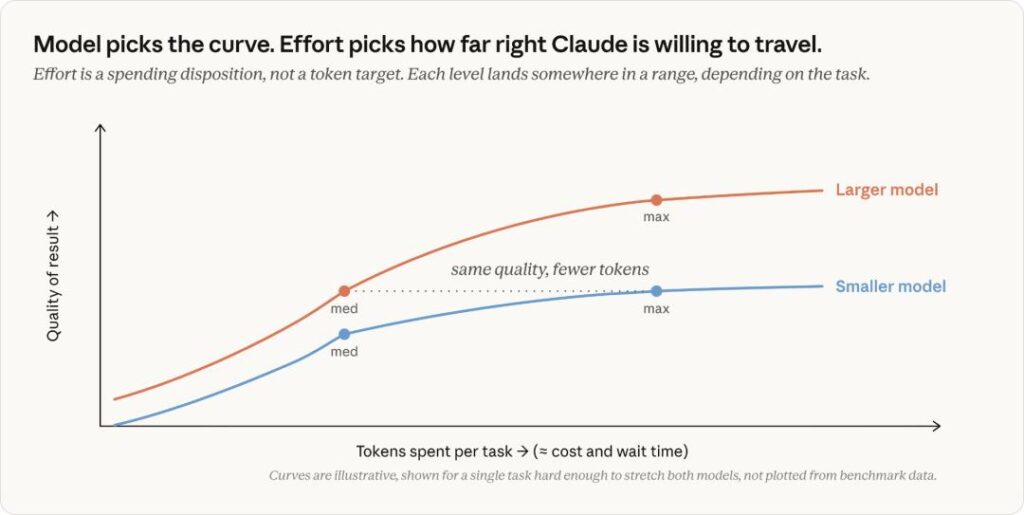
Пользователи ИИ-инструментов для программирования часто считают, что качество результата определяется только выбранной моделью: чем она крупнее и дороже, тем лучше должна писать код. Однако опыт пользователей Claude Code показывает, что это упрощение может быть дорогостоящим. Anthropic отдельно объяснила разницу между двумя настройками: Model и Effort. Первая определяет базовые способности модели, а вторая — то, насколько тщательно она будет выполнять конкретную задачу. Условно говоря, модель — это «мозг», а уровень усилий — её «рабочий режим». Модель задаёт фундаментальные возможности системы: знания, навыки рассуждения, способность понимать сложные архитектуры и решать нетиповые задачи. После обучения параметры модели фиксируются. Пользователь может дать ей документацию, кодовую базу или инструкции, но не может изменить её внутренние знания. Если модель не понимает незнакомую технологию или стабильно выдаёт неверное решение даже при полном контексте, увеличение усилий не поможет — вероятно, нужна более сильная модель. Настройка Effort, напротив, влияет на объём работы, который Claude готов выполнить в рамках одного запроса. При низком уровне система скорее даст быстрый ответ, запросит дополнительную информацию или остановится на промежуточном результате. При высоком — будет читать больше файлов, вызывать инструменты, запускать тесты, перепроверять выводы и дольше доводить многошаговую задачу до конца. Именно из-за этой разницы в начале марта возникло недовольство среди пользователей Claude Code. Anthropic снизила стандартный уровень Effort с high до medium, чтобы уменьшить задержки. Многие разработчики восприняли это как ухудшение самой модели: ИИ стал пропускать файлы, не запускать тесты, бросать задачу на середине и чаще задавать уточняющие вопросы. По данным, обсуждавшимся в сообществе, в отдельных сценариях объём внутренней работы мог заметно сократиться. Позже компания вернула более высокий уровень по умолчанию. Главный вывод: если ИИ ошибается, не стоит автоматически переключаться на самую дорогую модель. Сначала важно проверить контекст. Чётко ли сформулирована задача? Есть ли у агента нужные файлы, доступы, инструменты, правила проекта и документация? Значительная часть проблем возникает не из-за «слабого ИИ», а из-за неполной постановки задачи. После этого полезно определить характер ошибки. Если агент не прочитал нужные файлы, не выполнил тесты, не проверил результат или преждевременно вернулся с вопросами, проблема может быть в недостаточном Effort. В таком случае разумнее повысить уровень усилий. Если же система получила полный контекст, использовала доступные инструменты и всё равно не смогла решить задачу, тогда есть смысл перейти на более сильную модель. Этот подход меняет саму логику работы с ИИ-разработчиками. Вместо поиска одного «самого умного» помощника появляется задача диспетчеризации: простые правки можно поручать более дешёвой модели в быстром режиме, крупный рефакторинг — модели посильнее с высоким уровнем Effort, а самые сложные задачи — специализированной модели, способной работать дольше и подключать дополнительные агенты. При этом высокий Effort не является бесплатным. Он может увеличивать число сгенерированных токенов в несколько раз, поскольку ИИ больше читает, проверяет и вызывает инструменты. Поэтому оптимальная стратегия — не всегда использовать максимальный режим, а выбирать сочетание модели и усилий под конкретную задачу. В результате ключевым навыком становится не только умение писать запросы, но и умение грамотно распределять задачи между ИИ-агентами. Дорогая модель, запущенная в поверхностном режиме, может оказаться менее полезной, чем более доступная модель, которой дали достаточно контекста, времени и права тщательно проверить свою работу.
Китайская ИИ-инфраструктура меняет принцип организации

Мировая гонка за вычислительными мощностями для искусственного интеллекта долго измерялась простыми показателями: количеством GPU, размером кластеров и объёмом инвестиций. Однако за рекордными цифрами всё важнее становится другой вопрос: кому принадлежат эти ресурсы и кто действительно сможет ими пользоваться. Сегодня формируются две модели. Первая — частная: технологические гиганты строят огромные кластеры для собственных моделей, продуктов и коммерческих задач. Такая схема позволяет быстро повышать эффективность, но одновременно усиливает концентрацию ресурсов. Университеты, небольшие исследовательские группы и стартапы оказываются зависимыми от интерфейсов, цен и правил, которые устанавливают крупные компании. Вторая модель предполагает превращение вычислительных ресурсов в общедоступную сеть. Именно по этому пути развивается китайский Национальный интернет суперкомпьютеров. Согласно приведённым данным, сеть объединяет более 3,5 млн CPU-ядер, 250 тыс. GPU и насчитывает около 1,4 млн зарегистрированных пользователей. В этой логике вычислительная мощность перестаёт быть изолированным активом отдельных организаций и становится ресурсом, который можно подключать, распределять и использовать по запросу. Этот процесс сравнивают с контейнеризацией мировой торговли. Прорыв обеспечили не только более крупные суда, а единый стандарт контейнеров, позволивший грузам беспрепятственно перемещаться между кораблями, поездами и автомобилями. Аналогично, ИИ-вычисления, научные расчёты и сервисы инференса должны получить возможность работать в единой среде — с совместимыми интерфейсами, планированием задач и распределением ресурсов. На этом фоне особое значение приобретает Sugon 8000 — первый в Китае ИИ-суперкластер на 100 тыс. карт, полностью построенный на отечественной технологической базе. Его роль состоит не только в масштабе. Кластер подключён к ключевому узлу национальной суперкомпьютерной сети и должен обслуживать не одну корпоративную задачу, а широкий набор сценариев: научное моделирование, обучение моделей, инференс и отраслевые решения. Главный экзамен для такого подхода — не пиковая производительность, а реальная общественная эффективность вычислительной инфраструктуры. Важно, сколько ресурсов фактически превращается в научные результаты, модели, промышленные симуляции и доступные сервисы для бизнеса. Создать сеть сравнительно проще, чем обеспечить стабильное распределение нагрузки, совместимость программного обеспечения, защиту данных, понятные механизмы доступа и качественную эксплуатацию. Общественная модель вычислений сложнее частной, поскольку требует стандартов, координации и длительной работы с экосистемой. Но в случае успеха она способна снизить входной барьер в ИИ-разработку. Исследовательской лаборатории, стартапу или независимому разработчику не придётся сначала строить собственный дата-центр, чтобы участвовать в технологической конкуренции: вычислительные ресурсы можно будет получать под конкретную задачу. Таким образом, ключевой вопрос эпохи ИИ — не только в том, насколько велики кластеры. Важнее, превращаются ли они в закрытые «крепости» для ограниченного числа игроков или в инфраструктуру, которая расширяет доступ к инновациям. Именно способ организации вычислительной мощности может стать одним из главных факторов будущего развития ИИ.
ИИ в чрезвычайных ситуациях: сможет ли цифровой человек спастись сам?

Первые эксперименты с генеративными агентами воспринимались скорее как технологическое развлечение. В известном проекте Generative Agents, созданном исследователями Стэнфорда и Google в 2023 году, 25 виртуальных персонажей жили в цифровом городке Smallville: общались, строили планы, распространяли слухи и самостоятельно организовали вечеринку ко Дню святого Валентина. Это показало, что языковые модели способны не только отвечать в чате, но и играть роль автономных участников постоянно меняющегося мира. Однако сегодня исследователи пытаются применять те же идеи в гораздо более серьёзных условиях: при пожарах, землетрясениях, эвакуации из метро, на стадионах и во время массовых мероприятий. Центральный вопрос меняется: важно уже не то, насколько убедительно ИИ изображает человека в обычной социальной жизни, а способен ли он реалистично моделировать человеческое поведение в момент паники и угрозы жизни. Традиционные модели эвакуации в основном опираются на физику движения. Они рассчитывают плотность потока, столкновения, скорость людей и пропускную способность выходов. Но реальная катастрофа редко подчиняется рациональным правилам: люди могут замереть, искать родственников, возвращаться за вещами, не заметить указатель, поддаться панике или следовать за толпой в неверном направлении. Именно такие решения нередко становятся главной причиной жертв. Поэтому новое поколение моделей разделяет симуляцию на два уровня. Физический слой отвечает за движение тел, столкновения и ограничения пространства. Когнитивный слой, основанный на больших языковых моделях, должен имитировать восприятие информации, сомнения, страх, социальное влияние и принятие решений в условиях неопределённости. Иными словами, виртуальной толпе стараются дать не только тела, которые умеют двигаться, но и «разум», который может ошибаться. Несколько исследовательских проектов уже демонстрируют различные подходы. В Университете Карнеги — Меллона создавали модель эвакуации для реальной церемонии вручения дипломов. За 16 месяцев система прошла путь от симуляции ста агентов до моделирования примерно 13 тысяч участников — масштаба реального мероприятия. В результате команда сформулировала практические рекомендации, которые были включены в рабочие процедуры университета. Это важный пример перехода от исследовательского прототипа к применению в управлении рисками. Другой проект, RESCUE, разработанный при участии Тяньцзиньского университета, Кардиффского университета и Университета Цинхуа, сосредоточен на физической достоверности поведения толпы. Система учитывает столкновения частей тела, падения, восстановление после падения и различия между детьми, взрослыми и пожилыми людьми. Цель состоит в том, чтобы симуляция выглядела убедительно не только на уровне маршрутов, но и на уровне реальной телесной динамики в давке. Исследователи Университета Цинхуа развивают подход на уровне целого города. Их платформа AgentSociety моделирует социальную жизнь более чем десяти тысяч агентов и миллионы взаимодействий между ними. Такие системы могут использоваться для анализа реакции города на ураган, распространения экстремистской информации в соцсетях или последствий различных социальных мер. Но чем больше масштаб модели, тем сложнее проверить, отражает ли она реальное коллективное поведение, а не просто создаёт правдоподобную картину. Стэнфордская работа по «цифровым двойникам» пытается измерить достоверность на уровне отдельного человека. Исследователи провели глубокие интервью с более чем тысячей участников, дополнили их анкетами и поведенческими тестами, а затем сравнили ответы людей с ответами их ИИ-двойников. В отдельных задачах точность воспроизведения решений достигала 0,86. Это впечатляющий результат, однако он не доказывает, что тысячи таких агентов вместе смогут корректно предсказать панику, давку или вторичные эффекты массовой эвакуации. Именно здесь возникает главная методологическая проблема. Критики, в том числе исследователи из Амстердамского университета, напоминают: большие языковые модели остаются «чёрными ящиками». Трудно объяснить, почему они дают конкретный ответ, трудно гарантировать одинаковый результат при повторном запуске и трудно проверить их поведение в ситуациях, которые не имеют прямых аналогов в обучающих данных. А чрезвычайные ситуации как раз часто уникальны. Существуют и более конкретные риски. Во-первых, ИИ может чрезмерно усреднять поведение людей, сглаживая редкие, но критически важные реакции — например, иррациональные действия отдельных участников толпы. Во-вторых, высокая точность моделирования отдельного человека не означает точности на уровне большой группы: коллективные эффекты не всегда складываются из индивидуальных. В-третьих, модели специально обучают быть безопасными, вежливыми и предсказуемыми, тогда как в реальной катастрофе люди могут вести себя агрессивно, хаотично и нерационально. В результате симуляция рискует недооценить степень реального беспорядка. Перспективы коммерческого применения очевидны: инструменты для служб безопасности, поведенческие слои для цифровых двойников городов, а также модели оценки рисков для страхового рынка. Но цена ошибки здесь растёт вместе с уровнем доверия к алгоритму. Если неточно настроенная система лишь предложит неидеальный маршрут эвакуации — это одна проблема. Если её выводы начнут влиять на проектирование объектов, планы реагирования или страховые расчёты, последствия могут стать системными. Главный вывод состоит в том, что вопрос об ИИ меняется. Недостаточно спросить, похож ли цифровой агент на человека в обычной беседе или на виртуальной вечеринке. Гораздо важнее понять, будет ли он похож на человека в самые опасные минуты — когда информации не хватает, решения принимаются мгновенно, а страх и поведение толпы меняют ход событий. И прежде чем доверять таким системам реальные решения, необходимо доказать не только их правдоподобность, но и их надёжность.
ИИ в медицине: между надеждой на прорыв и риском нового «Theranos»
Искусственный интеллект всё чаще становится героем историй о почти чудесных медицинских спасениях. В публичном пространстве обсуждают приложения, которые помогают детям с аутизмом общаться, персонализированные мРНК-вакцины для животных с онкологией, лекарства от болезни Альцгеймера, созданные небольшими командами с применением ИИ, и случаи, когда языковые модели якобы помогли выявить ошибочный диагноз. Такие сюжеты вызывают понятный энтузиазм. ИИ действительно способен ускорять обработку данных, поиск биомаркеров, анализ генетических мутаций, проектирование молекул и отбор перспективных гипотез. Особенно привлекательна идея «демократизации» медицины: будто бы отдельный исследователь, стартап или даже технически подкованный энтузиаст сможет с помощью доступных ИИ-инструментов делать то, что прежде требовало ресурсов крупных фармкомпаний. Однако именно здесь возникает риск чрезмерного упрощения. Один из наиболее обсуждаемых примеров — история собаки Рози с опухолью, для которой был создан персонализированный терапевтический подход с использованием ИИ. В популярном изложении это выглядело как случай, когда специалист по машинному обучению самостоятельно разработал мРНК-вакцину, а опухоль после лечения значительно сократилась. Но в реальности терапия включала не только мРНК-компоненты: также использовались препараты, воздействующие на мутацию гена c-KIT, и ингибитор контрольных точек иммунитета PD-1. Поэтому невозможно уверенно утверждать, какой именно элемент лечения стал решающим. Это показывает типичную проблему громких ИИ-медицинских историй: роль алгоритмов нередко описывается более масштабно, чем она была на практике. Во многих случаях ИИ выступает мощным инструментом поиска, анализа и поддержки решений, но не заменяет лабораторную проверку, клинические исследования, производство, контроль качества и медицинскую ответственность. Особую тревогу вызывает перенос привычной для технологического сектора культуры «быстрого роста» в здравоохранение. В Кремниевой долине стартапы часто сначала продают масштабное видение будущего, а уже потом доказывают жизнеспособность продукта. Для программного обеспечения такой подход может быть рискованным, но допустимым. В медицине же цена ошибки значительно выше: речь идёт о здоровье, жизни пациентов и доверии к системе здравоохранения. Именно поэтому авторы материала проводят параллель с Theranos — компанией Элизабет Холмс, обещавшей проводить сотни анализов по одной капле крови. История быстро получила огромную инвестиционную поддержку и оценку в миллиарды долларов, но позднее выяснилось, что заявленная технология не работала так, как утверждалось. Этот случай стал символом того, что яркий рассказ, медийность и вера инвесторов не могут заменить научную верификацию. В эпоху ИИ опасность может усилиться. Технологии позволяют одному человеку быстро создать убедительный сайт, виртуальную команду, маркетинговые материалы, презентацию для инвесторов и даже видимость медицинского сервиса. В качестве примера так же приводится стартап Medvi, вокруг которого возникли обвинения в недостоверном маркетинге, фиктивных кейсах и сомнительных заявлениях. Даже если подобные истории касаются лишь рекламы и привлечения клиентов, они демонстрируют, насколько легко ИИ-инструменты могут использоваться для создания иллюзии компетентности. Проблема касается и самого ИИ-рынка. Гонка за оценками моделей, быстрыми релизами и вниманием инвесторов может поощрять не фундаментальные исследования, а эффектные заявления. В условиях, когда модели всё чаще похожи друг на друга по возможностям, конкуренция смещается в область маркетинга, громких цифр и вирусных историй. Это особенно опасно, если подобный стиль начинает определять повестку в фармацевтике и биотехнологиях. ИИ способен изменить медицину: помочь находить новые лекарственные мишени, точнее подбирать лечение, ускорять анализ исследований и снижать стоимость отдельных этапов разработки. Но его польза должна подтверждаться воспроизводимыми результатами, независимой экспертизой, прозрачными данными и клиническими испытаниями. Медицинские «чудеса» не стоит автоматически считать обманом. Но и принимать их за доказательство революции преждевременно. В области, где последствия ошибок могут быть необратимыми, главными критериями должны оставаться не убедительность истории и не размер инвестиций, а качество доказательств, безопасность и проверяемый результат.
AI-разработка приложений: быстрый запуск не отсутствие ответственности
За последний год ИИ-программирование стало одним из самых заметных технологических трендов. Концепция vibe coding обещает, что приложение сможет создать почти любой человек: достаточно описать идею обычным языком, а ИИ сгенерирует интерфейс, подключит базу данных и поможет развернуть проект. Это резко снижает стоимость экспериментов и делает разработку доступнее. Но вместе с этим растёт и число рисков. Главная проблема заключается в том, что ИИ облегчает создание работающего прототипа, но не делает его автоматически безопасным, надёжным и готовым к реальной эксплуатации. Показательным примером стал Moltbook — социальный сервис для ИИ-агентов, созданный практически полностью с помощью ИИ. Исследователи безопасности обнаружили, что из-за неверной настройки базы данных Supabase производственная среда оказалась открыта для полного чтения и записи. В публичном доступе, по сообщениям исследователей, находились около 1,5 млн API-токенов, десятки тысяч адресов электронной почты и приватные сообщения между агентами. Посторонний человек мог выдавать себя за аккаунты агентов и изменять содержимое платформы. Эта история важна не сама по себе. Она показывает, что современное приложение — это не только красивый интерфейс и работающие кнопки. За внешней частью находятся менее заметные, но критически важные компоненты: аутентификация, разграничение прав доступа, защита ключей, настройка базы данных, журналирование, обновления зависимостей, защита от атак и план сопровождения. ИИ способен быстро написать код для формы входа или подключения к базе данных. Но он не гарантирует, что доступ ограничен корректно, что секреты не попали в репозиторий, а пользователи не видят чужие данные. Особенно опасна психологическая ловушка: если приложение запускается и выглядит профессионально, создателю легко решить, что оно уже готово к использованию. На практике работающий демо-продукт может быть лишь внешне убедительным прототипом с серьёзными уязвимостями. Исследователи RedAccess нашли сотни тысяч публично доступных активов, среди которых тысячи содержали чувствительную корпоративную информацию: медицинские записи, финансовые данные, внутренние документы и переписку службы поддержки. Подобные риски затрагивают приложения, созданные или развёрнутые через платформы ИИ- и low-code-разработки. Если настройки приватности по умолчанию слишком открыты, неопытный пользователь может даже не понять, что опубликовал данные в интернете. Особенность новой эпохи заключается в том, что опаснее всего может быть не полный провал проекта, а его «частичный успех». Если приложение никто не использует, оно остаётся заброшенным экспериментом. Но если оно привлекает хотя бы небольшую аудиторию, начинает собирать персональные данные, подключать внешние сервисы и хранить токены доступа, то превращается в объект ответственности. Так появляются «зомби-приложения»: сервисы, которые больше не развиваются, но продолжают работать. Их базы данных остаются доступными, ключи не меняются, зависимости не обновляются, а владельцы давно перестали следить за инфраструктурой. В отличие от старого заброшенного сайта, такое приложение может хранить реальные пользовательские данные и открытые API-интерфейсы. Проблема не сводится к ошибкам отдельных авторов. Платформы, продвигающие идею «разработка без технических знаний», также должны брать на себя часть ответственности. Если сервис обещает, что пользователь может создать приложение без понимания инженерных деталей, нельзя перекладывать на него всю ответственность за сложную модель прав доступа. Более безопасный подход включает приватные настройки по умолчанию, автоматическую проверку утечек ключей, предупреждения перед публикацией, сканирование конфигураций и понятные механизмы удаления данных при закрытии проекта. Кроме безопасности, остаются юридические и этические вопросы: происхождение сгенерированного кода, соблюдение лицензий с открытым исходным кодом, правила обработки персональных данных сторонними ИИ-сервисами и распределение ответственности при инцидентах. Таким образом, риск vibe coding — это не только уязвимости, но и вопрос о том, откуда взят код, где оказываются данные и кто отвечает за последствия. ИИ-разработка не делает создание программного обеспечения бессмысленным или опасным по своей природе. Напротив, она позволяет быстрее проверять идеи, делать нишевые продукты и давать небольшим командам возможности, которые прежде были доступны только крупным компаниям. Но настоящий профессионализм теперь всё меньше определяется умением быстро сгенерировать экран или подключить API. Новая ценность — способность довести прототип до ответственного продукта: понять чувствительность данных, ограничить доступ, обеспечить сопровождение, закрыть ненужные интерфейсы, вовремя удалить информацию и предупредить пользователей при остановке сервиса. ИИ сократил сложность старта, но не отменил сложность эксплуатации. Она просто переместилась в менее заметные области — настройки прав, базы данных, ключи доступа и забытые облачные сервисы. Поэтому главный навык эпохи ИИ-разработки — не просто умение быстро создать приложение, а умение безопасно выпустить его в реальный мир.
Зачем технологическим компаниям нужны гуманитарии
По мере стремительного развития искусственного интеллекта все острее встаёт вопрос: способны ли технологические компании учитывать не только технические, но и этические, политические и социальные последствия своих разработок? Ответ на него пытается найти философ Иасон Габриэль — один из ведущих специалистов по этике ИИ в Google DeepMind. Габриэль пришел в DeepMind в 2017 году, когда идея искусственного интеллекта общего назначения (AGI) еще воспринималась многими как слишком далекая перспектива. Имея образование в области политической философии и опыт работы в международных гуманитарных проектах, он стал одним из первых философов, работающих непосредственно в одной из ведущих лабораторий по созданию ИИ. По мнению Габриэля, главная задача заключается не только в том, чтобы сделать искусственный интеллект безопасным, но и определить, каким человеческим ценностям он должен следовать. Он отмечает, что современное общество не обладает единой системой моральных принципов, поэтому вопрос «какие ценности должен разделять ИИ?» гораздо сложнее, чем может показаться. Эта позиция помогает преодолеть противоречие между двумя основными направлениями исследований. Представители AI Safety сосредоточены на предотвращении рисков появления сверхразумного ИИ, тогда как специалисты по AI Ethics уделяют больше внимания уже существующим проблемам — алгоритмической дискриминации, прозрачности решений, защите прав пользователей и влиянию технологий на общество. Габриэль считает, что эти подходы должны дополнять друг друга, а не конкурировать. После появления больших языковых моделей философ уделил особое внимание феномену антропоморфизации. Современные чат-боты настолько убедительно ведут диалог, что пользователи начинают воспринимать их как полноценных собеседников. Это может приводить к чрезмерному доверию, эмоциональной зависимости и ошибочному восприятию ИИ как личности. По этой причине DeepMind стремится разрабатывать модели, которые не создают иллюзию человеческой природы и не поощряют подобное восприятие. Еще одним важным направлением работы стала разработка новой концепции выравнивания (alignment). Вместо традиционного понимания, при котором ИИ должен просто следовать заданным инструкциям, команда Габриэля предлагает учитывать интересы сразу четырех сторон: пользователя, разработчика, самой системы и общества в целом. Такой подход позволяет более полно оценивать возможные последствия решений, принимаемых искусственным интеллектом. По мере приближения эпохи AGI круг обсуждаемых вопросов становится значительно шире. Исследователи анализируют влияние ИИ на экономику, рынок труда, политику, международные отношения и научный прогресс. При этом сама отрасль развивается в условиях жесткой конкуренции между крупнейшими технологическими компаниями и государствами, что существенно усложняет внедрение принципов ответственного развития. Несмотря на растущее коммерческое давление, Габриэль сохраняет осторожный оптимизм. Он считает, что искусственный интеллект способен ускорить научные открытия, помочь в борьбе с тяжелыми заболеваниями и повысить благосостояние общества. Однако позитивный сценарий возможен лишь в том случае, если человечество сумеет справедливо распределить преимущества новых технологий, минимизировать риски и сохранить контроль над их использованием. По мнению философа, искусственный интеллект уже перестал быть исключительно инженерной задачей. Сегодня он заставляет заново осмысливать вопросы, которыми философия занимается на протяжении тысячелетий: что такое разум, сознание, ответственность и, в конечном счете, что значит быть человеком. Именно поэтому гуманитарные науки становятся важной частью разработки технологий будущего.
Вокруг ИИ формируется новая модель бизнеса: вместо продажи курсов — создание сообществ

Рынок искусственного интеллекта постепенно меняется. Если еще недавно главным способом заработка были онлайн-курсы по работе с ИИ, то сегодня все большую роль начинают играть профессиональные сообщества, объединяющие людей вокруг совместного обучения, обмена опытом и практических проектов. Прежняя модель, основанная на продаже обучающих курсов, теряет эффективность. Благодаря современным языковым моделям базовые знания об ИИ стали гораздо доступнее: многие вопросы можно решить, просто обратившись к самому ChatGPT или другим аналогичным сервисам. В результате ценность готовых видеокурсов постепенно снижается. При этом исчезает не сама потребность пользователей, а ее характер. Если раньше люди переживали из-за нехватки информации, то теперь их больше волнует другое: как подтвердить свои реальные навыки работы с ИИ и выделиться среди множества специалистов. На этом фоне начинают активно развиваться крупные AI-сообщества. Среди наиболее известных китайских примеров называют WaytoAGI, Datawhale, LangGPT и Founder Park. Их объединяет не продажа знаний, а создание среды, где участники вместе реализуют проекты, проводят встречи, делятся разработками и помогают друг другу профессионально расти. Особенность таких сообществ заключается в том, что они становятся своеобразной системой неформальной сертификации. Репутация участника строится не на дипломах или сертификатах, а на его открытых проектах, вкладе в развитие сообщества и практических результатах. Для компаний именно такая репутация может оказаться более ценной, чем традиционные документы об обучении. Авторы также считают, что подобные сообщества становятся важными партнерами для крупных технологических компаний. Производители ИИ-моделей заинтересованы в активных пользователях, которые тестируют новые инструменты, создают собственные решения и формируют вокруг технологий устойчивую экосистему. Вместе с тем популярность подобных объединений привела к появлению большого количества недобросовестных проектов. Под видом закрытых клубов или «элитных школ» некоторые организации предлагают дорогостоящие программы обучения, обещая быстрый карьерный рост и эксклюзивные знания. Рекомендую с осторожностью относиться к подобным предложениям и обращать внимание на несколько признаков: открытость материалов, прозрачную модель монетизации, возможность свободной критики внутри сообщества и реальные достижения его участников. По мнению авторов, в эпоху, когда сами знания становятся все более доступными благодаря ИИ, главным ресурсом становится способность объединять людей, организовывать совместную работу и формировать профессиональную репутацию. Именно поэтому будущее рынка AI-образования может принадлежать не продавцам курсов, а создателям сильных экспертных сообществ.
OpenAI представила GPT-Live: голосовой ChatGPT стал ещё ближе к живому общению

OpenAI анонсировала GPT-Live — новое поколение голосового взаимодействия с ChatGPT, которое делает разговор с искусственным интеллектом более естественным и похожим на общение с человеком. Новая технология уже начинает постепенно становиться доступной пользователям по всему миру. Главное отличие GPT-Live заключается в использовании полнодуплексной архитектуры. В отличие от предыдущих голосовых систем, которые ожидали окончания реплики пользователя, новая модель способна одновременно слушать и говорить. Она может короткими репликами вроде «угу» или «понятно» показывать, что внимательно слушает собеседника, не перебивая его без необходимости, а также выдерживать паузы, если человеку требуется время, чтобы сформулировать мысль. Еще одной важной особенностью стала возможность делегировать сложные задачи другим моделям OpenAI. Если во время разговора требуется выполнить веб-поиск, провести глубокий анализ или сложные рассуждения, GPT-Live передает эту работу модели GPT-5.5, продолжая при этом поддерживать диалог. Такой подход позволяет сохранить плавность общения, не заставляя пользователя ждать завершения обработки запроса. По данным OpenAI, GPT-Live превосходит предыдущий режим Advanced Voice Mode по качеству диалога. В ходе тестирования пользователи чаще отдавали предпочтение новой системе благодаря более естественному темпу общения, меньшему количеству неуместных перебиваний и более плавным переходам между репликами. Кроме того, модель показала улучшенные результаты в задачах научного рассуждения, веб-поиска и ведения сложных многоэтапных диалогов. Обновленный голосовой ChatGPT также получил улучшенное распознавание речи в шумной обстановке, возможность выбирать уровень глубины рассуждений (Instant, Medium или High) и поддержку визуальных карточек с информацией о погоде, акциях, спортивных событиях и других темах прямо во время голосового разговора. GPT-Live постепенно становится доступен пользователям ChatGPT на iOS, Android и через веб-версию ChatGPT. Для подписчиков Go, Plus и Pro модель GPT-Live-1 станет голосовой моделью по умолчанию, тогда как бесплатные пользователи получат облегченный вариант GPT-Live-1 mini. По мнению OpenAI, GPT-Live знаменует новый этап развития голосовых интерфейсов, делая взаимодействие с искусственным интеллектом более естественным, комфортным и удобным для повседневного использования.
Bun за 11 дней переписали с Zig на Rust с помощью Claude: один из крупнейших AI-проектов в разработке ПО

Создатель JavaScript-рантайма Bun Джарред Самнер рассказал подробности одного из самых масштабных проектов по автоматизированной переработке кода с использованием искусственного интеллекта. Всего за 11 дней команда перевела проект с языка Zig на Rust, задействовав Claude Code и десятки параллельно работающих ИИ-агентов. До миграции Bun насчитывал более 535 тысяч строк кода на Zig и около 20% компонентов на C++. В ходе переписывания было изменено свыше миллиона строк кода, выполнено почти 6800 коммитов и использовано около 50 динамических рабочих процессов с участием Claude. По оценке Самнера, если бы аналогичную работу выполняли три опытных инженера вручную, она заняла бы около года. Стоимость использования API Claude составила примерно 165 тысяч долларов. При этом основатель Bun считает, что затраты оправданы, поскольку проект удалось завершить значительно быстрее без остановки развития продукта. Одной из главных причин перехода на Rust стали проблемы с управлением памятью. В предыдущих версиях Bun сочетание автоматической сборки мусора JavaScript и ручного управления памятью в Zig приводило к утечкам памяти и трудноуловимым ошибкам. Например, после 2000 последовательных операций сборки приложение могло потреблять до 6,7 ГБ памяти. После перехода на Rust этот показатель снизился примерно до 609 МБ. Новая версия Bun также принесла и другие улучшения. Разработчики устранили более 120 известных ошибок, уменьшили размер исполняемых файлов примерно на 20% и получили прирост производительности в большинстве сценариев на 2–5%. В некоторых задачах, включая запуск HTTP-сервера и сборку проектов, скорость работы также заметно выросла. Особый интерес представляет сама организация процесса разработки. Вместо одного ИИ Самнер использовал систему из множества специализированных агентов. Одни экземпляры Claude занимались написанием кода, другие независимо проверяли изменения, исходя из предположения, что в них могут быть ошибки. В пиковые моменты одновременно работали до 64 экземпляров Claude, распределенных по нескольким рабочим веткам. Несмотря на успешную миграцию, разработчики признают, что работа еще далека от завершения. В кодовой базе остается около 13 тысяч участков, использующих конструкцию unsafe, а после переписывания были обнаружены новые регрессии и ошибки, связанные с различиями между Zig и Rust. Кроме того, столь масштабные изменения практически невозможно полностью проверить вручную — большую часть ревью также выполняли ИИ-инструменты. Проект вызвал активные дискуссии в сообществе разработчиков. Одни считают его убедительным примером того, как ИИ способен многократно ускорить разработку сложного программного обеспечения. Другие обращают внимание на долгосрочные риски: поддержка огромной кодовой базы, созданной преимущественно искусственным интеллектом, может оказаться значительно сложнее, чем ее первоначальная генерация. Тем не менее история Bun уже стала одним из самых заметных примеров применения генеративного ИИ для масштабной переработки промышленного программного обеспечения и демонстрирует, насколько быстро меняются подходы к разработке современных технологий.
Сильный AI требует не лучших запросов, а более ясного мышления
С появлением новых поколений языковых моделей, таких как Claude Fable 5, становится очевидно: разницу в результатах все чаще определяет не сам искусственный интеллект, а то, насколько человек умеет с ним взаимодействовать. В сети регулярно появляются необычные примеры использования Fable 5: от интерактивного «магического дневника» в стиле «Гарри Поттера» до запуска классических компьютерных игр на мобильных устройствах и создания анимированных ASCII-автопортретов. Во многих случаях авторы проектов используют не одну удачную подсказку (prompt), а десятки итераций, постоянно уточняя идеи и проверяя гипотезы. Главная проблема сегодня заключается уже не в недостатке возможностей ИИ, а в том, что сами пользователи не всегда ясно понимают собственные требования. Они ссылаются на известный принцип «карта — не территория»: любое текстовое описание задачи представляет собой лишь упрощенную модель реальной ситуации. Во время выполнения проекта неизбежно возникают детали и ограничения, которые невозможно полностью предусмотреть заранее. Поэтому вместо стремления написать идеальный запрос предлагается другой подход — помогать искусственному интеллекту выявлять «неизвестные неизвестности», то есть аспекты задачи, о которых пользователь сам еще не задумался. Для этого рекомендуется начинать работу с небольших прототипов, нескольких вариантов дизайна или предварительных демонстрационных решений. Такой способ позволяет быстро увидеть, что действительно соответствует ожиданиям, а что требует пересмотра. Еще одна рекомендация — превратить AI в собеседника, который задает уточняющие вопросы. Вместо того чтобы сразу приступать к реализации проекта, модель может последовательно выяснять ключевые решения, влияющие на архитектуру системы, пользовательский интерфейс или структуру данных. Это помогает сформулировать требования значительно точнее. Во время длительной работы над проектом авторы советуют поручать модели вести журнал принятых решений. Если AI вынужден отклониться от первоначального плана, он должен фиксировать причины изменений и возможные риски. Такой подход делает процесс разработки более прозрачным и позволяет человеку сохранять контроль над результатом. Интересной выглядит и идея использовать искусственный интеллект в роли экзаменатора. После завершения проекта модель может подготовить отчет о внесенных изменениях и составить вопросы, проверяющие понимание проделанной работы. Это позволяет убедиться, что разработчик действительно разобрался в полученном результате, а не просто принял предложенные AI изменения. Современные модели становятся настолько мощными, что основным ограничением оказывается уже не их способность писать код или создавать контент, а умение человека правильно формулировать задачи, замечать пробелы в собственных знаниях и постоянно проверять свои гипотезы. По мере развития искусственного интеллекта именно эти навыки, вероятно, будут все сильнее определять эффективность работы с новыми технологиями.