
Пока все говорят об увольнениях из-за ИИ, Microsoft, ByteDance и Ford массово нанимают специалистов

В последние годы искусственный интеллект чаще всего обсуждают в контексте сокращения рабочих мест. Однако практика крупнейших мировых компаний показывает более сложную картину. Microsoft инвестирует миллиарды долларов в создание новых инженерных команд, ByteDance и Alibaba предлагают высокие зарплаты новым специалистам по внедрению ИИ, а Ford возвращает опытных инженеров, которых ранее заменили автоматизированными системами. Все это говорит о том, что развитие искусственного интеллекта не столько устраняет потребность в людях, сколько создает новые профессии. Одной из самых заметных инициатив стало создание Microsoft подразделения Frontier Company. По данным китайских СМИ, корпорация выделяет около 2,5 млрд долларов на развитие нового направления и формирует команду примерно из 6 тысяч инженеров, технических консультантов и специалистов по продажам. Их задача — работать непосредственно в компаниях-клиентах, помогая внедрять ИИ в реальные бизнес-процессы. Президент коммерческого подразделения Microsoft Джадсон Альтхофф ранее признал, что первоначальная стратегия продвижения Copilot оказалась слишком простой: предполагалось, что компании смогут самостоятельно внедрять готовый продукт. На практике выяснилось обратное. Большинство корпоративных клиентов сталкиваются с вопросами: какие данные можно использовать для обучения; как интегрировать ИИ со старыми корпоративными системами; какие процессы действительно стоит автоматизировать; как оценить экономический эффект. Поэтому Microsoft фактически переходит от модели продажи программного обеспечения к модели сопровождения внедрения. Аналогичную стратегию реализуют и китайские технологические компании. ByteDance активно набирает специалистов Frontline Deployment Engineer (FDE) с зарплатой до миллиона юаней в год. Alibaba Cloud также расширяет штат подобных сотрудников. Главная задача FDE — не разработка программного обеспечения, а работа на стыке технологий и бизнеса. Такой специалист должен одновременно понимать: архитектуру ИИ-систем; особенности инфраструктуры заказчика; бизнес-процессы компании; требования конкретного подразделения. Фактически он становится переводчиком между инженерами и бизнесом. По данным LinkedIn, количество вакансий для специалистов такого профиля с 2023 по 2025 год выросло значительно быстрее, чем число вакансий для классических AI-инженеров. Тенденция выходит далеко за пределы Microsoft. Сообщается, что Amazon Web Services также инвестирует около 1 млрд долларов в развитие инженерных команд, работающих непосредственно с корпоративными заказчиками. Подобные подразделения создают OpenAI и Anthropic. Причина очевидна: многие компании готовы платить не только за доступ к модели, но и за специалистов, способных встроить ее в существующие бизнес-процессы. Во многих случаях именно услуги по внедрению становятся более ценным продуктом, чем сама лицензия на использование ИИ. Другим показательным примером стала автомобильная компания Ford. После внедрения систем автоматизированного проектирования на базе искусственного интеллекта компания столкнулась с ухудшением качества продукции. По словам руководителя подразделения Чарльза Пуна, руководство переоценило возможности ИИ и ошибочно предположило, что автоматизация сама по себе обеспечит высокое качество инженерных решений. В результате Ford вернула более 350 опытных инженеров, ранее покинувших компанию. Кроме того, производитель расширил подразделения контроля качества и автоматизированного тестирования. Компания не отказалась от использования искусственного интеллекта, но изменила подход. Выяснилось, что многие инженерные знания существуют только в опыте специалистов и никогда не были формализованы в документации. Например, опытный инженер может знать, почему определенный сварной шов следует усилить, хотя в технической документации это не указано. Такие знания практически невозможно автоматически передать модели. Исследования Deloitte показывают, что большинство производственных предприятий пока не получили ожидаемого эффекта от внедрения искусственного интеллекта. Главная причина заключается не в качестве моделей. Компании сталкиваются с гораздо более сложными задачами: очисткой и подготовкой данных; интеграцией с устаревшими информационными системами; изменением внутренних процессов; обучением сотрудников; настройкой рабочих сценариев. Сам по себе доступ к ИИ не решает этих проблем. Можно сравнить ситуацию с покупкой многофункционального инструмента: наличие самого инструмента еще не означает, что его смогут эффективно использовать. Сегодня многие организации стараются сократить расходы на использование дорогих языковых моделей, переходя на более доступные версии. Однако экономия на вычислительных ресурсах не устраняет другую статью затрат — работу специалистов по внедрению. Полная стоимость корпоративного ИИ складывается не только из расходов на токены или вычисления. Не менее значимыми становятся: консультации; интеграция; сопровождение; обучение персонала; адаптация процессов. Во многих случаях именно эти расходы оказываются определяющими. Эксперты считают, что по мере развития искусственного интеллекта часть стандартных задач действительно будет полностью автоматизирована. Однако корпоративная среда значительно сложнее типовых сценариев. Практически каждая крупная компания использует собственные информационные системы, внутренние регламенты и накопленный за годы опыт, который невозможно полностью описать в документации. Именно поэтому появляются новые профессии. Если раньше специалисты выполняли работу самостоятельно, то теперь все чаще они становятся посредниками между ИИ и реальными бизнес-процессами. Их задача — правильно сформулировать задачу, проверить результат, адаптировать систему и контролировать качество работы моделей. Истории Microsoft, ByteDance и Ford демонстрируют одну общую тенденцию. Современный рынок корпоративного искусственного интеллекта постепенно смещается от продажи технологий к продаже компетенций. Доступ к модели становится лишь отправной точкой. Настоящую ценность создают специалисты, способные превратить возможности искусственного интеллекта в работающий инструмент конкретного бизнеса. Поэтому, несмотря на разговоры о массовом вытеснении людей, крупнейшие технологические компании продолжают активно нанимать сотрудников. Только теперь они ищут не столько разработчиков моделей, сколько тех, кто способен соединить искусственный интеллект с реальными производственными и бизнес-процессами.
Как ИИ становится главным «пользователем» сети

Еще несколько лет назад проверка «Докажите, что вы человек» была простой формальностью. Сегодня CAPTCHA становятся все сложнее: нужно распознавать плохо различимые объекты, вращать изображения или выполнять задания, которые иногда вызывают затруднения даже у людей. Причина проста: интернет стремительно меняется. По данным Cloudflare, в июне 2026 года впервые в истории большинство веб-запросов к сайтам поступило не от людей, а от автоматизированных систем и ИИ. Это событие может стать одной из самых важных вех в эволюции сети. Согласно статистике Cloudflare, около 57,4% всех запросов к сайтам, обслуживаемым компанией, сегодня создают автоматизированные программы и системы искусственного интеллекта. На долю реальных пользователей приходится лишь 42,6%. Одновременно меняется и сам контент. Исследование Graphite показывает, что уже в мае 2025 года более половины интернет-контента создавалось при помощи ИИ. По данным Reuters Institute, к 2026 году около 71% изображений в социальных сетях являются полностью сгенерированными искусственным интеллектом. Иными словами, машины не только посещают интернет чаще людей — они все активнее наполняют его собственным содержанием. Когда речь заходит о «машинном трафике», многие представляют хакеров, спам или вредоносное программное обеспечение. Однако сегодня основной источник автоматических запросов совершенно иной. Прежде всего это системы обучения и работы современных языковых моделей. Для обучения GPT, Claude, Llama и других моделей требуется огромный объем данных. Компании регулярно сканируют открытые сайты, блоги, форумы и базы знаний, чтобы получать новые материалы для обучения и обновления моделей. Но этим машинная активность не ограничивается. Современные ИИ все чаще самостоятельно ищут информацию в интернете во время работы. Когда пользователь задает вопрос, модель может обращаться к различным сайтам, анализировать найденные материалы и формировать итоговый ответ. Все эти обращения также становятся частью машинного трафика. Таким образом, интернет активно используется как на этапе обучения моделей, так и во время их повседневной эксплуатации. Еще один источник роста автоматического трафика — AI-агенты. Раньше человек самостоятельно открывал сайты, сравнивал товары, покупал билеты или заполнял формы. Теперь все чаще эти действия выполняют интеллектуальные помощники. Пользователь лишь ставит задачу: найти лучший авиабилет; сравнить цены; заказать товар; подобрать гостиницу. Все остальные действия выполняет агент. Для владельца сайта выглядит так, будто страницу посетил робот, хотя конечным инициатором остается человек. По мере распространения подобных систем объем машинного трафика продолжает стремительно увеличиваться. Наряду с современными ИИ продолжают активно работать и традиционные автоматизированные системы. Это многочисленные: фермы аккаунтов; автоматические комментаторы; системы накрутки лайков; программы публикации отзывов; боты для социальных сетей. Во многих случаях значительная часть активности вокруг популярных публикаций может формироваться именно такими автоматизированными аккаунтами. В совокупности с ИИ они делают машины крупнейшими участниками интернет-трафика. На первый взгляд может показаться, что люди просто стали реже заходить в сеть. На самом деле происходит обратное. Среднее время пребывания пользователей в интернете продолжает расти и уже превышает семь часов в день. Изменилось другое. Раньше поиск информации выглядел так: открыть поисковую систему; просмотреть несколько сайтов; перейти по ссылкам; прочитать материалы. Теперь многие просто задают вопрос ИИ. Пользователь отправляет один запрос и получает готовый ответ, собранный сразу из множества источников. Все промежуточные действия — поиск, открытие страниц, анализ информации — выполняет уже сама модель. В результате человеческих запросов становится меньше, а машинных — значительно больше. Еще одна причина статистических изменений — трансформация самой сети. Двадцать лет назад большинство информации находилось на открытых веб-сайтах. Сегодня значительная часть активности переместилась внутрь крупных приложений и экосистем. Общение происходит в мессенджерах, просмотр контента — внутри социальных платформ, покупки — в мобильных приложениях. Такая активность значительно хуже отражается в классической веб-статистике. Поэтому часть человеческого присутствия оказывается менее заметной, тогда как автоматические обращения к открытым сайтам продолжают активно расти. Рост машинного трафика создает серьезные проблемы для рекламной модели, на которой десятилетиями строился интернет. Реклама эффективна тогда, когда ее видят потенциальные покупатели. Однако: ИИ не покупает товары; поисковые боты не нажимают на рекламу; автоматические программы не становятся клиентами компаний. При этом они потребляют вычислительные ресурсы, используют пропускную способность серверов и увеличивают расходы владельцев сайтов. По оценке Всемирной федерации рекламодателей (WFA), ежегодные потери рекламной индустрии от недействительного трафика уже превышают десятки миллиардов долларов. Еще более серьёзной проблемой становится массовое распространение автоматически созданного контента. Сегодня уже существуют полностью автоматизированные схемы работы: ИИ пишет статью; другой ИИ генерирует изображения; следующий публикует материал; затем автоматически создаются комментарии; специальные боты ставят лайки и отвечают друг другу. В результате появляются страницы, где практически нет участия человека. Но особую тревогу вызывает другой эффект. Если новые модели начинают обучаться на текстах, ранее созданных другими моделями, возникает замкнутый цикл. ИИ перестаёт учиться на реальном человеческом опыте и начинает воспроизводить знания, которые ранее сгенерировал сам искусственный интеллект. Эксперты опасаются, что подобный процесс может привести к снижению качества моделей и постепенной унификации контента. Все это меняет отношение пользователей к информации. Становится сложнее понять: кто написал текст; действительно ли фотография настоящая; обсуждают ли люди тему или между собой общаются автоматические аккаунты; существует ли человек по другую сторону экрана. Такая неопределенность уже приводит к новым явлениям — от массовых попыток выявлять контент, созданный ИИ, до случаев мошенничества с использованием полностью сгенерированных рекламных роликов. Интернет постепенно превращается в пространство, где люди и машины существуют одновременно, но отличить одних от других становится все сложнее. Авторы материала считают, что одним из ключевых направлений станет обязательная идентификация контента и действий, созданных искусственным интеллектом. В разных странах уже появляются соответствующие инициативы. Например, европейский Закон об искусственном интеллекте (AI Act) предусматривает маркировку синтетического контента, а китайские правила требуют обозначать материалы, созданные генеративными моделями. Однако одних технологий недостаточно. По мере распространения ИИ пользователям придётся внимательнее относиться к любой информации в сети, перепроверять источники и сохранять критическое мышление. Именно человеческие качества — эмоции, индивидуальный опыт, способность сомневаться, ошибаться и творить — могут стать тем, что будет отличать людей в мире, где значительную часть цифрового пространства уже занимают машины. История интернета вступает в новый этап. Если раньше сеть была прежде всего местом общения людей, то теперь она постепенно становится общей средой для людей и искусственного интеллекта. И главным вызовом ближайших лет станет не борьба с ИИ, а поиск новых правил сосуществования, при которых технологии будут развиваться, не вытесняя человеческое присутствие из цифрового мира.
Железо — это скелет, ИИ — душа, а данные — то, что делает их единым целым
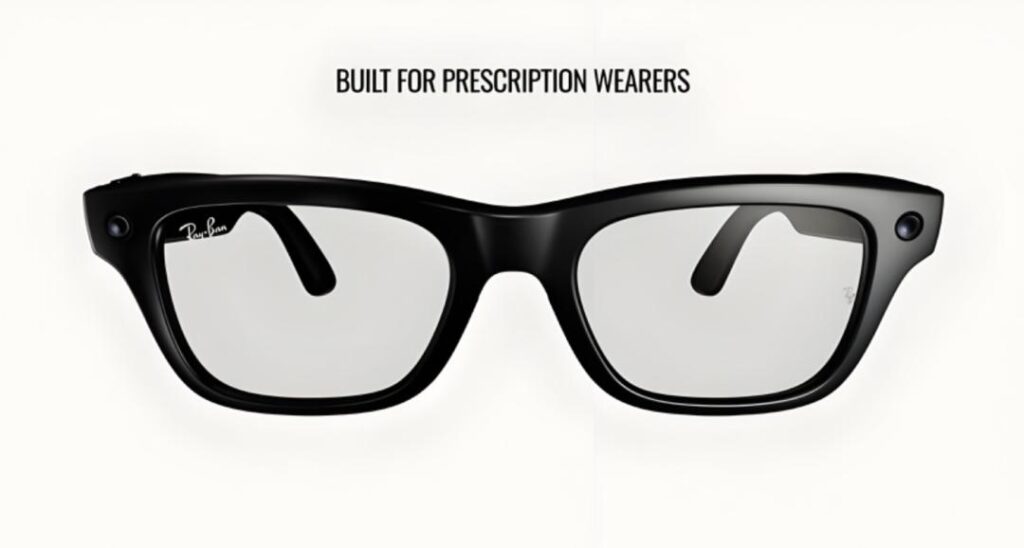
В последние два года дискуссии о носимых устройствах с искусственным интеллектом сводятся к вопросу: это ИИ-компании начали делать гаджеты или производители «железа» стали внедрять ИИ? Но настоящий сдвиг лежит глубже. Как отмечает профильное сообщество «Embodied Study», мы наблюдаем встречное движение: ИИ ищет «тело», чтобы выйти в реальный мир, а аппаратное обеспечение ищет «будущее», чтобы не превратиться в дешевеющий товар с низкой маржой. Точкой их встречи становятся данные — те самые сигналы из физического мира, которые раньше невозможно было оцифровать. До сих пор большие языковые модели (LLM) питались данными из интернета: текстами, кодом, форумами и оцифрованными книгами. Однако эксперты Epoch AI прогнозируют, что к 2030 году ИИ исчерпает запасы качественных публичных текстов. Будущее ИИ — в данных, которые находятся вне сети: в том, что мы говорим, слышим, видим и как меняется наше тело в реальном времени. ИИ-революция в аппаратном обеспечении мотивирована именно этим: поиском новых «залежей» данных. Разница между «я чувствую, что поправился» (просто фраза для чат-бота) и ежедневно обновляемым графиком веса, мышечной массы и процента жира с умных весов огромна. Первое — это консультация, второе — непрерывное управление здоровьем. Пример с умными весами Ant Group «Afu» показателен: компания предложила устройство практически бесплатно (за символическую сумму после возврата кэшбэка). Зачем? Чтобы превратить пользователя из случайного консультанта в объект постоянной калибровки. Каждое взвешивание — это возврат данных, который дает ИИ повод отправить новое уведомление, совет по питанию или тренировке, удерживая пользователя в экосистеме. Производители оборудования находятся в кризисе перепроизводства. Спецификации быстро сравниваются, цены падают, а после продажи устройства история отношений с клиентом заканчивается. ИИ предлагает выход: превратить гаджет из одноразовой покупки в инструмент подписки и формирования «долгосрочной памяти». Здесь выделяются два пути: Создание личной привязанности и контекста. Устройства вроде AI-компаньонов для детей или «умных» мягких игрушек Fuzozo делают ставку на память и характер. Если у игрушки есть история общения с ребенком, ее сложнее заменить новой моделью. Данные о росте и обучении ребенка становятся активом, который удерживает клиента. Формирование уникальных датасетов. Устройства, записывающие звук и видео от первого лица (например, очки Ray-Ban или диктофоны Plaud), собирают данные о том, как люди взаимодействуют с физическим миром. Разработчик Plaud уже отгрузил более 2 миллионов устройств, а его годовая выручка от подписки на сервисы расшифровки и суммаризации (ARR) превысила 100 млн долларов. Для таких компаний данные первого лица — это «корпус физического мира», который дороже самого устройства. В этой новой парадигме аппаратное обеспечение становится лишь «фронтенд-офисом» для сбора данных. Истинная ценность перемещается от сенсоров и моделей к цепочке «данные — сервис». Железо собирает частные данные. Данные обучают модель. Модель делает сервис персонализированным. Персонализация удерживает пользователя и генерирует новые данные. Однако у этого маховика есть и обратная сторона — доверие и конфиденциальность. Регуляторы уже внимательно следят за тем, как данные с носимых устройств (например, Fitbit) используются в рекламных целях. AI-железо работает на границе личного пространства клиента: оно слышит совещания, видит семейные сцены и знает показатели организма. Если доверие будет подорвано или облачный сервис отключится (как это случилось с Humane AI Pin после проблем с бизнесом компании), дорогой гаджет мгновенно превращается в бесполезный кусок пластика. Победу одержат не те, кто первыми встроят ChatGPT в очки, а те, кто быстрее и безопаснее настроит цикл возврата данных из реального мира. Если маховик данных не раскрутится, ИИ так и останется «гением, запертым в комнате» текстового ввода, а гаджеты — лишь красивыми пустышками в технологической глазури. Настоящая борьба разворачивается за то, кто станет владельцем непрерывного потока данных о жизни пользователя. Железо здесь — лишь скелет, который должен обрасти «плотью» из информации, чтобы душа ИИ обрела истинную силу.
В коде Codex обнаружены упоминания GPT-5.6, релиз может состояться уже на следующей неделе

В сети появились новые слухи о скором выпуске GPT-5.6. Как сообщает китайское издание «Новый интеллект», энтузиасты обнаружили в коде приложения Codex упоминания сразу нескольких новых моделей OpenAI — GPT-5.6 Sol, Terra и Luna. Официального подтверждения этой информации пока нет. Помимо названий моделей, исследователи обратили внимание на новую функцию выбора скорости работы модели. Предполагается, что пользователи смогут самостоятельно регулировать баланс между скоростью генерации ответов и качеством результата. OpenAI рассматривает период с 7 по 9 июля 2026 года в качестве возможного окна для релиза GPT-5.6. Предполагаемые сроки связывает с ситуацией вокруг конкурирующей платформы Claude, которая в последние недели столкнулась с критикой пользователей из-за изменений в работе сервиса и усиления ограничений. Также приводятся результаты неофициальных тестов, якобы проведенных пользователями, получившими ранний доступ к новым моделям. По их словам, GPT-5.6 Terra быстрее справляется со сложными техническими задачами и требует меньше вычислительных ресурсов по сравнению с Claude Fable 5. Еще один тест, посвященный генерации полноценной браузерной игры на WebGL в одном HTML-файле, показал, что обе модели справились с заданием, однако GPT-5.6 продемонстрировала более стабильный результат и лучшее качество реализации отдельных деталей. Кроме того, в коде Codex обнаружены признаки продолжающейся разработки поддержки голосового взаимодействия в реальном времени. Однако, как отмечают исследователи, эта функция, вероятно, не будет готова к предполагаемому июльскому релизу. Также утверждают, что OpenAI может сделать новые модели более привлекательными с точки зрения стоимости использования и доступных лимитов. По неподтвержденным данным, модель Sol Ultra должна стать прямым конкурентом флагманских решений Anthropic, предлагая сопоставимую производительность при более низкой цене. Разработчикам напоминают о необходимости проверить срок действия накопленных кредитов на сброс лимитов Codex. Согласно опубликованной информации, такие кредиты действуют 30 дней и могут начать истекать уже в середине июля. Несмотря на большое количество утечек и обсуждений, вся информация о GPT-5.6 пока основана на анализе кода, сообщениях инсайдеров и публикациях в социальных сетях. OpenAI на момент публикации официально не объявляла ни дату выхода GPT-5.6, ни состав новых моделей.
Anthropic ужесточает борьбу с обходом региональных ограничений доступа к Claude

По данным Financial Times и публикации китайского издания «Новый интеллект», компания Anthropic начала одну из самых масштабных кампаний по пресечению способов обхода региональных ограничений доступа к своим ИИ-сервисам. Новая политика затрагивает практически все известные схемы, позволявшие использовать Claude из неподдерживаемых регионов. Согласно опубликованной информации, с 3 июля 2026 года Anthropic официально заявила, что запрещает не только использование Claude в регионах, где сервис недоступен, но и любые попытки организовать такой доступ через зарубежные структуры. Под ограничения, как утверждается, попадают даже дочерние компании международных корпораций, зарегистрированные в странах, где Claude официально доступен, если сервис фактически используется сотрудниками из ограниченных регионов. Сообщается, что компания усилила технический контроль за соблюдением своих правил. Помимо анализа IP-адресов и способов оплаты, система может учитывать дополнительные признаки, например настройки часового пояса операционной системы, чтобы определить фактическое местонахождение пользователя. Anthropic также заявляет о постоянном совершенствовании механизмов обнаружения нарушений совместно со своими партнерами. По данным источников, под особым вниманием находятся несколько распространенных схем обхода ограничений: регистрация зарубежных аккаунтов сотрудниками с последующей компенсацией расходов работодателем; использование корпоративных аккаунтов через иностранные дочерние компании; доступ к Claude через облачные сервисы, включая Microsoft Azure; API-прокси и различные сервисы-посредники. При этом в публикации отмечается, что подобные способы сами по себе не обязательно нарушают законодательство отдельных стран. Основной вопрос связан с соблюдением условий использования (Terms of Service) Anthropic, а наиболее вероятным последствием для пользователей становится блокировка аккаунта. Дополнительный резонанс вызвали сообщения исследователя безопасности Аднана Хана (Adnane Khan), обнаружившего в одной из версий Claude Code механизмы, связанные с определением региона пользователя. Представители Anthropic признали существование экспериментальной функции, однако заявили, что она носила временный характер и должна быть удалена в последующих обновлениях. На фоне усиления контроля некоторые компании уже начали пересматривать использование продуктов Anthropic. В частности, согласно публикации, Alibaba объявила о внутреннем отказе от использования Claude и связанных с ним продуктов, включая Claude Code, с завершением перехода в июле. Если описанные меры будут реализованы в полном объеме, они могут существенно осложнить использование Claude в регионах, где сервис официально не поддерживается. Одновременно это может усилить позиции альтернативных ИИ-моделей, прежде всего китайских разработчиков, таких как GLM, DeepSeek, Qwen и Step.
Энергетическая битва на краю ИИ: Термоядерный синтез, мифы о миллиардных оценках и инвестиционная лихорадка

2026 год стал временем, когда венчурный рынок перестал верить в рациональность: погоня за технологиями «будущего» превратила термоядерную энергетику в арену большой геополитической и финансовой борьбы. Еще пару лет назад инвесторы обходили стартапы в сфере управляемого термоядерного синтеза стороной, считая коммерциализацию «вечной мечтой, до которой всегда остается 50 лет». Но летом 2026 года ситуация изменилась до неузнаваемости. Сегодня инвесторы готовы подписывать любые «кабальные» условия, лишь бы получить шанс встретиться хотя бы с финансовым директором (CFO) перспективного проекта. История одного из основателей термоядерного стартапа показательна: в 2024 году он провел более 80 встреч с фондами, и лишь десятая часть из них решилась на вложения. Сегодня его компания оценивается более чем в миллиард юаней. Перелом наступил в конце 2025 года, когда термоядерный синтез был официально включен в государственные планы развития как стратегическое направление наравне с квантовыми вычислениями. К весне 2026 года в отрасль хлынули колоссальные средства. Только за первую треть года объем публичных инвестиций составил около 3 миллиардов юаней. Государственный сектор не отстает: Национальное энергетическое управление Китая учредило фонд в 20 миллиардов юаней, а Шанхайский фонд перспективных отраслей вырос до 15 миллиардов. Почему «холодная» отрасль внезапно вспыхнула? Ключевым драйвером стал искусственный интеллект. По прогнозам Goldman Sachs на март 2026 года, потребление электроэнергии дата-центрами к 2030 году вырастет на 175% по сравнению с 2023-м. Битва за ИИ — это битва за вычислительные мощности, а значит — за энергию. Технологические гиганты, такие как Google, Microsoft и OpenAI, инвестируют в термоядерный синтез, чтобы обеспечить свои суперкомпьютеры круглосуточной чистой энергией. В 2025 году начали появляться стартапы, ориентированные на создание малых термоядерных реакторов мощностью около 50 МВт — как раз для питания одного крупного ИИ-центра. Сегодня отрасль сосредоточена на двух основных технологических маршрутах: Токамаки (Тороидальные камеры): классическая схема «бублика». Путь с самой мощной теоретической базой, но требующий огромных вложений и длительного строительства. Компании вроде CFS (США) и китайская Energy Singularity делают ставку именно на этот метод, веря в его надежность при наличии достаточного финансирования. FRC (Полевые обращенные конфигурации): более компактные и дешевые установки, где плазменные сгустки сталкиваются в линейной трубе. Этот метод считается более рискованным, но сулит более быструю коммерциализацию — к началу 2030-х годов. Пока ни один проект в мире не достиг показателя Q > 1 (когда энергия синтеза превышает затраты на нагрев плазмы). Для реальной коммерческой отдачи требуется Q выше 10 или даже 20. Ожидается, что критический порог Q=1 будет пройден в 2027–2028 годах. Несмотря на избыток денег, отрасль задыхается от нехватки талантов. В год выпускается всего несколько сотен докторов наук по профилю термоядерного синтеза, и за них идет настоящая война: зарплаты молодых специалистов достигают миллиона юаней. Осторожные инвесторы, опасающиеся рисков строительства самих реакторов, уходят в смежные ниши — производство высокотемпературных сверхпроводников и вакуумных систем. «Продавцы лопат» для этой золотой лихорадки могут выйти на биржу даже быстрее, чем создатели самих установок. Термоядерный синтез перестал быть просто научным экспериментом. Это инструмент геополитического доминирования и фундамент цивилизации будущего. Как говорят опытные игроки рынка: в 2026 году «нельзя купить слишком дорого, можно только купить не то». Грань между утопией и реальностью сегодня тоньше, чем когда-либо.
От отдельных AI-агентов к «интернету агентов»: зачем появился открытый проект Octo
По мере развития искусственного интеллекта сами модели становятся все более мощными, однако эффективность компаний все чаще ограничивается не качеством отдельных AI-ассистентов, а их неспособностью работать совместно. Именно эту проблему пытается решить новый открытый проект Octo, созданный компанией Mininglamp Technology. Разработчики сравнивают нынешнее состояние AI-агентов с эпохой компьютеров до появления Интернета: отдельные системы уже были достаточно производительными, но существовали изолированно друг от друга. Сегодня многие AI-помощники умеют писать код, проводить исследования, готовить документы и выполнять сложные задачи. Однако каждый из них существует в собственной среде, со своими инструментами, контекстом и правами доступа. В результате даже несколько сильных AI-агентов редко способны совместно выполнить большой проект. Авторы Octo считают, что следующий этап развития искусственного интеллекта связан не столько с повышением интеллекта отдельных моделей, сколько с созданием инфраструктуры для их взаимодействия. Octo представляет собой открытую платформу, где AI-агенты становятся полноценными участниками корпоративной работы. Если в традиционных системах ассистент принадлежит конкретному пользователю, то в Octo после соответствующей авторизации агенты могут использоваться всей организацией. Они превращаются из личных помощников в общекорпоративный цифровой ресурс. При этом человек остаётся главным участником процесса принятия решений. Девиз проекта сформулирован предельно лаконично: «Agents do. Humans decide.» («Агенты делают. Люди принимают решения.») Основой интерфейса Octo остается привычный корпоративный мессенджер. Однако разработчики рассматривают чат лишь как точку входа. Каждая задача оформляется как отдельный объект (Matter), который хранит: описание проблемы; историю выполнения; промежуточные результаты; замечания участников; итоговые решения. Таким образом компания сохраняет не только конечный документ, но и весь процесс принятия решений, что постепенно формирует корпоративную базу знаний. Одной из наиболее необычных особенностей Octo является механизм Taste («вкус» или «предпочтения»). Система фиксирует, какие результаты сотрудники одобряют, какие отклоняют и какие правки вносят. Со временем эти решения превращаются в набор корпоративных предпочтений. Благодаря этому AI постепенно начинает учитывать стиль конкретной команды, требования компании и особенности принятия решений, а не только общие знания, полученные во время обучения модели. В Octo предусмотрено несколько моделей взаимодействия между агентами. Среди них: Solo — выполнение задачи одним агентом; Roundtable — коллективное обсуждение несколькими агентами; Critic — разделение ролей исполнителя и проверяющего; Pipeline — последовательное выполнение этапов работы; Split — параллельное выполнение независимых частей проекта; Swarm — одновременное решение одной задачи несколькими агентами с последующим выбором лучшего результата. Разработчики считают, что разные типы задач требуют разных схем обмена информацией, поэтому универсального механизма сотрудничества не существует. Особое внимание разработчики уделяют защите корпоративных данных. Octo распространяется как проект с открытым исходным кодом и поддерживает локальное развертывание. Это означает, что вся информация — переписка, документы, память агентов и результаты работы — может храниться внутри инфраструктуры самой компании без передачи внешним сервисам. Такой подход соответствует концепции Private AI, в которой контроль над данными, знаниями и внутренними процессами остается у организации. Создатели Octo считают, что в ближайшие годы главным конкурентным преимуществом компаний станут уже не сами языковые модели, а собственный контекст, накопленные знания и корпоративные способы принятия решений. Платформа призвана объединить людей и множество AI-агентов в единую систему, где искусственный интеллект берет на себя выполнение задач, а человек сохраняет ключевую роль в оценке результатов и принятии окончательных решений.
Как искусственный интеллект меняет компании и роль сотрудников

Распространение генеративного искусственного интеллекта меняет не только способы работы, но и саму архитектуру бизнеса. Если раньше автоматизация в основном заменяла физический труд, то теперь AI все активнее берет на себя интеллектуальные задачи офисных сотрудников. Это заставляет компании пересматривать структуру управления, систему мотивации и место человека в организации. Главный вопрос сегодня звучит не «заменит ли AI людей», а «какой станет организация, в которой AI будет работать вместе с людьми». По мнению эксперта, технологический прогресс всегда вытеснял человека из одних сфер деятельности, открывая новые. AI продолжает эту закономерность: машины берут на себя рутинные и стандартизированные задачи, тогда как людям предстоит сосредоточиться на творчестве, принятии сложных решений, обучении моделей и контроле за их работой. Однако такой переход неизбежно сопровождается социальной напряженностью. Сотрудники опасаются потерять работу, а некоторые даже сознательно сопротивляются внедрению AI, скрывая свои рабочие процессы или предоставляя системе некорректные данные. Это сравнивают с реакцией рабочих во время промышленной революции: протесты не способны остановить развитие технологий, но требуют продуманной социальной адаптации. По мнению исследователя, ответственность за последствия автоматизации лежит не только на государстве, но и на бизнесе. Организации должны инвестировать в переподготовку сотрудников, помогать им осваивать новые профессии или обеспечивать максимально мягкий переход на другой этап карьеры. В качестве примера приводится стратегия JD.com. Компания заявила, что не планирует массовых увольнений из-за AI, а намерена обучить сотни тысяч сотрудников новым специальностям — например, обслуживанию и ремонту роботизированных систем. Такой подход рассматривается не как благотворительность, а как попытка заранее занять будущий рынок сервисных услуг. Развитие AI связывают с очередным этапом эволюции корпоративных структур. Если индустриальная эпоха породила линейные и функциональные организации, а цифровая — дивизиональные модели, то эпоха искусственного интеллекта ведет к формированию сетевых компаний. В такой модели небольшие автономные команды сосредоточены на работе с конкретными клиентами или продуктами, а большинство вспомогательных функций выполняют специализированные AI-агенты. Вместо громоздкой бюрократии возникает гибкая сеть, где человеческие команды используют интеллектуальные сервисы как внутреннюю инфраструктуру. Одной из главных проблем становится мотивация сотрудников. Если человек с помощью AI выполняет восьмичасовую работу за три часа, традиционная система управления сталкивается с дилеммой: увеличить нагрузку, сократить персонал или повысить зарплату. Подобные вопросы возникают только в старых организационных моделях, где эффективность измеряется количеством затраченного времени. В новой системе ценность определяется конечным результатом для клиента, а не количеством рабочих часов. Эксперты также критикуют традиционные системы оценки персонала. В большинстве компаний показатели эффективности слишком формальны и плохо различают действительно сильных сотрудников. Использование AI, напротив, делает вклад каждого более прозрачным и измеримым. Несмотря на опасения, связанные с возрастом сотрудников или нехваткой цифровых навыков, эти факторы не решающие. Важнее не возраст, а способность мыслить гибко, экспериментировать и использовать новые инструменты для реализации собственных идей. Именно такие сотрудники смогут максимально эффективно работать вместе с AI. Остальным же придется адаптироваться к новой реальности, в которой искусственный интеллект становится не просто очередным инструментом, а полноценной частью корпоративной среды.
Главная проблема AI — не модели, а данные: почему большинство проектов терпит неудачу

Несмотря на стремительное развитие искусственного интеллекта, большинство корпоративных AI-проектов так и не приносит ожидаемых результатов. Причина часто кроется вовсе не в недостаточной мощности моделей или вычислительных ресурсов, а в качестве данных, на которых эти модели обучаются. Именно поэтому в 2026 году акцент в развитии AI постепенно смещается от принципа «модель прежде всего» к подходу «данные прежде всего». Одним из наиболее известных примеров стала история фармацевтической компании, разрабатывавшей систему распознавания злокачественных новообразований кожи. Во время тестирования модель показывала высокую точность, однако в реальной клинической практике выяснилось, что она слишком часто связывает наличие обычной измерительной линейки на фотографии с высоким риском рака. Причина оказалась простой: врачи традиционно фотографировали подозрительные опухоли с линейкой для измерения размеров, тогда как доброкачественные образования чаще снимали без нее. В результате алгоритм научился распознавать не признаки заболевания, а наличие измерительного инструмента. Этот пример хорошо иллюстрирует принцип «мусор на входе — мусор на выходе» (Garbage In, Garbage Out): даже самая совершенная модель не сможет принимать качественные решения, если обучается на некорректных данных. По оценкам MIT, около 95% корпоративных AI-проектов оказываются неудачными. Основная причина — не слабые алгоритмы, а низкое качество исходной информации. Большой объем данных сам по себе не гарантирует успеха. Интернет содержит огромное количество дублирующейся информации, устаревших материалов, предвзятых публикаций и просто ошибочных текстов. Если все это без отбора используется для обучения модели, она неизбежно начинает воспроизводить те же ошибки. Поэтому все больше внимания уделяется созданию так называемых AI-Ready-наборов данных — подготовленных массивов информации, пригодных для обучения искусственного интеллекта. Они должны обладать четырьмя ключевыми характеристиками: полнотой структуры; разнообразием содержания; точной разметкой; совместимостью с моделями AI. Качественные данные не возникают сами по себе. Они являются результатом системной работы по управлению данными (Data Governance). Эта работа включает несколько ключевых направлений: стандартизацию данных, чтобы одинаковые показатели трактовались одинаково во всех системах; контроль качества с устранением пропусков, дубликатов и ошибок; отслеживание происхождения данных и всех этапов их обработки; управление метаданными, позволяющее понимать происхождение и назначение каждого показателя. Без этих процессов даже самые современные AI-модели будут строить выводы на противоречивой информации. В Китае все чаще используется концепция «маховика данных». Ее идея заключается в непрерывном цикле улучшения: Компания собирает реальные данные и очищает их. На качественных данных обучается специализированная модель. После внедрения AI появляются новые пользовательские данные. Они снова проходят обработку и используются для следующего этапа обучения. Каждый новый цикл делает данные лучше, модели — точнее, а бизнес — эффективнее. Однако этот механизм работает только при условии качественного управления данными. Если исходная информация содержит большое количество ошибок, маховик не ускоряет развитие, а лишь быстрее распространяет неточные результаты. Многие компании до сих пор неправильно расставляют приоритеты. Основные инвестиции направляются на покупку вычислительных мощностей и современных моделей, тогда как работе с данными уделяется минимум внимания. На практике именно предприятия, которые заранее выстроили единые стандарты данных, очистили историческую информацию и наладили контроль качества, значительно быстрее внедряют AI в производство и получают реальные результаты. В отличие от них организации, пренебрегавшие управлением данными, вынуждены месяцами заниматься очисткой информации уже после запуска проектов. Эксперты предлагают три практических шага для компаний, внедряющих AI. Во-первых, не пытаться сразу привести в порядок все корпоративные данные. Гораздо эффективнее сосредоточиться на тех наборах информации, которые необходимы для ближайших AI-проектов. Во-вторых, сначала унифицировать определения ключевых бизнес-показателей — клиентов, выручки, заказов, коэффициентов конверсии. Без единого стандарта любые аналитические результаты будут противоречивыми. В-третьих, использовать AI не только для бизнеса, но и для самого управления данными. Современные Data Agent-платформы способны автоматически выявлять ошибки, отслеживать происхождение данных, анализировать качество информации и значительно сокращать объем ручной работы. В 2026 году становится очевидно, что главным конкурентным преимуществом компаний становится уже не доступ к самым современным моделям искусственного интеллекта, а способность создавать качественные данные для их обучения. Как отмечают авторы, управление данными и создание высококачественных датасетов — это две стороны одного процесса: грамотное управление формирует надежную основу, без которой даже самые мощные AI-системы не смогут раскрыть свой потенциал.
Fable 5 вернулся, но уже не тот: как AI-модели становятся объектом нового типа регулирования

После нескольких недель ограничений компания Anthropic вновь открывает доступ к своей флагманской модели Fable 5. Однако возвращение оказалось компромиссным: вместе с разрешением на использование модель получила значительно более жесткие механизмы контроля, из-за которых часть ее наиболее сильных возможностей стала недоступна пользователям. 30 июня Министерство торговли США сняло экспортные ограничения с моделей Anthropic Fable 5 и Mythos 5, после чего компания объявила о восстановлении доступа. Однако одновременно была внедрена новая система безопасности — специальный классификатор, который анализирует запросы пользователей. Если запрос связан с потенциально чувствительными задачами, например программированием, отладкой кода или кибербезопасностью, система может автоматически перенаправить его не в Fable 5, а в более старую модель Opus 4.8. По признанию самой Anthropic, такой механизм нередко ошибочно классифицирует и совершенно обычные запросы разработчиков. Нововведение вызвало активную дискуссию в профессиональном сообществе. Многие разработчики считают, что формально Fable 5 вновь доступен, но фактически его ключевые преимущества значительно ограничены. Особенно это касается генерации программного кода — одной из самых сильных сторон модели. Поскольку часть подобных запросов теперь автоматически обрабатывается предыдущей версией, пользователи не всегда получают возможности, которыми обладал первоначальный релиз Fable 5. По мнению ряда экспертов, нынешняя версия скорее представляет собой «облегченный» вариант модели, чем полноценное возвращение оригинального продукта. Причиной изменений стали переговоры между Anthropic и американскими властями. В июне Министерство торговли США временно ограничило распространение передовых моделей компании, сославшись на риски использования AI для проведения кибератак и обхода встроенных защитных механизмов. Первоначально ограничения коснулись как корпоративных, так и потребительских продуктов. Позже доступ к Mythos 5 был частично восстановлен для отдельных организаций, а Fable 5 вернулся только после того, как Anthropic согласилась усилить систему безопасности. Именно новый классификатор стал главным элементом этого компромисса. История Fable 5 отражает более широкую тенденцию в регулировании искусственного интеллекта. Если раньше власти могли полностью запрещать распространение отдельных моделей, то теперь акцент смещается в сторону постоянного контроля их возможностей. Вместо полного запрета используются более гибкие механизмы: автоматическая фильтрация чувствительных запросов; динамическое переключение на менее мощные модели; ограничения доступа к наиболее производительным функциям; постоянный мониторинг потенциально опасных сценариев использования. Подобный подход уже затрагивает и другие компании. В статье отмечается, что новейшие модели OpenAI также проходят более длительные процедуры оценки и получают доступ к пользователям постепенно. Ситуация вокруг Fable 5 показывает, что рынок генеративного AI вступает в новую фазу. Конкуренция между разработчиками теперь сопровождается не только технологической гонкой, но и растущими требованиями со стороны регуляторов. Вероятно, в ближайшие годы передовые модели будут выпускаться уже не в максимально возможной конфигурации, а в версиях, где наиболее чувствительные функции ограничиваются с помощью специальных систем безопасности. Для пользователей это означает доступ к современным AI-инструментам, но не всегда ко всему спектру их потенциальных возможностей.