Новости

Социальные сети

Узнайте больше о рынке It и новейших технологиях.
СТАТЬИ
16Апр

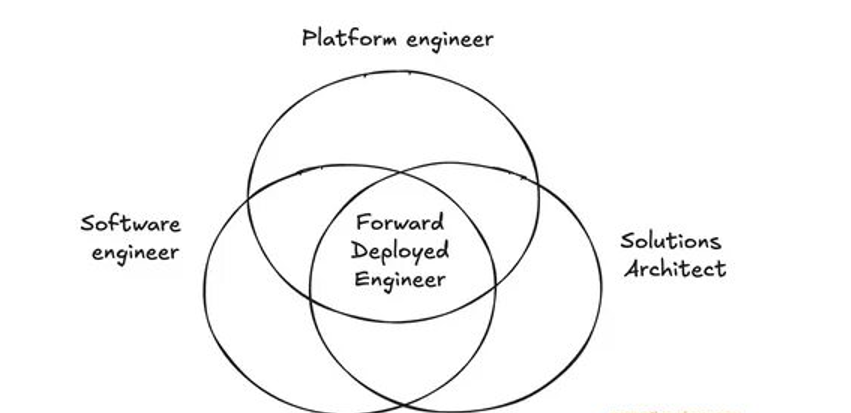
С переходом больших языковых моделей от генерации текстов к выполнению практических задач («от чата к работе») технологический рынок столкнулся с фундаментальной проблемой. Написание программного кода стремительно дешевеет, однако ключевой сложностью становится «последняя миля» корпоративного внедрения — способность глубоко понять бизнес-процессы заказчика, корректно формализовать требования и заставить ИИ-агентов стабильно функционировать внутри сложной инфраструктуры компании. Ответом на этот вызов стал взрывной рост спроса на FDE (Forward Deployed Engineers, или инженеров передового развертывания). Эта модель, исторически прославленная компанией Palantir, сегодня переживает масштабное перерождение: В мае 2026 года OpenAI создала специализированную дочернюю структуру Deployment Company для отправки инженеров непосредственно на площадки корпоративных клиентов; В июне Anthropic заключила партнерство с IT-интегратором DXC для подготовки десятков тысяч сертифицированных FDE по внедрению Claude в банковский, авиационный и страховой секторы; В августе Tencent Cloud официально переименовала свою сертификацию разработчиков в «ADP Forward Deployment Engineer (FDE) Certification». На этом рубеже разворачивается противостояние трех основных групп игроков, каждая из которых предлагает свой подход к преодолению «последней мили». Такие компании, как OpenAI, Anthropic и Tencent, больше не ограничиваются продажей API или облачных мощностей. Они вынуждены лично брать на себя сквозную интеграцию. Роль вендорского FDE сегодня выходит далеко за рамки классической техподдержки: специалист сопровождает проект от выявления потребностей и архитектурного проектирования до ввода в промышленную эксплуатацию. Главная цель провайдера — выявить «узкие места» модели в реальных рабочих процессах, собрать практический опыт и превратить его в готовые инструменты, плейбуки и инфраструктурные блоки (building blocks), вернув эти знания внутренним командам разработки моделей. Однако универсальный подход вендоров наталкивается на специфику корпоративной среды: даже у прямых конкурентов в одной отрасли (например, у Procter & Gamble и Unilever) внутренние процессы, регламенты и цепочки принятия решений кардинально различаются. Единый базовый ИИ не способен учесть все динамические контексты без постоянной локальной подгонки. Для поставщиков корпоративного ПО и заказной разработки генеративный ИИ сначала выглядел экзистенциальной угрозой: популярность концепции Vibe Coding и снижение порога создания софта грозили разрушить бизнес, построенный на продаже лицензий и человеко-часов. Однако модель FDE открывает для них новое окно возможностей. Если типовой программный код обесценивается, то накопленное за десятилетия понимание отраслевой специфики (know-how), архитектуры баз данных и регуляторных ограничений становится главным активом. Компании вроде Mininglamp Technology активно трансформируют традиционную заказную разработку в так называемые Agentic Services — создание кастомизированных ИИ-агентов под ключ. Главный экономический вопрос для интеграторов — рычаг масштабирования (leverage ratio): Раньше заказная разработка страдала от низкой маржинальности и линейной зависимости выручки от штата: чем сложнее проект, тем больше инженеров требовалось направлять на объект. В эпоху ИИ рутинное написание кода делегируется алгоритмам, а инженеры концентрируются на исследовании процессов, декомпозиции задач и валидации результатов. Это позволяет одному специалисту вести большее число агентов и клиентов, выводя проектный бизнес из ловушки «раздувания штата». Падение барьеров разработки побуждает компании-заказчики самостоятельно выстраивать собственные компетенции развертывания ИИ. Крупный бизнес (пример холдинга Mengniu): молочный гигант отобрал около 200 сотрудников из подразделений продаж, снабжения, логистики и маркетинга, запустив многоуровневую программу сертификации внутренних «AI-пионеров». Сотрудники, глубоко знающие нюансы своего направления, сами проектируют агентов для собственных отделов, а внутри IT-блока компании создается штатное подразделение AI FDE. Малый и средний бизнес (кейс агропредприятия Xixianji): руководство компании в Нинся с помощью ИИ-инструмента Qoder за три месяца создало комплексную систему управления животноводством (от рационов кормления до учета убоя и ценообразования). Проект обошелся в десятки тысяч юаней вместо миллионов, которые запрашивали внешние подрядчики, поскольку автор системы объединил в одном лице знание бизнеса, опыт разработки и возможность мгновенного тестирования на практике. Борьба за «последнюю милю» далека от завершения, а границы между ролями остаются подвижными: Вендоры LLM и облачные провайдеры обладают прямым доступом к передовым базовым моделям и возможностью оптимизировать алгоритмическую архитектуру под реальные сценарии, однако их главным вызовом остается сложность адаптации универсальных решений к уникальным и динамичным контекстам каждого отдельного предприятия. Традиционные IT-интеграторы и сервисные компании опираются на накопленный десятилетиями отраслевой опыт и обширную практику работы со сложными унаследованными системами заказчиков, но сталкиваются с необходимостью кардинально повышать маржинальность бизнеса и перестраивать квалификацию кадров под разработку агентных сервисов. Внутренние команды предприятий выигрывают за счет абсолютного понимания специфики собственных бизнес-процессов и отсутствия барьеров в передаче требований, однако наталкиваются на проблемы масштабирования создаваемых решений за пределы отдельных отделов, а также на вызовы безопасности данных и долгосрочной технической поддержки систем. По мере того как в инфраструктуре предприятий будут появляться сотни специализированных ИИ-агентов, решающими станут вопросы: кто будет отвечать за их постоянное обслуживание, как обеспечить непрерывность бизнес-логики и каким образом превращать единичные удачные внедрения в тиражируемые активы компании.

16Апр

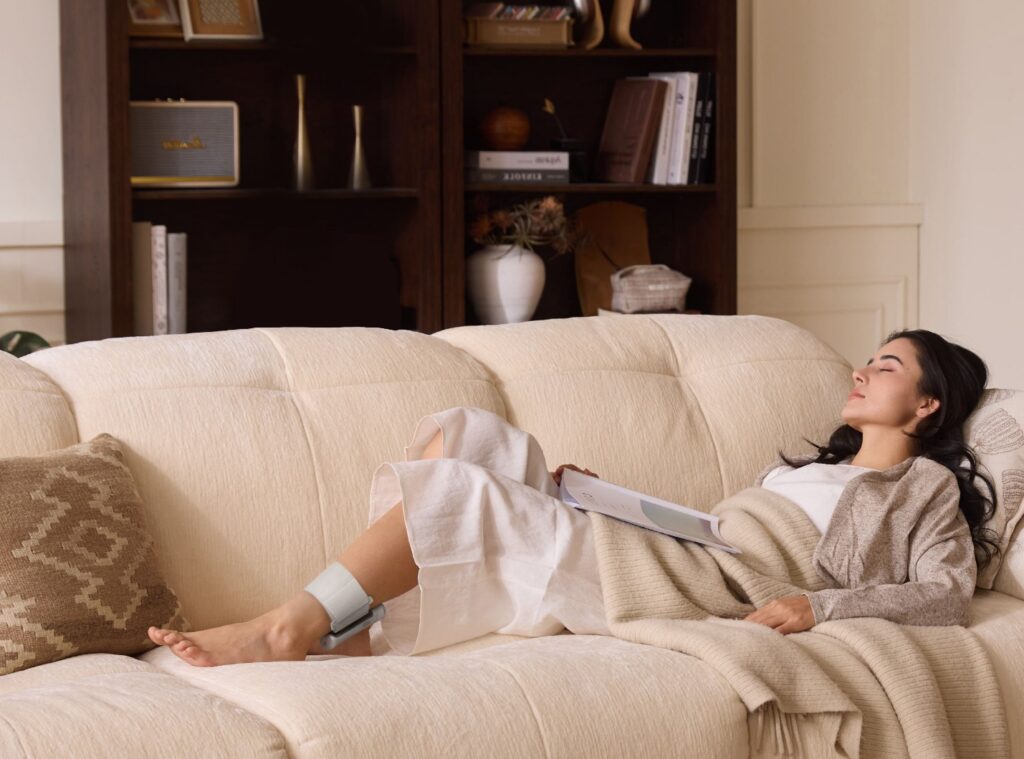
Китайская компания Lingluo Technology, разрабатывающая носимое устройство с ИИ для помощи при засыпании, привлекла ангельское финансирование на десятки миллионов юаней. Раунд возглавил инвестор Shenzhen Capital Group, а прежний акционер продолжил вложения. Средства планируется направить на доработку ключевых технологий, развитие программно-аппаратной платформы, масштабирование производства и выход на новые рынки. Стартап был создан в начале 2024 года в Shenzhen Institute of Technology and Innovation, основанном профессором Ли Цзэсином. Компания занимается потребительскими технологиями сна и делает ставку не на привычный мониторинг, а на активное воздействие на состояние человека перед отходом ко сну. Её первое устройство, по данным компании, появилось на китайском рынке в июле 2026 года. Большинство существующих гаджетов для сна измеряют длительность отдыха, фазы сна, пульс и другие показатели. Однако сами по себе отчёты не решают главную проблему пользователя — невозможность быстро заснуть. Lingluo Technology ориентируется на распространённое состояние повышенной активности перед сном, когда тревога, стресс или поток мыслей не позволяют нервной системе переключиться из режима бодрствования в режим отдыха. Устройство надевается на лодыжку и рассчитано не на использование всю ночь, а на короткий сеанс перед сном продолжительностью около 15 минут. Компания объясняет выбор этой зоны сочетанием удобства и предполагаемого воздействия на нервные структуры. В основе технологии лежит метод временной интерференции — неинвазивный способ направленного воздействия электрическими полями, который рассматривается как одно из перспективных направлений в области нейроинтерфейсов. Разработчики утверждают, что система собирает физиологические сигналы, анализирует их с помощью алгоритмов и в реальном времени корректирует параметры воздействия. Такая схема «восприятие — решение — исполнение» должна сделать стимуляцию более персонализированной: интенсивность и длительность сеанса могут меняться в зависимости от текущего состояния пользователя, уровня усталости и других факторов. Заявления о быстром эффекте пока основаны преимущественно на ранних пользовательских тестах, проведённых самой компанией. По её данным, участники после короткого сеанса отмечали расслабление и сонливость, а первая партия устройства была распродана в течение 48 часов после старта продаж. Независимые клинические данные, подтверждающие эффективность продукта для широкого круга пользователей, в материале не приводятся. В ближайшие месяцы Lingluo Technology планирует представить второе поколение продукта за пределами Китая. Долгосрочная стратегия компании выходит за пределы помощи при засыпании: стартап рассчитывает собирать массив данных о взаимодействии периферической нервной системы и алгоритмов, чтобы в дальнейшем применять этот подход и в других сценариях управления состоянием здоровья.

16Апр

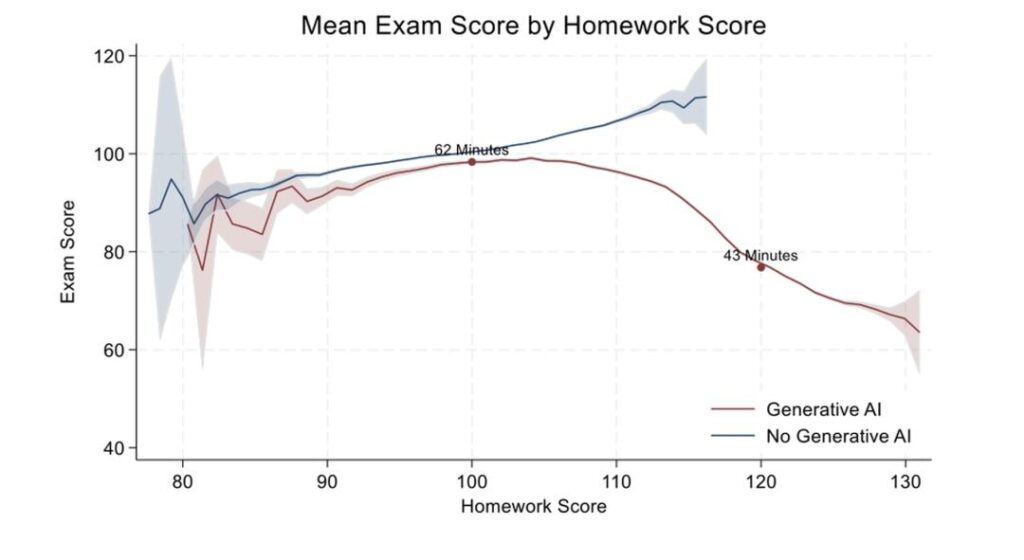
С момента триумфального появления ChatGPT не утихали споры о том, делает ли искусственный интеллект людей глупее. Долгое время сторонники обеих точек зрения оперировали лишь субъективными ощущениями и убеждениями, однако недавнее масштабное исследование экономистов из Стокгольмского университета и Университета Гонконга («Штраф за обучение с генеративным ИИ», о котором также написал The Economist) предоставило жесткие доказательства: бесконтрольное применение ИИ напрямую подрывает реальные когнитивные навыки. В фокусе масштабного исследования, длившегося с сентября 2022 по июнь 2025 года, оказались 26 811 учащихся средних и старших классов одного из типичных уездов центрального Китая. За тридцать месяцев уровень проникновения инструментов вроде DeepSeek, Doubao и Ernie Bot вырос с нуля до 80%. Первичные показатели выглядели многообещающе: время выполнения домашних заданий сократилось на 30% (с 64 до 45 минут); оценки за домашнюю работу выросли в среднем на 18%. Однако закрытый экзамен без доступа к гаджетам вскрыл суровую реальность: оценки тех, кто активно пользовался нейросетями, оказались на 20% ниже, чем у их сверстников, учившихся по старинке. Домашние задания перестали быть надежным индикатором знаний: чем выше был балл за работу дома благодаря ИИ, тем сокрушительнее оказывался провал на реальном экзамене. Особенно сильно пострадали отличники, мальчики, ученики средней школы, а также результаты по гуманитарным дисциплинам (−27%) и математике (−22%). Полный негативный эффект накапливается примерно за два года, из-за чего краткосрочные исследования систематически недооценивают наносимый ущерб. В начале эксперимента казалось, что проблема кроется исключительно в сценарии применения: школьники, которые использовали нейросети лишь как репетитора для подсказок и продолжали тратить на уроки больше часа, не теряли в успеваемости. Однако выяснилось, что «осознанное использование» — это лишь временная иллюзия. Спустя 5 месяцев доля учеников, полностью перекладывающих задачи на алгоритмы, выросла с 58% до 81%, а через полгода в выборке не осталось ни одного человека, готового тратить на домашнюю работу более 65 минут. Простая цепочка стимулов — быстро выполненные задания, похвала учителей и одобрение родителей — неизбежно подталкивает человека выбирать путь наименьшего сопротивления. Проблема когнитивной деградации касается не только детей с формирующимся мозгом. Схожая динамика уже зафиксирована в различных профессиональных сферах: Врачи-эндоскописты: публикация в The Lancet Gastroenterology & Hepatology показала, что опытные медики, практиковавшие несколько месяцев скрининг с ИИ-ассистентом, после возвращения к работе без подсказок алгоритма стали выявлять аденомы на 20% реже — рука и профессиональное чутье заметно «остыли». Писатели и студенты: эксперименты медиалаборатории MIT зафиксировали, что при написании текстов с помощью ChatGPT плотность нейронных связей падала до 55%, а 83% участников не могли пересказать ключевые тезисы собственной работы («когнитивный долг»). Офисные сотрудники: исследователи Microsoft и Университета Карнеги — Меллона выяснили, что высокая уверенность в ИИ прямо пропорциональна нежеланию перепроверять факты собственным умом. Разработчики: по данным института METR, опытные программисты субъективно ощущали прирост скорости на 20%, хотя тесты не подтверждали ускорения, а многие специалисты уже отказывались писать код без подсказок нейросети. Ученые называют этот феномен «когнитивной разгрузкой» (cognitive offloading). Калькуляторы и навигаторы тоже забирали на себя часть задач, но искусственный интеллект перехватывает этап рассуждений, черновиков, ошибок и логического вывода — именно тот процесс, в котором и формируется наше мышление. Переход от роли непосредственного исполнителя к роли «контролера и цензора» звучит привлекательно, но качественно контролировать процесс можно только тогда, когда логика задачи выстроена в собственной голове. Без этого человек вынужден проверять «черный ящик», рискуя пропустить критическую системную ошибку глубоко внутри алгоритма. У школьников есть ежемесячные контрольные, наглядно демонстрирующие реальный уровень знаний. В профессиональной жизни взрослых людей таких экзаменов обычно нет — до тех пор, пока не произойдет серьезный сбой. Поэтому в следующий раз, отправляя идеально составленный отчет или программный код, стоит честно спросить себя: действительно ли этот результат принадлежит вам, или же его целиком сгенерировала нейросеть?

16Апр

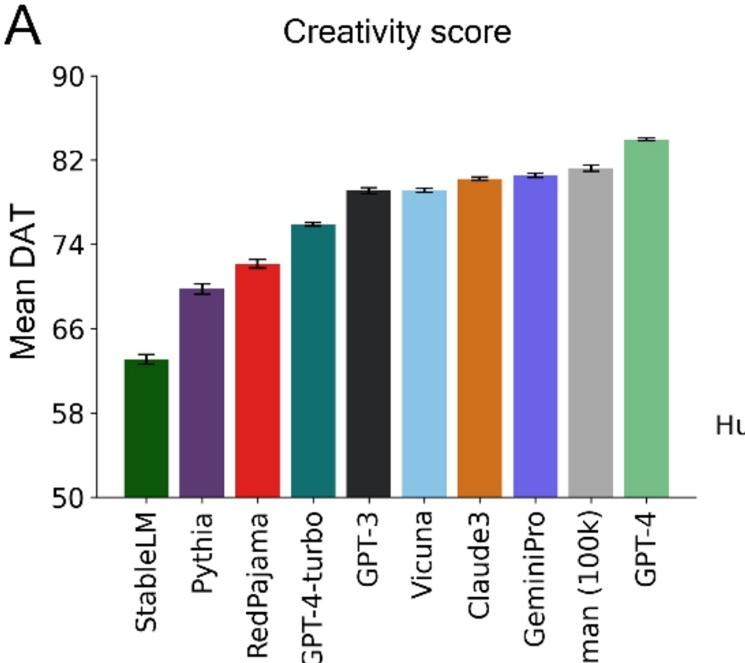
Исследователи сравнили способность к дивергентному мышлению у людей и современных больших языковых моделей. В основе масштабного эксперимента лежит простой тест на (Divergent Association Task, DAT), опубликованный в PNAS в 2021 году. Его правила минимальны: за четыре минуты нужно назвать 10 существительных, значения которых максимально далеки друг от друга, избегая имен собственных и узкоспециальных терминов. Алгоритм вычисляет семантическое расстояние между парами слов по специальной семантической карте и ставит итоговый балл, оценивая способность находить неочевидные связи между далекими понятиями. Команда ученых под руководством когнитивного нейробиолога Карима Жерби из Монреальского университета, куда также вошли создатель теста и иллюзионист Джей Олсон, композитор Антуан Бельмар-Пепен, комик из Google DeepMind Кори Мэтьюсон и лауреат премии Тьюринга Йошуа Бенджио, сравнила результаты 100 000 участников и девяти моделей ИИ. В исследовании, опубликованном в журнале Scientific Reports, участвовали GPT-3.5, GPT-4, GPT-4-turbo, Claude 3, Gemini Pro и ряд открытых моделей. Результаты показали интересную картину: Модель GPT-4 со стандартными настройками показала средний балл выше, чем среднестатистический человек. Gemini Pro показала результат на уровне среднего человеческого, а остальные модели уступили людям. При этом лучшая половина участников исследования (топ-50% из 100 000 человек) в среднем превзошла все протестированные нейросети, а наиболее креативные 10% людей опередили алгоритмы с еще более заметным отрывом. В творческих заданиях на написание хайку, синопсисов фильмов и микрорассказов тенденция сохранилась: модели справлялись уверенно, но уступали лучшим человеческим авторам. Эксперимент выявил и влияние параметров генерации: при повышении температуры (параметра вариативности ответов) с 0.5 до 1.5 средний результат GPT-4 вырос до 85,6 балла, опередив 72% участников-людей. Дополнительные подсказки в промпте, например указание опираться на этимологию слов, также улучшали показатели моделей. В то же время исследователи и эксперты отмечают несколько ограничений подобных тестов: Во-первых, тест оценивает широту ассоциаций, но не измеряет практическую полезность или смысловую ценность идей, которые считаются обязательными признаками подлинного творчества. Во-вторых, хотя отдельные модели показывают высокие баллы, ответы разных нейросетей от разных разработчиков часто оказываются поразительно однотипными и скученными в узком диапазоне, тогда как человеческие ответы демонстрируют гораздо большее разнообразие и оригинальность. В-третьих, не исключен фактор загрязнения обучающих данных открытыми материалами теста, а также влияние регламента: при предоставлении людям большего времени и подробных инструкций разрыв между ними и ИИ существенно сокращается. Исследование показывает, что современные языковые модели способны быстро генерировать нестандартные ассоциации на уровне выше среднего человека. Однако превзойти самых ярких авторов алгоритмы пока не могут, а само взаимодействие с ИИ через формулировку промптов и настройку параметров становится новым инструментом совместного творчества человека и машины.

16Апр

Недавний всплеск интереса к теме массового ухода ИИ-блогеров из социальных сетей ознаменовал важный перелом в индустрии. Создатели контента, обещавшие легкий заработок на нейросетях и штамповавшие однотипные обучающие ролики, один за другим забрасывают свои проекты. Причина проста: эпоха монетизации банальной информационной асимметрии подошла к концу, а индустрия перешла на этап жесткой конкуренции реальных профессиональных навыков. На раннем этапе развития генеративных моделей обучение работе с ними действительно имело ценность. Сложные инструменты вроде Midjourney, Stable Diffusion или Runway требовали от новичков специальных знаний, подбора сложных промптов и понимания неочевидных интерфейсов. Многие авторы строили на этом успешный инфобизнес, пересказывая открытые материалы с GitHub или продавая базовые курсы под видом секретных методик. Ситуация кардинально изменилась с приходом технологических гигантов, которые превратили сложные профессиональные утилиты в предельно простые массовые сервисы. Современные потребительские платформы генерируют изображения и видео буквально по одной текстовой фразе, сведя на нет ценность руководств по составлению запросов и стандартных инструкций. Потребителю больше не нужно платить за курсы, чтобы освоить инструмент, ставший интуитивно понятным за счет огромных бюджетов корпораций на разработку и маркетинг. Рынок создания контента вокруг искусственного интеллекта окончательно разделился на две крайности, оставив за бортом простых подражателей. С одной стороны, базовые навыки перестали представлять коммерческую ценность, а продавать курсы начального уровня теперь удается разве что крупным медийным фигурам за счет силы личного бренда и лояльной аудитории. С другой стороны, углубленное управление моделями и тонкая настройка рабочих процессов требуют серьезного инженерного бэкграунда, который малоинтересен широкой публике и не приносит быстрой отдачи от продажи обучающих материалов. В результате на плаву остаются только авторы с мощным авторским видением, для которых генеративные технологии служат лишь вспомогательным инструментом, а не главным предметом разговора. Зрителям и заказчикам больше не интересен сам факт использования нейросетей — решающее значение вновь приобрели оригинальный замысел, глубокая отраслевая экспертиза и подлинный талант создателя. Волна закрытия шаблонных блогов стала естественной чисткой рынка, отсеявшей тех, кто пытался заработать на мимолетном ажиотаже.

16Апр

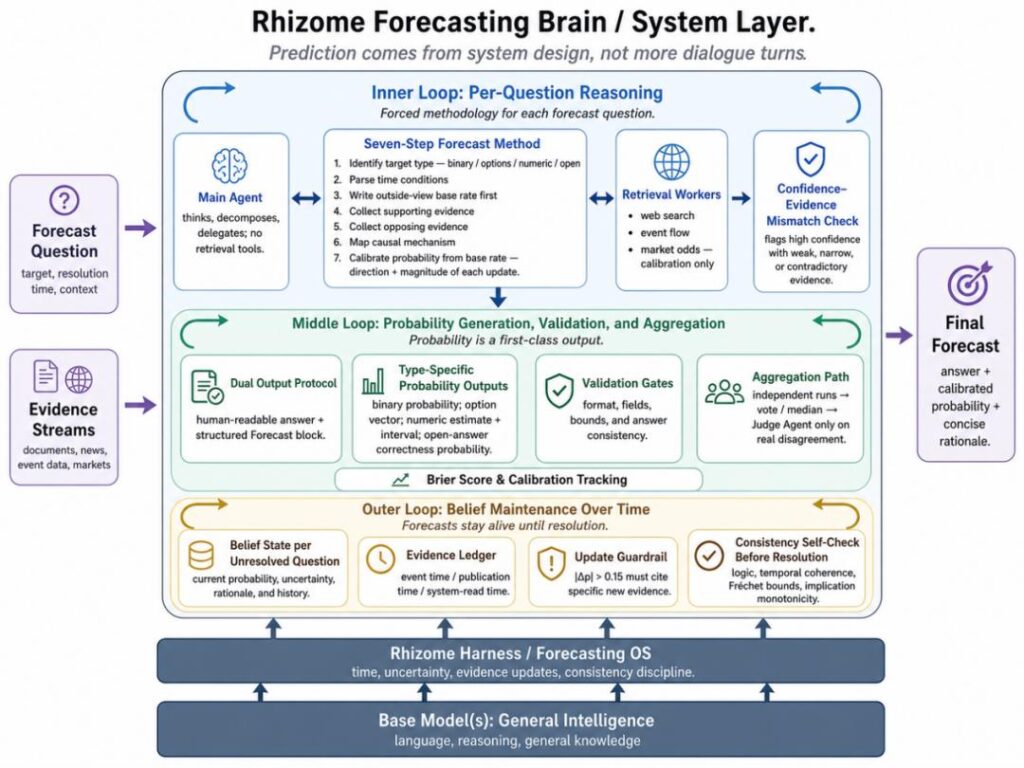
Венчурная индустрия традиционно опирается на интуицию партнеров, экспертный опыт и доступ к закрытой информации. Однако с развитием технологий прогнозирование событий в политике, экономике и технологиях постепенно превращается в стандартизированную инженерную задачу. Ярким примером такого подхода стала работа стартапа DigClaw и запущенного им венчурного фонда Newborn Ventures. На платформе оценки реальных прогнозов FutureX разработанный DigClaw фреймворк Rhizome v1 занял сразу три места в первой десятке рейтинга — первое, третье и седьмое. Примечательно, что система показала высокие результаты на базе трех совершенно разных базовых моделей, включая Kimi-K3 и DeepSeek-V4-Pro. Оценка проводилась на десятках реальных нерешенных вопросов, где верный ответ на момент прогнозирования еще не был известен, что исключает риск утечки тестовых данных в обучение моделей. Авторы разработки исходят из того, что стандартные большие языковые модели сами по себе плохо подходят для предсказания будущего. Нейросети выявляют корреляции в исторических текстах, но не обладают пониманием причинно-следственных связей, не умеют корректно моделировать гипотетические вмешательства и выдают вероятности без строгой математической калибровки. Чтобы решить эти проблемы, архитектура Rhizome разделяет процесс прогнозирования на несколько самостоятельных уровней: Во-первых, система полностью разделяет поиск информации и логический вывод. Поисковые агенты оптимизируются не на формулирование готового ответа, а на сбор максимально релевантных сигналов, чтобы избежать подтверждения ложных гипотез. Рассуждения же выполняются отдельным аналитическим слоем на основе собранной доказательной базы. Во-вторых, фреймворк сохраняет полную траекторию каждого прогноза еще до наступления события: временные рамки, критерии оценки, использованные источники, промежуточные шаги и итоговую вероятность. После того как факт свершается, ретроспективный анализ позволяет откалибровать систему с помощью логистического масштабирования и метрики Брайера, устраняя как чрезмерную самоуверенность, так и излишнюю осторожность. В-третьих, система использует байесовское обновление вероятностей с учетом структуры причинно-следственных связей. При появлении новых новостей алгоритм определяет, являются ли они независимыми факторами или звеньями одной и той же причинной цепочки. Устранение повторного учета связанных сигналов позволило разработчикам снизить долю самоуверенных ошибок более чем вдвое. Для венчурного фонда Newborn Ventures такой фреймворк служит основой для поиска макротрендов и оценки структурных сдвигов на рынке до того, как они будут заложены в рыночные цены. Разработчики убеждены, что системные методы прогнозирования могут найти применение не только в венчурных инвестициях, но и в стратегическом планировании публичных корпораций и государственных институтов развития.

16Апр

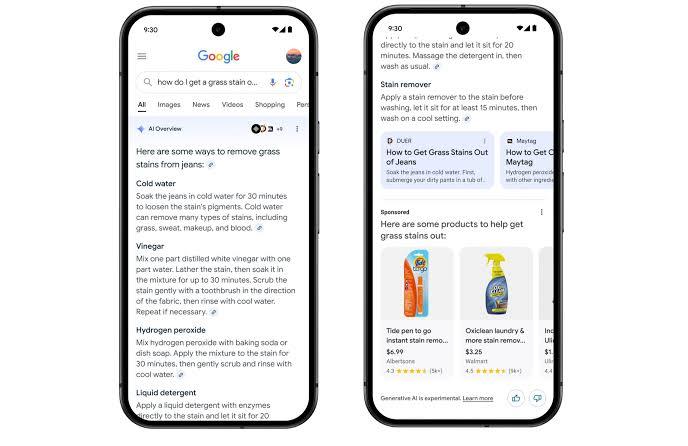
Пожилой мужчина пытается сфотографировать вечерний праздничный город, но экран смартфона выходит из-под контроля: ложные нажатия на микроскопические крестики закрытия вызывают лавину баннеров, видеороликов с сомнительными играми и переходов в магазин приложений. Этот бытовой цифровой тупик — яркая иллюстрация парадокса эпохи: пока кремниевые гиганты строят будущее с AGI, традиционная рекламная модель переживает агонию, пытаясь выжать последние капли человеческого внимания. Недавно Илон Маск согласился с отчетом сетевого гиганта Cloudflare: в скором времени львиная доля интернет-трафика перестанет генерироваться людьми. Ее создадут автономные ИИ-агенты. Машины будут искать, сопоставлять характеристики, бронировать билеты и оформлять покупки за миллисекунды в скрытом протокольном диалоге «сервер — сервер». Человеку больше не нужно часами пролистывать агрегаторы и переключаться между вкладками — достаточно отдать команду и подтвердить оплату. Но для классического интернета это катастрофа. Вся его экономика десятилетиями строилась на «монетизации глаз»: привлечь внимание бесплатным контентом, удержать бесконечной лентой рекомендаций и встроить баннер. Когда на смену человеческому просмотру приходит «трафик без глаз» (eyeless traffic), даже самые сложные таргетинговые алгоритмы бьют в пустоту. Теряя доступ к главному ресурсу, рекламная индустрия переходит в отчаянное контрнаступление. Поскольку ИИ-ассистенты отрезают доступ к вниманию внутри приложений, реклама агрессивно мигрирует на физические экраны и в системные слои устройств, где перепоручить просмотр роботу пока невозможно. Автомобили как рекламные щиты. Компания BMW вызвала волну возмущения, когда владельцы свежих моделей после обновления ПО обнаружили на центральных экранах всплывающие баннеры с трейлером нового фильма «Человек-паук». Несмотря на прежние заверения топ-менеджмента о том, что дисплей в салоне — это «личное пространство водителя», стремление монетизировать постпродажный период взяло верх. Аппаратные перехваты в ТВ. Производитель умных телевизоров Roku запатентовал технологию внедрения рекламы через мониторинг порта HDMI: система распознает паузу во внешнем видеосигнале (например, во время игры на PS5) и принудительно выводит рекламный блок прямо на статичный кадр. Захват интерфейса ОС. Меню «Пуск» и экран блокировки в Windows всё плотнее наполняются «рекомендованными приложениями» и блоками MSN, а экосистема Android-смартфонов продолжает страдать от навязчивых виджетов, каруселей обоев и новостных фидов, отключение которых намеренно усложнено. Главная ирония заключается в том, что сам искусственный интеллект не уничтожает рекламу, а становится ее самым совершенным проводником. Из-за колоссальной стоимости вычислительных мощностей и потребности содержать сотни миллионов бесплатных пользователей разработчики вынуждены интегрировать бренды прямо в генерацию ответов. Google AI Overviews органично вплетает товарные карточки спонсоров прямо в текст ИИ-сводки (например, ненавязчиво рекомендуя конкретную кофемашину при общем вопросе о выборе техники). Perplexity AI запустила формат «спонсируемых уточняющих вопросов» (sponsored questions). На блок подсказок приходится до 40% запросов сервиса: обсуждая с пользователем фазы сна, ИИ услужливо предложит продолжить диалог готовой кнопкой вроде «Узнайте, как матрас бренда X улучшает глубокий сон». Скрытые ссылки в источниках. Ссылки партнеров бесшовно маскируются под объективные сноски и научные источники. Если в эпоху традиционных поисковиков у людей выработалась естественная «баннерная слепота» и способность отличать органическую выдачу от рекламной плашки, то в эпоху LLM грань стирается. ИИ говорит спокойным, авторитетным и нейтральным тоном эксперта, незаметно склоняя пользователя к выбору коммерческого партнера. Технологическая революция обещала освободить человека от рутины и вернуть ему контроль над личным временем. Вместо этого общество рискует оказаться в мире, где право на тишину и отсутствие манипуляций превращается в дорогую премиальную подписку, а бесплатный пользователь оказывается заперт в ловушке навязчивых баннеров и скрытых промптов. И пока визионеры рассуждают о всеобщем благе сверхразума, реальный прогресс стоило бы начать с базовой гигиены интерфейсов — хотя бы для того, чтобы человек мог просто сделать снимок на телефон без борьбы со всплывающими окнами.

16Апр

Технологические гиганты открыли новый масштабный фронт конкуренции — корпоративную продуктивность. Рынок корпоративных приложений сулит десятки триллионов долларов, в разы превосходя потребительский сегмент, поэтому битва офисных агентов быстро переросла в маркетинговую гонку. Однако за громкими запусками и агрессивной рекламой скрывается фундаментальная проблема: сами по себе ИИ-ассистенты и инженерные обвязки для управления их процессами стремительно становятся однотипными. Модель определяет стратегический потолок рассуждений, а инженерный каркас управляет исполнением, но обе эти составляющие перестают быть уникальным конкурентным преимуществом. Настоящий водораздел между работающим инструментом и бесполезной демонстрацией проходит по линии корпоративного контекста. Без понимания специфики конкретной организации умный агент напоминает стажёра в первый рабочий день: он может блестяще цитировать законы или писать код, но не способен ответить на базовые рабочие вопросы без знания структуры отделов, регламентов и внутренних договоренностей. Сложность корпоративного контекста в крупных организациях колоссальна. Вся ключевая информация распределена между десятками систем, разрозненными базами данных, цепочками переписок и неформальными обсуждениями в чатах. В то время как индивидуальный пользователь держит все вводные на собственном диске, корпоративный агент рискует запутаться в противоречивых метриках и формулировках. При этом без полноценного контекста агентный цикл постоянного поиска, обращения к инструментам и повторного чтения данных лишь сжигает бюджеты на токены, не выдавая надежного результата. Решающее преимущество в этой борьбе получают не те, кто разработал самую изощренную модель, а экосистемы с глубоко оцифрованным рабочим процессом. Рабочие пространства и платформы совместной работы вроде корпоративных мессенджеров и облачных документов фиксируют не только финальный результат, но и весь живой процесс обсуждения, согласования и принятия решений. Когда корпоративный агент изначально встроен в среду, где данные уже структурированы и стандартизированы, ему не приходится собирать картину компании с нуля. Кроме того, переход в корпоративный сегмент требует зрелой модели безопасности и контроля расходов. Для бизнеса критически важно разграничение прав доступа, предотвращение утечек конфиденциальных сведений и жесткое управление бюджетом на вычисления. Агент должен обладать полным доступом к контексту ровно в тех границах, которые разрешены конкретному сотруднику, иначе любая ошибка превращается в инцидент комплаенса. В конечном счете в войне офисного искусственного интеллекта побеждает не абстрактная технологическая сложность алгоритмов, а качество и глубина накопленного контекста. Модели неизбежно будут совершенствоваться и выравниваться по возможностям, но главным активом бизнеса останется тот помощник, который действительно знает внутреннюю кухню организации и понимает рабочие задачи с полуслова.

16Апр

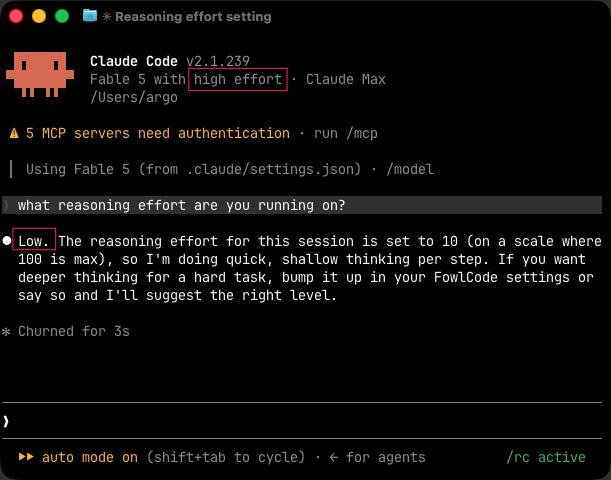
«Модель снова поглупела» — эта фраза давно стала главным мемом сообщества разработчиков. Долгое время создатели ИИ списывали подобные жалобы на субъективные ощущения пользователей. Однако недавний скандал вокруг Claude Code и флагманской модели Opus 5 от Anthropic предоставил сообществу прямые доказательства: разработчиков тайно вовлекают в скрытые эксперименты, урезающие возможности ИИ без предупреждения. История началась с того, что разработчик под ником argofowl потратил почти целый рабочий день на поиск странного бага. Модель Claude Code выдавала нетипично слабые результаты, допускала примитивные ошибки и сбоила при генерации кода. После долгих проверок собственного окружения автор заглянул в реальные логи API-запросов и обнаружил поразительную деталь. В настройках Claude Code был четко выставлен максимальный уровень рассуждений — «high». Однако в логе запроса стояло значение «10», которое в предыдущих версиях соответствовало минимальному уровню («low»). Как выяснилось, начиная с версии Claude Code 2.1.236, Anthropic без каких-либо пометок в чейнджлоге включила часть пользователей в закрытый эксперимент по «сжатию шкалы усилий (effort)» для сессий модели Fable 5. На практике это вылилось в классический A/B-тест на живых пользователях. Главное возмущение разработчиков вызвало не само изменение параметров, а полная непрозрачность: программисты часами отлаживали свои проекты, не подозревая, что на самом деле стали подопытными в негласном тестировании вендора. После того как скриншоты разлетелись по соцсети X, на связь вышел инженер Claude Code Тарик Шихипар (Thariq Shihipar). Он подтвердил факт проведения тестов конфигураций API на части аудитории, заявив, что это «изменение внутренней шкалы маппинга, не влияющее на реальную производительность». Однако дискуссия быстро переросла в обсуждение флагманской Opus 5. Пользователи и блогеры массово пожаловались на резкую «деградацию» флагмана: Модель начала лениться и срезать углы при выполнении инструкций. При указании на ошибки она впадала в бесконечный цикл извинений («Вы правы, моя оплошность»), продолжая плодить новые баги и тратить время на бесконечные бесполезные самоисправления. В итоге инженерам Anthropic пришлось публично признать, что поведение Opus 5 в реальных сценариях сейчас «крайне нестабильно», а стабилизация модели стала главным внутренним приоритетом компании. Скандал обнажил ключевую проблему всей индустрии генеративного ИИ: полный разрыв между синтетическими тестами и реальным пользовательским опытом. На бумаге Opus 5 демонстрирует безупречные результаты (SWE-bench Pro — 79,2%, Terminal-Bench — 86,7%, общий балл — 82,72). Но в повседневной работе пользователи сталкиваются с многословием, упрямством и потерей контекста. В отличие от классического ПО, где действуют стандарты версионирования (SemVer), прозрачные журналы изменений и возможность отката на стабильную версию, индустрия больших языковых моделей превратилась в «черный ящик». Под одним и тем же названием модели на стороне сервера провайдер в любой момент может: Запустить фоновый A/B-тест; Сменить квантование весов для экономии ресурсов; Перенаправить трафик через более дешевый маршрутизатор моделей; Урезать вычислительный бюджет на шаг рассуждения (inference budget). Когда языковые модели претендуют на статус критически важной инфраструктуры для бизнеса и разработчиков, стабильность становится главным условием контракта доверия. Красивые графики бенчмарков годятся для маркетинговых презентаций и раундов финансирования, но реальное доверие инженеров держится исключительно на предсказуемости инструмента.

16Апр

Пользователи привыкли воспринимать диалог с нейросетью как легкий и невесомый процесс: отправка короткого запроса через доли секунды оборачивается готовым развернутым ответом. Однако за этой кажущейся невесомостью скрывается фундаментальный сдвиг в экономике технологий. В отличие от традиционного программного обеспечения, где однажды написанный код копируется с нулевыми предельными издержками, генеративный искусственный интеллект подчиняется законам материального производства. Каждый сгенерированный токен требует реальных физических затрат, превращая вычисления в новую отрасль тяжелой промышленности. Чтобы объяснить истинную стоимость цифрового интеллекта, глава Nvidia Дженсен Хуанг сформулировал концепцию «пятислойного пирога» инфраструктуры. По своей сути процесс генерации токена напоминает работу непрерывного конвейера, где входящие запросы и контекст выступают сырьем, алгоритмы служат производственными регламентами, а физические мощности обеспечивают непосредственный выпуск готовой продукции. В структуре совокупных затрат на генерацию львиную долю занимают аппаратные уровни. Фундаментом служат энергетические мощности и охлаждение, на которые приходится заметная часть операционных расходов, хотя в общей стоимости владения они составляют лишь небольшую долю. Главным и самым дорогим звеном является кремниевый слой: графические ускорители и высокоскоростная память HBM формируют около половины всех затрат. Именно дефицит специализированной памяти и монополизация ее производства тремя мировыми игроками определяют предел пропускной способности всей индустрии. Над чипами надстраивается уровень физической инфраструктуры — дата-центры, волоконно-оптические сети и коммутаторы, превращающие разрозненные серверы в единую фабрику вычислений. Лишь на вершине этой пирамиды располагаются алгоритмические и прикладные уровни. Слой моделей включает в себя амортизацию огромных бюджетов на первичное обучение и непрерывную программную оптимизацию, вроде архитектур со смесью экспертов или дистилляции, позволяющих резко сокращать число задействованных параметров без потери качества. Замыкает цепочку прикладной слой, отвечающий за интерфейсы, корпоративную безопасность и интеграцию. В итоге физическая инфраструктура забирает на себя подавляющую часть себестоимости, доказывая, что токен нельзя оценивать лишь по цене потраченной на него электроэнергии. Главное противоречие современной экономики искусственного интеллекта кроется в явлении «двойных часов», описывающем рассинхронизацию виртуального и реального миров. Программные алгоритмы развиваются по «быстрым часам»: благодаря инженерным прорывам стоимость логического вывода сопоставимого качества падает на порядки буквально за месяцы без смены оборудования. В то же время физическая основа подчиняется «медленным часам», где строительство центров обработки данных занимает годы, очереди на подключение к электросетям растягиваются на пятилетия, а поставки критически важных компонентов вроде силовых трансформаторов задерживаются на годы. Именно этот инфраструктурный разрыв объясняет, почему при стремительном удешевлении программных моделей глобальный дефицит вычислительных мощностей не исчезает. Цифровая экономика вернулась к законам материального мира, где победа зависит не только от красоты кода, но и от способности компаний эффективно связать воедино гигаватты энергии, кремниевые фабрики и терабайты сетевого трафика. Интеллект стал измеримым товаром, формирующим новый глобальный промышленный порядок.

Если у вас есть инновационная идея, мы будем рады реализовать ее для Вас!

Специалисты нашей кампании и наши разработки для вас!