Новости

Социальные сети

Узнайте больше о рынке It и новейших технологиях.
СТАТЬИ
16Апр

В последние месяцы видеогенератор Seedance стал одним из ключевых коммерческих проектов ByteDance. Если массовые ИИ-продукты компании, такие как Doubao, продолжают бороться за пользовательскую аудиторию, то именно корпоративные сервисы на базе Seedance уже сегодня приносят реальную выручку. По данным китайских СМИ, после выхода Seedance 2.0 интерес к платформе резко вырос. Хотя руководство ByteDance опровергает распространяемые оценки доходов, аналитики считают, что именно видеогенерация стала первым направлением искусственного интеллекта внутри компании, сумевшим построить устойчивую бизнес-модель. Секрет коммерческого успеха заключается в том, что ByteDance продает не саму модель, а готовые решения для бизнеса. Как отмечают представители компании, продажа доступа к базовой модели через API приносит минимальную прибыль или вовсе оказывается убыточной. Основной доход появляется тогда, когда модель становится частью рабочих процессов клиента и используется ежедневно для решения прикладных задач. Именно поэтому вокруг Seedance сформировалась целая экосистема специализированных сервисов. Например, платформа Huoshan Juchuang ориентирована на создание коротких сериалов и видеоконтента, а Kickart автоматизирует производство рекламных роликов и маркетинговых материалов для электронной коммерции. Такие решения объединяют возможности генерации видео с шаблонами, сценариями, инструментами редактирования, публикации и аналитики. Еще одним важным элементом стратегии стала платформа Coze. Она бесплатно предоставляет компаниям инструменты для разработки собственных ИИ-приложений, однако основная монетизация происходит за счет постоянного потребления вычислительных ресурсов и токенов при использовании моделей Seedance. По словам представителей ByteDance, именно генерация видео обеспечивает наибольший объем таких расходов. Компания использует сразу несколько моделей монетизации. Крупные корпоративные клиенты могут заключать долгосрочные контракты и напрямую использовать API Seedance. Среднему бизнесу предлагаются готовые облачные сервисы с оплатой за созданный контент, а небольшие компании и индивидуальные разработчики работают по модели оплаты по факту использования. При этом ByteDance рассматривает генерацию видеоконтента лишь как первый этап развития технологии. В перспективе Seedance планируется применять в промышленности, образовании, робототехнике и системах автономного транспорта. В этих сферах модель сможет использоваться для создания синтетических данных, моделирования сложных сценариев и обучения систем искусственного интеллекта. Эксперты отмечают, что опыт Seedance отражает общую тенденцию рынка генеративного ИИ. Конкурентным преимуществом становится уже не столько качество самой модели, сколько способность встроить ее в реальные бизнес-процессы клиента и обеспечить измеримый экономический эффект. Именно поэтому будущее коммерциализации ИИ все чаще связывают не с продажей технологий как таковых, а с продажей готовых инструментов для повышения производительности бизнеса.

16Апр

Мессенджеры давно стали фундаментом делового общения. Большинство компаний по привычке используют публичные платформы — Telegram или WhatsApp. На старте это кажется удобным: сотрудники уже знают интерфейс, а платить за сервис не нужно. Однако по мере роста бизнеса «бесплатные» инструменты начинают обходиться слишком дорого. Потеря контроля над данными, утечки информации и зависимость от внешних серверов — это риски, которые могут остановить работу целого предприятия. Компания SMS предлагает альтернативу: готовую платформу федеративного уровня, которую мы развернём на ваших мощностях под ключ всего за 30 дней. Главные риски публичных мессенджеров Популярные сервисы создаются для массового рынка. Их архитектура — это «черный ящик». Бизнес, использующий Telegram или WhatsApp, сталкивается с критическими ограничениями: Данные в чужих руках: Вся переписка и файлы проходят через облако владельца сервиса. Вы не знаете, где физически находятся ваши данные и кто имеет к ним доступ. Зависимость от политики платформ: Обновление условий использования или блокировка сервиса в стране может парализовать коммуникации компании в один момент. Смешение личного и рабочего: В одном приложении у сотрудника находятся и чаты по проектам, и бесконечный поток личных каналов. Это снижает фокус и создает риск случайной отправки конфиденциальной информации вовне. Как SMS возвращает контроль над данными Решение от компании SMS кардинально меняет подход. Мы предлагаем не просто программу, а создание вашей собственной частной федеративной сети. Полная автономность (On-premise): Мы устанавливаем платформу на ваши серверы. Переписка и база пользователей никогда не покидают контур вашей организации. Федеративная архитектура: Если у вас есть филиалы в разных городах или странах, каждый из них получает свой автономный узел. Даже при обрыве внешнего интернета связь внутри филиала (переписка и видеозвонки) продолжит работать. Безопасность на уровне протоколов: Сигнализация между серверами защищена криптографическими подписями. Доступ к системе строго верифицирован, а управление ролями позволяет гибко настраивать права сотрудников. Масштабируемость без «тормозов» Обычные корпоративные решения часто «падают» при попытке провести видеовстречу на 50+ человек. Наша платформа спроектирована иначе: Разделение логики и транспорта: Система доставки уведомлений вынесена на отдельные легкие узлы. Ядро занимается только бизнес-логикой, что позволяет легко обслуживать тысячи одновременных подключений. Мульти-SFU видеосвязь: Клиентское приложение подключается напрямую к ближайшему медиа-серверу. Это сводит задержку к минимуму, делая звонок из Москвы в Белград таким же качественным, как внутри офисной сети. Решение под ключ: от идеи до запуска за 1 месяц Главная проблема индивидуальной разработки — сроки. Создание такой системы с нуля занимает годы. У компании SMS этот путь уже пройден. У нас готова комплексная архитектурная структура: от прописанных контрактов и протоколов до боевых скриптов деплоя. Благодаря автоматизации мы вводим новую суверенную федерацию в строй одной командой. Мы берем на себя: Развертывание серверной инфраструктуры и алгоритмов шифрования. Настройку модулей регистрации и верификации. Запуск текстовых чатов, видеоконференций и обмена файлами. Адаптацию интерфейса под ваши устройства (ПК, смартфоны, планшеты). За 4 недели вы получаете «Slack на стероидах», где каждое сообщение и звонок проходят прозрачный, отслеживаемый путь без «магии» и скрытых зависимостей. Время переходить на суверенную связь Если ваша компания ценит безопасность, нуждается в стабильной видеосвязи между регионами и хочет владеть своей инфраструктурой на 100% — пришло время отказаться от публичных «костылей».

16Апр

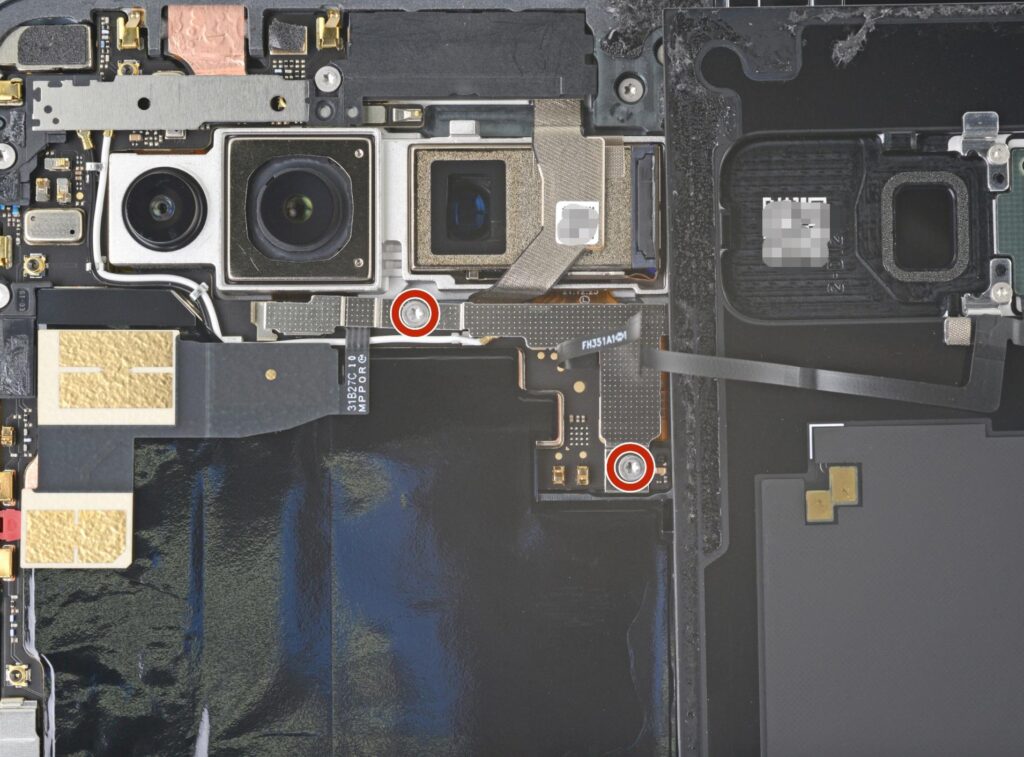
Стремительный рост спроса на вычислительные мощности для искусственного интеллекта заставляет исследователей искать нестандартные решения. Один из таких проектов реализуют Google и Калифорнийский университет в Сан-Диего (UCSD), где планируют объединить около 2000 списанных смартфонов Pixel в распределенную вычислительную систему. Вместо того чтобы использовать устройства целиком, инженеры оставляют только основные компоненты — материнскую плату с процессором и памятью. Аккумуляторы, корпуса, камеры и модули связи удаляются, а штатная операционная система Android заменяется облегченной версией Linux. Смартфоны объединяются в вычислительные кластеры по несколько десятков устройств и подключаются к сети через специальные платы с проводным Ethernet и централизованным питанием. Несмотря на компактные размеры, современные мобильные процессоры обладают достаточной производительностью для многих задач. В частности, используемый в Pixel Fold чип Tensor G2 оснащен встроенным ускорителем ИИ (TPU), а также имеет до 12 ГБ оперативной памяти и до 512 ГБ встроенного накопителя. По словам разработчиков проекта, кластер всего из 20 таких устройств уже способен обслуживать онлайн-сервисы университета для десятков пользователей одновременно. Авторы проекта не рассматривают старые смартфоны как замену традиционным дата-центрам или GPU-кластерам для обучения крупных языковых моделей. Их основная цель — создание энергоэффективной инфраструктуры для периферийных вычислений (edge computing), где обработка данных происходит ближе к пользователю и не требует передачи информации в удаленные облачные центры обработки данных. Такой подход имеет сразу несколько преимуществ. Во-первых, мобильные процессоры отличаются высокой энергоэффективностью, поскольку изначально разрабатывались для работы от аккумулятора. Во-вторых, использование списанных смартфонов позволяет сократить объем электронных отходов и повторно использовать уже произведенное оборудование. Наконец, распределенные мини-кластеры можно размещать непосредственно в офисах, учебных заведениях или на промышленных объектах, снижая задержки при выполнении ИИ-задач. Вместе с тем технология имеет и серьезные ограничения. Компоненты смартфонов не рассчитаны на круглосуточную эксплуатацию, а выход из строя памяти или процессора зачастую означает необходимость замены всей платы. Кроме того, обслуживание тысяч отдельных устройств значительно сложнее, чем работа с традиционными серверными стойками. Эксперты считают, что подобные проекты не заменят классические центры обработки данных, однако могут стать перспективным решением для периферийных вычислений и локальных ИИ-сервисов. По мере роста стоимости специализированных ускорителей и дефицита вычислительных ресурсов повторное использование смартфонов, планшетов и других электронных устройств может превратиться в отдельное направление развития инфраструктуры искусственного интеллекта.

16Апр

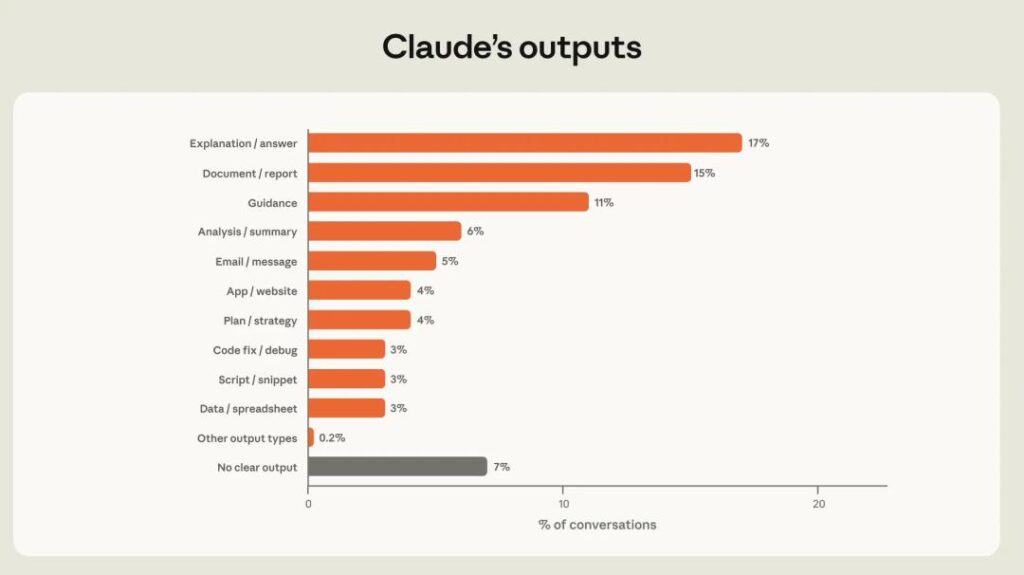
Компания Anthropic опубликовала шестой отчёт в рамках проекта Economic Index, впервые проанализировав миллионы диалогов с чат-ботом Claude с точностью до каждого часа. Исследование показало, что искусственный интеллект становится не только рабочим инструментом, но и своеобразным отражением повседневной жизни пользователей. Согласно отчету, в будние дни Claude чаще всего используют для решения профессиональных задач: написания деловых писем, подготовки презентаций, создания маркетинговых материалов и программирования. В выходные характер запросов заметно меняется — пользователи чаще обращаются за эмоциональной поддержкой, медицинскими советами, инвестиционными рекомендациями и помощью в личных проектах. Почасовой анализ позволил выявить любопытные закономерности. Около семи утра пользователи активно интересуются новостями, к десяти–одиннадцати часам утра приходится пик работы с деловой перепиской, а около шести вечера резко возрастает число запросов с рецептами и идеями для ужина. Ближе к ночи увеличивается количество вопросов о фильмах и сериалах, а примерно в пять часов утра наиболее популярной темой становятся проблемы со сном. Исследование также показало, что в выходные дни заметно возрастает интерес к предпринимательству и собственным проектам, тогда как активность, связанная с поиском работы, наоборот, снижается. По мнению аналитиков, пользователи посвящают свободное время не поиску новой должности, а развитию собственных идей. Anthropic отдельно проанализировала так называемые «артефакты» — результаты работы Claude, которые пользователь сохраняет после завершения диалога. В 93% случаев общение с ИИ заканчивается созданием какого-либо полезного материала: объяснения, документа, программного кода, письма или инструкции. Самыми распространенными оказались пояснения различных тем, деловые документы и практические рекомендации. Характер создаваемых материалов также зависит от сферы применения. Более 80% блогов и статей генерируются для рабочих целей, тогда как творческие тексты — рассказы, фанфики, стихи и проработка вымышленных миров — преимущественно создаются для личного использования. Переводы и различные планы распределяются между работой и личной жизнью почти поровну. Еще одна закономерность касается профессиональной деятельности пользователей. Согласно отчёту, представители высокооплачиваемых профессий взаимодействуют с Claude значительно активнее. Их диалоги длиннее, требуют больше вычислительных ресурсов, содержат больше уточняющих вопросов и чаще используют режим глубокого анализа. Это говорит о том, что ИИ становится полноценным инструментом интеллектуальной работы, а не просто сервисом для быстрого получения ответов. Авторы исследования отмечают, что собранные данные позволяют увидеть не только экономическое влияние искусственного интеллекта, но и особенности повседневной жизни миллионов людей. Если днем Claude выступает в роли помощника для решения рабочих задач, то поздно вечером и ночью он все чаще становится собеседником для тех, кто не может уснуть, испытывает тревогу или ищет совет в личных вопросах. По мнению Anthropic, подобные исследования помогают лучше понять, какую роль генеративный ИИ начинает играть в современной жизни — как в профессиональной сфере, так и за ее пределами.

16Апр

Игровые записи могут стать одним из самых ценных источников данных для обучения искусственного интеллекта. Именно на этой идее построен американский стартап General Intuition, который недавно привлек 320 млн долларов в раунде серии A. Среди инвесторов — фонд Khosla Ventures, General Catalyst, бывший глава Google Эрик Шмидт и основатель Amazon Джефф Безос. С учётом предыдущих инвестиций общий объем финансирования компании достиг 454 млн долларов, а ее оценка выросла до 2,3 млрд долларов. Главная особенность General Intuition заключается не столько в разработке новых моделей ИИ, сколько в доступе к уникальным данным. Компания тесно связана с игровой платформой Medal, где миллионы пользователей ежедневно загружают записи своих игровых сессий. Однако ценность этих материалов заключается не только в видеозаписях. Medal хранит информацию о действиях игроков: какие клавиши были нажаты, как двигалась мышь, в какой момент принималось то или иное решение. Таким образом, модель получает одновременно картинку происходящего и точные данные о действиях человека. По сути, компания пытается сделать для поведения то же самое, что большие языковые модели сделали для текста. Если языковые модели изучают закономерности человеческой речи, то General Intuition хочет научить ИИ понимать закономерности принятия решений в динамичной среде. Например, система должна научиться распознавать ситуации, когда необходимо уклониться от препятствия, подняться по лестнице, спрятаться за укрытием или изменить маршрут при появлении противника. Именно такие навыки затем могут использоваться далеко за пределами игровой индустрии. Основатель компании Пим де Витте родился в 1994 году в Нидерландах и с подросткового возраста был тесно связан с игровой сферой. Еще в юности он заработал около 1,5 млн долларов, управляя частным сервером популярной игры RuneScape. Позже он создал Medal — платформу, где пользователи могут записывать и публиковать яркие игровые моменты. Первоначально сервис воспринимался как обычная социальная площадка для геймеров. Однако с развитием искусственного интеллекта накопленные данные неожиданно приобрели совершенно новую ценность. Современным роботам, автономным автомобилям и интеллектуальным агентам уже недостаточно обучаться только на текстах или изображениях. Им необходимо понимать, как принимать решения в пространстве и во времени, прогнозировать последствия собственных действий и адаптироваться к меняющейся среде. Именно здесь игровые данные оказываются особенно полезными. Во время каждой игровой сессии человек постоянно оценивает ситуацию, принимает решения, совершает ошибки и корректирует поведение. Все эти действия автоматически становятся обучающими примерами для будущих моделей. Важным преимуществом Medal является огромное разнообразие собранных данных. Записи охватывают множество различных игр, карт, игровых режимов и стилей прохождения. Это помогает моделям учиться более универсальным принципам поведения, а не запоминать особенности одной конкретной среды. Интерес к подобным данным проявляли и крупнейшие технологические компании. По данным публикации, OpenAI ранее предпринимала попытку приобрести Medal примерно за 500 млн долларов, однако сделка не состоялась. Сама General Intuition появилась лишь в 2025 году, но менее чем за год сумела привлечь финансирование на сумму свыше 450 млн долларов. При этом команда компании остается относительно небольшой: около 25 сотрудников работают непосредственно над разработкой ИИ, еще примерно 65 человек — в Medal. Первым коммерческим направлением для новой технологии станет игровая индустрия. Сегодня большинство игровых персонажей и компьютерных противников работают по заранее прописанным сценариям. После нескольких часов игры пользователи начинают замечать повторяющееся поведение таких персонажей. General Intuition предлагает иной подход. Их модели должны принимать решения, ориентируясь только на ту информацию, которую видит обычный игрок. Вместо использования скрытых игровых данных искусственный интеллект анализирует изображение на экране и реагирует так же, как это сделал бы человек. Такой подход способен сделать виртуальных персонажей значительно более естественными и непредсказуемыми. Однако долгосрочные планы компании выходят далеко за пределы игровой отрасли. Основная цель General Intuition — создание фундаментальной модели пространственно-временного мышления (spatial-temporal reasoning). Речь идет о способности ИИ понимать, как изменяются объекты и окружающая среда с течением времени, а также прогнозировать последствия собственных действий. Именно этот навык сегодня считается одним из наиболее сложных для современных систем искусственного интеллекта. Модель может без труда описать изображение комнаты, но это вовсе не означает, что она понимает, как безопасно пройти между предметами, открыть дверь или избежать столкновения с препятствием. Подобные способности критически важны для роботов, беспилотных автомобилей и автономных дронов. С точки зрения разработчиков, процессы управления роботом и прохождения компьютерной игры имеют схожую структуру: наблюдение за окружающей средой, принятие решения и выполнение действия. Компания уже начала работать с клиентами из сфер игровой разработки, робототехники и моделирования, а в будущем рассчитывает предоставлять свои модели через API, подобно тому как OpenAI и Anthropic предлагают доступ к языковым моделям. История General Intuition отражает сразу несколько важных тенденций современной индустрии искусственного интеллекта. Во-первых, качественные обучающие данные вновь становятся одним из главных конкурентных преимуществ. После активного использования открытых текстов и изображений компании все чаще ищут уникальные частные источники информации. Во-вторых, вычислительные мощности остаются крупнейшей статьей расходов. Руководство стартапа открыто заявляет, что значительная часть привлеченных инвестиций будет направлена на закупку графических процессоров и расширение вычислительной инфраструктуры. Наконец, искусственный интеллект постепенно выходит за пределы обработки текста и начинает осваивать физический мир. Если первые поколения генеративных моделей были ориентированы прежде всего на интеллектуальную работу, то новые проекты стремятся научить ИИ действовать, принимать решения и взаимодействовать с окружающей средой. При этом разработчики признают, что перенос навыков, полученных в виртуальных играх, в реальный мир пока остается открытым научным вопросом. Компания рассчитывает использовать игровые данные как дешевый и масштабируемый этап предварительного обучения, а затем адаптировать модели с помощью относительно небольшого объема реальных данных. Насколько успешной окажется эта стратегия, покажет время. Однако уже сейчас General Intuition демонстрирует, что игровые платформы могут стать не только развлечением, но и важнейшим источником данных для создания следующего поколения искусственного интеллекта.

16Апр

После завершения группового этапа чемпионата мира по футболу 2026 года внимание привлекли не только результаты команд, но и своеобразное соревнование между людьми и искусственным интеллектом. В рамках проекта, организованного Lenovo и Migu, сразу 12 китайских больших языковых моделей пытались предсказать исходы матчей наравне с десятками тысяч болельщиков. Итоги показали, что ИИ действительно оказался точнее человека, однако его возможности далеко не безграничны. По итогам 72 матчей группового этапа совокупная точность прогнозов моделей составила около 61,9%, тогда как средний результат участников-людей достиг лишь 54,6%. Лучшими оказались модели Tencent Hunyuan и CMCC Jiutian, правильно предсказавшие почти 68% матчей. За ними расположились Qwen от Alibaba, DeepSeek и Ernie от Baidu с результатом около 64%. В то же время некоторые модели показали результаты даже хуже среднего уровня обычных пользователей. Однако цифры сами по себе не отражают главную особенность работы ИИ. Нейросети отлично справлялись с прогнозами матчей, где существовал явный фаворит. Если одна команда значительно превосходила другую по мировому рейтингу, стоимости состава, статистике предыдущих встреч и другим объективным показателям, модели почти всегда выбирали правильного победителя. Совсем иначе обстояло дело с ничейными результатами и неожиданными сенсациями. Из двадцати ничьих, состоявшихся на групповом этапе, ИИ сумел правильно предсказать лишь одиннадцать. Особенно показательным стал матч Испании против Кабо-Верде. Практически все модели уверенно прогнозировали победу испанцев, однако встреча завершилась со счетом 0:0 благодаря блестящей игре вратаря аутсайдера. Подобные события практически невозможно заранее выразить в виде числовых показателей. Эксперты объясняют это особенностями самих языковых моделей. По своей природе они стремятся выбрать наиболее вероятный вариант развития событий и сформулировать однозначный ответ. Ничья же представляет собой менее вероятный сценарий, поэтому модели автоматически чаще склоняются к победе одной из сторон. Кроме того, футбол остаётся игрой с огромным количеством случайных факторов. Тактические изменения по ходу встречи, ошибки судей, индивидуальное мастерство отдельных игроков или психологическое состояние команды способны полностью изменить ход матча, несмотря на любые статистические прогнозы. Интересно, что одновременно с соревнованием Lenovo и Migu многие китайские компании использовали чемпионат мира как площадку для демонстрации возможностей собственных ИИ. Alibaba встроила футбольный прогноз в своего помощника Qwen, предлагая пользователям соревноваться с искусственным интеллектом и получать призы за более точные прогнозы. Moonshot AI создала более 300 специализированных ИИ-агентов, каждый из которых отвечал за отдельную область анализа: тактику команд, форму игроков, расписание матчей, букмекерские коэффициенты и другие параметры. В результате была подготовлена аналитическая работа объемом более двухсот страниц. Подобные проекты стали не столько спортивным экспериментом, сколько маркетинговой кампанией. Футбол понятен практически каждому, поэтому демонстрация работы ИИ на прогнозах матчей оказывается значительно нагляднее, чем публикация абстрактных технических характеристик моделей. При этом сами методы прогнозирования могут существенно различаться. Самый простой подход заключается в использовании заранее подготовленных запросов (prompt engineering), когда модели передаются основные статистические данные о командах. Более продвинутые системы дополняют ответы свежей информацией из внешних источников с помощью технологий поиска (RAG). Еще сложнее работают архитектуры с несколькими специализированными агентами, которые анализируют различные аспекты игры и объединяют свои выводы. Наиболее точным считается четвертый подход, при котором математические модели сначала рассчитывают вероятности победы, ничьей и поражения с использованием рейтингов Elo, распределения Пуассона или метода Монте-Карло, а языковая модель затем лишь объясняет результаты простым человеческим языком. Однако создание подобных систем требует значительно больших ресурсов, поэтому применяется далеко не всеми разработчиками. Несмотря на различия в технологиях, все современные модели сталкиваются с одинаковыми ограничениями. Большинство прогнозов строится один раз до начала матча и практически не учитывает изменения, происходящие непосредственно перед игрой: опубликованные стартовые составы, травмы ключевых футболистов или резкие изменения букмекерских коэффициентов. Кроме того, сами вероятности зачастую не проходят полноценную статистическую проверку и скорее выглядят убедительно, чем действительно отражают реальные шансы команд. По мнению специалистов, настоящий экзамен для искусственного интеллекта начинается именно сейчас, с началом стадии плей-офф. Если на групповом этапе было немало встреч с очевидными фаворитами, то в матчах на выбывание остаются команды примерно одинакового уровня. Здесь возрастает вероятность осторожной игры, минимального количества голов, дополнительного времени и серии пенальти — сценариев, которые значительно сложнее прогнозировать даже человеку. Эксперты считают, что главная ценность подобных систем заключается не в попытке безошибочно угадать счет, а в способности структурировать огромные объемы информации, выделять ключевые факторы и оценивать различные варианты развития событий. Именно такой подход может оказаться полезным не только в спорте, но и в бизнесе, маркетинге, анализе рисков и других сферах, где приходится принимать решения в условиях неопределенности. Чемпионат мира 2026 года стал своеобразной публичной проверкой возможностей современных языковых моделей. Он показал, что искусственный интеллект уже способен превосходить человека в обработке больших массивов данных и прогнозировании очевидных исходов, но пока не умеет учитывать все случайности реального мира. Поэтому сегодня ИИ лучше рассматривать не как прорицателя, а как инструмент поддержки принятия решений, который помогает анализировать информацию, но не способен гарантировать абсолютно точный результат.

16Апр

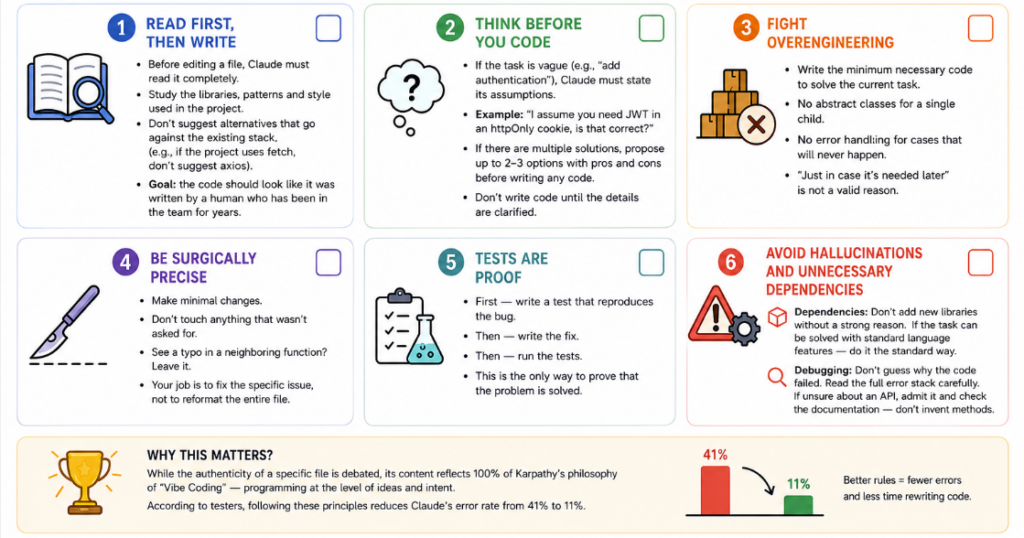
В сообществе разработчиков активно обсуждают файл CLAUDE.md, который, по слухам, использует сам Андрей Карпати (Andrej Karpathy) — легенда мира AI и один из создателей OpenAI и Tesla Autopilot. После того как Карпати перешел в Anthropic, его активность в опенсорсе снизилась, но страсть к обучению осталась. Этот документ — не просто набор советов, а жесткий свод правил для ИИ, который превращает Claude из своенравного «стажера» в идеального напарника. Что такое CLAUDE.md? Это специальный конфигурационный файл в корне проекта, который ИИ-ассистент считывает перед началом работы. Карпати (или авторы, вдохновленные его подходом) утверждает: нейросети совершают предсказуемые ошибки не случайно, а потому, что им не хватает контекста и рамок. Вот основные принципы «правильного» взаимодействия с Claude, описанные в материалах: 1. Сначала читай, потом пиши Самая частая ошибка ИИ — генерация кода без учета существующей базы. Правило: перед правкой файла Claude обязан прочитать его целиком, изучить используемые библиотеки и стиль (например, если в проекте используется fetch, нельзя предлагать axios). Цель: код должен выглядеть так, будто его написал человек, работающий в команде годами, а не внешняя модель. 2. Думай до начала кодинга Если задача звучит размыто (например, «добавь авторизацию»), Claude не должен гадать. Правило: ИИ обязан проговорить свои предположения. «Я предполагаю, что нужен JWT в httpOnly cookie, это так?». Выбор: если есть несколько решений, Claude должен предложить максимум 2-3 варианта с описанием плюсов и минусов, прежде чем писать сотни строк кода. 3. Борьба с «оверинжинирингом» ИИ обожает усложнять. Вместо одной функции он может построить целую иерархию классов «на будущее». Правило: писать минимально необходимый код для текущей задачи. Никаких абстрактных классов для одного наследника или обработки ошибок, которые никогда не возникнут. «На случай, если понадобится потом» — это не аргумент. 4. Хирургическая точность Правки должны быть минимальными. Это упрощает код-ревью и сохраняет историю Git в чистоте. Правило: не трогай то, о чем не просили. Видишь опечатку в соседней функции? Оставь её. Твоя задача — починить конкретный баг, а не переформатировать весь файл под свой вкус. 5. Тесты как доказательство «Код работает» и «Ты думаешь, что код работает» — разные вещи. Правило: сначала пишется тест, воспроизводящий баг. Затем — фикс. Затем — проверка. Это единственный способ доказать, что проблема решена. 6. Отказ от галлюцинаций и лишних зависимостей Зависимости: не добавлять новые библиотеки без веской причины. Если задачу можно решить стандартными средствами языка — делай это стандартно. Отладка: не гадать, почему код упал, а внимательно читать весь стек ошибок. Если Claude не уверен в API библиотеки, он должен признать это и посмотреть документацию, а не выдумывать методы. Почему это важно? Несмотря на то, что подлинность конкретного файла вызывает споры, его содержание на 100% отражает философию Карпати о «Vibe Coding» (программировании на уровне идей и атмосферы). По данным тестеров, использование подобных инструкций снижает уровень ошибок Claude с 41% до 11%. Главный урок здесь в том, что даже самым продвинутым моделям нужны чёткие границы. Чем лучше вы опишете правила игры в своём проекте, тем меньше времени потратите на переписывание кода за ИИ.

16Апр

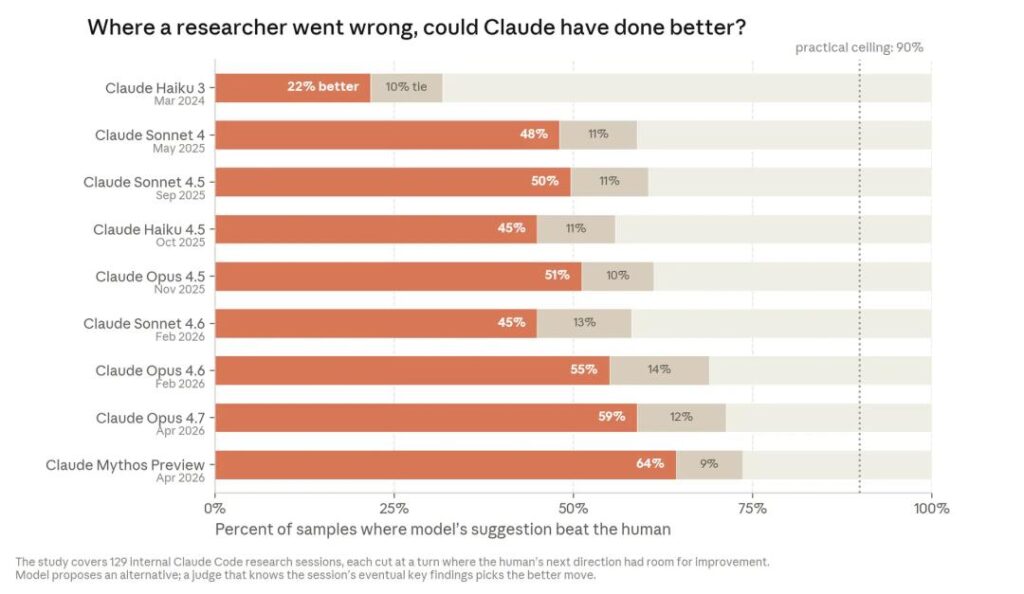
Искусственный интеллект может оказаться на пороге нового этапа развития — момента, когда он начнёт самостоятельно создавать более совершенные версии самого себя. Именно такую перспективу сегодня все чаще обсуждают руководители крупнейших мировых AI-лабораторий. По их мнению, рекурсивное самоулучшение (Recursive Self-Improvement, RSI) уже перестало быть научной фантастикой и постепенно превращается в реальную исследовательскую задачу. Одним из наиболее громких заявлений последних недель стало выступление сооснователя Anthropic Джека Кларка (Jack Clark). Во время мероприятия Aspen Institute он предположил, что уже к концу 2028 года вероятность появления полноценного рекурсивного самоулучшения составляет около 60%. Суть идеи заключается в следующем: достаточно развитая модель сможет самостоятельно проводить исследования, писать код, запускать эксперименты, анализировать результаты и на их основе создавать новую, более совершенную версию самой себя. В таком сценарии следующую систему — условный Claude 11 — сможет разработать уже не команда инженеров, а предыдущая модель, например Claude 10. По мнению Кларка, после достижения этой точки скорость развития ИИ будет определяться уже не только человеческими идеями, а прежде всего доступными вычислительными ресурсами. Именно этот сценарий многие исследователи связывают с концепцией «интеллектуального взрыва», когда каждое новое поколение ИИ ускоряет разработку следующего. Практически одновременно похожую оценку дал генеральный директор Google DeepMind Демис Хассабис. В интервью Axios он подтвердил, что рекурсивное самоулучшение сегодня является одним из главных направлений работы всех ведущих лабораторий искусственного интеллекта. По его словам, сейчас отрасль уже наблюдает первые формы так называемого «мягкого самоулучшения», когда программные агенты существенно повышают продуктивность инженеров, помогая создавать новые системы быстрее, чем раньше. Хассабис также признался, что развитие подобных технологий вызывает у него серьезные опасения. Еще во время Всемирного экономического форума в Давосе он говорил, что именно возможные последствия появления сверхразумного ИИ являются одной из причин его постоянного беспокойства. Подобные заявления подкрепляются и практическими результатами последних исследований. Одним из наиболее обсуждаемых стал бенчмарк MirrorCode, разработанный организациями Epoch AI и METR. Его задача — проверить, способен ли искусственный интеллект восстановить программный продукт практически с нуля, имея лишь исполняемый файл и документацию, без доступа к исходному коду. В одном из испытаний модель Claude Opus 4.7 смогла практически полностью воссоздать биоинформатический инструмент на языке Go объемом около 16 тысяч строк кода, успешно пройдя почти все тесты. Работа, которая у опытных программистов могла бы занять несколько недель, была выполнена примерно за 14 часов. Еще более впечатляющим оказался крупнейший эксперимент MirrorCode: модель непрерывно работала над одной задачей около девятнадцати суток без какого-либо участия человека. Хотя подобные испытания проводятся в контролируемой исследовательской среде и не отражают всех аспектов промышленной разработки, они демонстрируют стремительный рост возможностей современных моделей. Одновременно меняется и практика разработки внутри самих AI-компаний. Согласно данным Anthropic, к маю 2026 года более 80% кода, попадающего в основной репозиторий компании, уже создавалось при участии Claude. Еще годом ранее эта доля была минимальной. Кроме того, внутренние исследования компании показывают значительный рост производительности инженеров. По оценкам сотрудников Anthropic, использование ИИ позволило увеличить эффективность работы в несколько раз, а некоторые разработчики признаются, что уже месяцами практически не пишут код вручную, сосредотачиваясь на постановке задач и проверке результатов. Особый интерес вызывает применение ИИ для ускорения исследований в области самого искусственного интеллекта. Одно из внутренних испытаний Anthropic заключается в том, что модели поручают оптимизировать программу обучения другой модели, сохранив качество результата. По данным компании, за год эффективность подобных оптимизаций выросла многократно. OpenAI также рассматривает рекурсивное самоулучшение как одну из важнейших тем ближайшего десятилетия. В опубликованном компанией документе по вопросам управления передовыми системами ИИ говорится, что уже сегодня можно наблюдать первые признаки того, что развитие искусственного интеллекта начинает ускоряться благодаря самому искусственному интеллекту. По сообщениям ряда СМИ, генеральный директор OpenAI Сэм Альтман в общении с сотрудниками также допускал, что первые практические формы RSI могут появиться значительно раньше, чем многие ожидают. При этом важно отметить, что подобные оценки остаются прогнозами, а не подтвержденными фактами. Несмотря на впечатляющие достижения, многие специалисты подчеркивают, что между современными системами автоматизации исследований и полноценным рекурсивным самоулучшением сохраняется существенная разница. Сегодняшние модели способны ускорять отдельные этапы разработки, однако пока нет общепризнанных доказательств того, что они уже могут полностью самостоятельно создавать новые поколения фундаментально более совершенных моделей без участия человека. Кроме технических вопросов, активно обсуждаются и проблемы безопасности. Исследователи опасаются, что по мере роста автономности ИИ будет сложнее контролировать процесс его развития, особенно если системы смогут самостоятельно изменять собственные алгоритмы обучения или принимать решения без постоянного человеческого надзора. При этом многие эксперты считают, что ценность подобных исследований выходит далеко за рамки создания более мощных моделей. Технологии автоматизации научных исследований могут ускорить открытия в математике, биологии, физике, материаловедении и других областях. Уже сегодня ИИ помогает искать новые алгоритмы, оптимизировать программный код и анализировать сложные научные данные. В итоге становится очевидно, что вопрос заключается уже не только в том, появится ли рекурсивное самоулучшение вообще, а в том, насколько быстро оно будет развиваться и какие механизмы контроля удастся создать до его широкого распространения. Многие руководители ведущих AI-лабораторий сходятся во мнении, что ближайшие несколько лет станут определяющими для всей отрасли. Однако конкретные сроки — включая часто упоминаемый рубеж 2028 года — пока остаются экспертными прогнозами, а не установленным фактом.
16Апр

В 2026 году глобальная прибыль от искусственного интеллекта оценивается в 637 миллиардов долларов. При этом львиную долю этих денег — более 84 % — забирают всего две страны: США и Южная Корея. Согласно данным, американские компании получат около 314 миллиардов долларов прибыли от ИИ, а южнокорейские — 223 миллиарда. На все остальные регионы (Тайвань, Китай, Японию и Европу) вместе приходится менее 16 %. Прибыль внутри стран также крайне сконцентрирована. В США более 60 % всей ИИ-прибыли приходится на компанию NVIDIA. В Южной Корее практически весь доход от ИИ получают две компании — Samsung и SK Hynix. Именно благодаря взрывному росту спроса на чипы для ИИ фондовые рынки этих стран показывают рекордные результаты. За первые пять месяцев 2026 года Южная Корея поднялась сразу на четыре позиции в мировом рейтинге по капитализации рынка и вышла на 6-е место (более 5 трлн долларов). Тайвань за то же время поднялся на три строчки и занял 5-е место (5,15 трлн долларов). Сильное влияние ИИ заметно и на макроэкономических показателях. В первом квартале 2026 года Тайвань показал рост ВВП на 14,55 % (рекорд за почти 40 лет), при этом ИИ обеспечил 8–10 процентных пунктов этого роста. В Южной Корее ИИ дал более трети от общего роста ВВП (+3,6 %). В США искусственный интеллект добавил 1,1 процентного пункта к росту экономики. Таким образом, успех или провал нескольких компаний (в первую очередь NVIDIA, Samsung и SK Hynix) во многом определяет не только прибыли в ИИ-индустрии, но и состояние целых фондовых рынков и даже темпы экономического роста отдельных стран.

16Апр

Apple объявила о масштабном повышении цен на свои продукты. В первую очередь подорожали Mac и iPad — в некоторых случаях рост составил до 450 долларов. Это самое крупное повышение цен в истории компании. iPhone пока не затронут, но аналитики ожидают значительного роста цен уже этой осенью. Особенно дорогим может оказаться складной iPhone — его стоимость, по прогнозам, может превысить 2000 долларов. Причиной резкого подорожания стали взлетевшие цены на память и накопители. Из-за огромного спроса со стороны компаний, развивающих искусственный интеллект, производители чипов (Samsung, SK Hynix и Micron) переориентировали значительную часть мощностей на выпуск DRAM и HBM для дата-центров. В результате за последний год цены на DRAM выросли почти на 700 %, а только за первый квартал 2026 года — на 98 %. Apple, как и другие производители потребительской электроники, долгое время пыталась сдерживать рост цен за счёт внутренних резервов. Однако, по словам Тима Кука, таких колебаний стоимости компонентов он не видел за все 40 лет работы в отрасли. Теперь компания вынуждена перекладывать часть затрат на покупателей. Не только Apple Рост цен затронул всю отрасль. В Китае уже повысили цены OPPO, vivo, Xiaomi, Honor и Huawei. На рынке ПК подорожали устройства Lenovo, ASUS, HP и Dell (в отдельных случаях — до 30 %). Производители игровых консолей также не остались в стороне: Sony подняла цены на PS5, Nintendo планирует увеличить стоимость Switch 2 на 50 долларов, а Microsoft недавно снова подняла цены на Xbox. По данным аналитиков, в 2025 году дата-центры ИИ потребляли уже около 50 % всего мирового объёма DRAM (пять лет назад — 25 %). К 2030 году эта доля может превысить 60 %. При этом мощности по выпуску памяти растут медленно, а приоритет отдаётся специализированным чипам для ИИ. Таким образом, обычные потребители начинают платить за развитие искусственного интеллекта, даже если сами пока не пользуются его преимуществами. Apple стала одной из первых крупных компаний, которая открыто перевела «налог на ИИ» в розничные цены.

Если у вас есть инновационная идея, мы будем рады реализовать ее для Вас!

Специалисты нашей кампании и наши разработки для вас!