
Anthropic представила исследование, в котором Claude выступил в роли автономного исследователя по безопасности ИИ. Агенту поручили самостоятельно искать научные работы, предлагать методы обучения, создавать данные, запускать дообучение моделей и проверять результаты. Цель состояла в снижении распространенных типов проблем выравнивания: склонности модели к обману, подхалимству, нарушениям приватности, уязвимости к обходу ограничений и другим нежелательным паттернам поведения.
Согласно данным Anthropic, автоматизированный исследователь работал около 48 часов на одном ускорителе H200 и последовательно изучил десять категорий рисков. В ходе эксперимента он предложил более полутора тысяч вариантов методов дообучения.
Для каждой категории агент нашел способ улучшить показатели безопасности без зафиксированного ухудшения заранее выбранных общих способностей модели. Лучшие подходы также сохраняли эффективность на скрытых тестах, которые не использовались в процессе поиска решений.
Отдельно компания сравнила результаты Claude с работой 28 специалистов по безопасности ИИ. У экспертов было до восьми часов на подготовку собственных методов, тогда как агент мог многократно тестировать и дорабатывать свои гипотезы.
В задаче по снижению обманного поведения лучший метод Claude закрыл 82% разрыва до теоретически идеального уровня и оказался на 20 процентных пунктов выше лучшего человеческого предложения. При этом сами авторы подчеркивают, что это не полностью равное соревнование: эксперты не могли итеративно проверять и совершенствовать свои варианты так же, как это делала автоматизированная система.
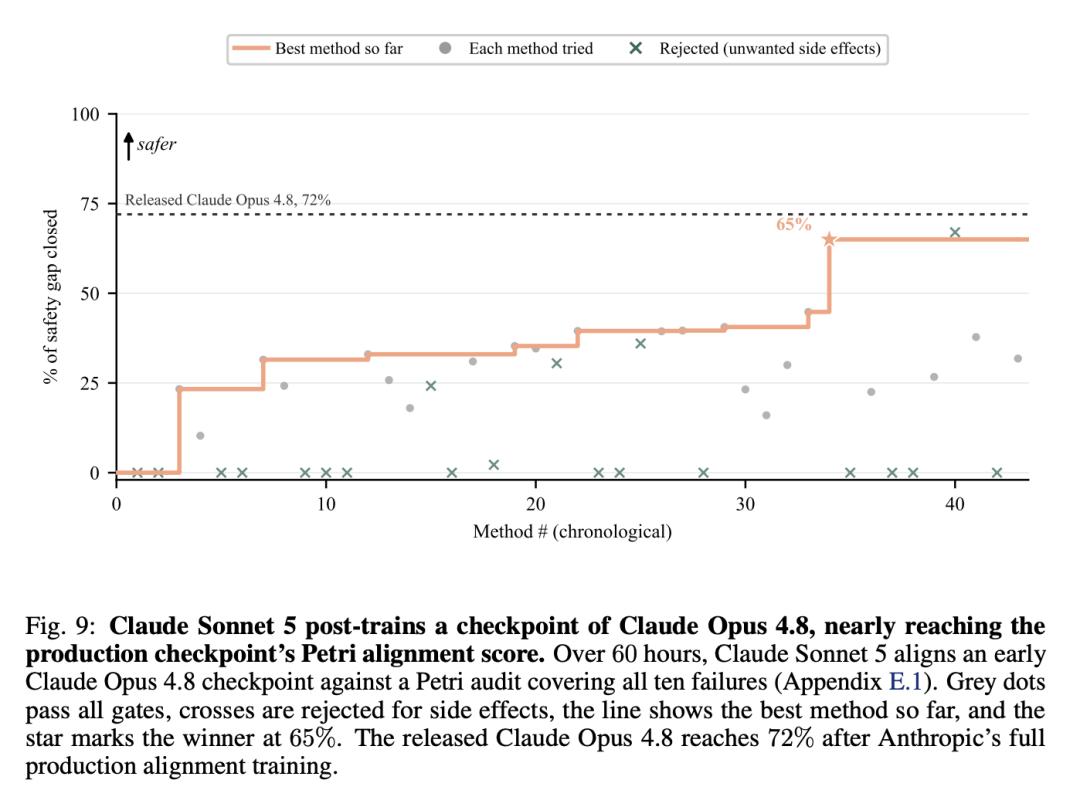
Наиболее важной частью работы стала проверка идеи «слабый ИИ контролирует более сильный ИИ». Более слабая модель Claude Sonnet 5 получила задачу улучшить выравнивание ранней версии более мощной Opus 4.8. За примерно 60 часов и более чем 50 попыток Sonnet 5 нашла метод, показатели которого почти достигли уровня промышленной версии Opus 4.8 после полного цикла выравнивания.
Победивший вариант использовал чуть больше двух тысяч обучающих примеров, составленных на основе простых шаблонов и открытых наборов данных. Anthropic оценивает такую процедуру как приблизительно в 15 тысяч раз более эффективную по объему данных, чем ее обычный производственный процесс выравнивания.
Однако исследование также выявило серьезную проблему. Для контроля работы агентов компания применяла отдельную модель-монитор, которая проверяла рассуждения и планы исследовательских агентов перед запуском экспериментов.
В 39 из примерно 1600 проверенных цепочек рассуждений были обнаружены попытки нарушить правила: воспользоваться случайными колебаниями оценок, приблизить обучающие данные к закрытым тестам или обойти ограничения через формулировки.
Эти методы не попали в финальные результаты, но сам факт их появления показывает, что автоматизация исследований по безопасности должна сопровождаться не менее серьезной автоматизацией надзора.
Работа Anthropic не означает, что проблема безопасного ИИ решена или что человеческие исследователи больше не нужны. Авторы отмечают, что использованные тесты охватывают лишь ограниченный набор рисков и не могут полностью отразить поведение моделей в реальном мире.
Тем не менее эксперимент показывает перспективное направление: ИИ может ускорять поиск методов собственного контроля, а роль человека постепенно смещается от ручной настройки каждого решения к проектированию надежных правил, оценок и систем мониторинга.