Новости

Социальные сети

Узнайте больше о рынке It и новейших технологиях.
СТАТЬИ
16Апр

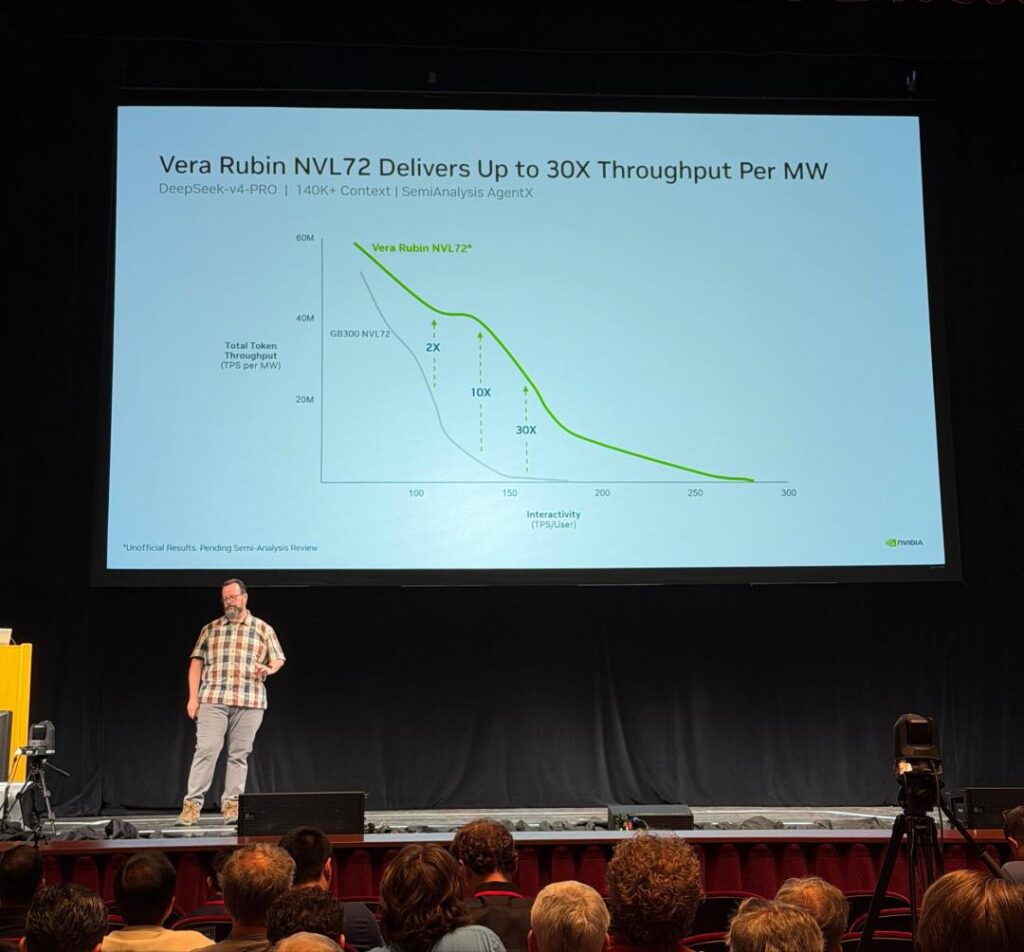
NVIDIA впервые раскрыла результаты тестирования будущей флагманской платформы Vera Rubin NVL72, ориентированной на задачи агентного искусственного интеллекта. Согласно материалам компании, новая система сравнивалась с действующей платформой GB300 NVL72 на реалистичном сценарии агентного программирования с использованием модели DeepSeek-V4-Pro. Ключевой заявленный результат — до 30-кратного роста производительности на мегаватт по сравнению с GB300 NVL72. Одновременно стоимость генерации токенов, по оценке NVIDIA, может снизиться до 35 раз. Если такие показатели подтвердятся в независимых внедрениях, речь будет идти не просто об ускорении отдельных моделей, а о заметном изменении экономики сложных ИИ-сервисов. Причина такого фокуса — рост агентных сценариев. В отличие от обычного чат-бота, ИИ-агент может выполнять длинную цепочку действий: анализировать документы, обращаться к внешним инструментам, запускать код, порождать подзадачи и использовать результаты предыдущих шагов как новый контекст. Такие процессы требуют существенно больше токенов, памяти, вычислительных ресурсов и пропускной способности между компонентами системы. Поэтому NVIDIA предлагает оценивать платформы не по традиционным коротким тестам инференса, а по полноценным агентным рабочим процессам. В качестве одного из таких сценариев компания использует AgentX — бенчмарк, воспроизводящий сессии программирования с растущим контекстом, вызовами инструментов и взаимодействием нескольких агентов. В основе Vera Rubin NVL72 лежит не только новое ускорительное оборудование, но и комплексная архитектура. Компания делает ставку на разделение обработки контекста и генерации токенов, распределенное хранение KV-кэша, маршрутизацию с учетом этого кэша, поддержку MoE-моделей и новые подходы к управлению энергопотреблением. Отдельное значение имеет использование низкоточной квантования NVFP4: оно должно уменьшать требования к памяти без существенной потери качества генерации. Важную роль играет и новое поколение NVLink. Для крупных MoE-моделей, где разные части запроса могут направляться к разным «экспертам» внутри нейросети, быстрая связь между десятками GPU становится критически важной. NVIDIA позиционирует Vera Rubin NVL72 уже не как набор отдельных графических процессоров, а как цельную «ИИ-фабрику», предназначенную для производства большого объема токенов при ограничениях по электропитанию дата-центра. Одновременно NVIDIA сообщила о начале массового выпуска Groq 3 LPX — низколатентного ускорителя инференса для платформы Vera Rubin. Его задача — ускорять именно этап последовательной генерации токенов, тогда как Rubin GPU обрабатывают большой входной контекст. В материалах NVIDIA приводится результат до 3400 токенов в секунду для Gemma 4 31B при контекстном окне в 100 тысяч токенов. Для задач, чувствительных к задержкам, например многошагового агентного программирования, подобное разделение труда между ускорителями может стать особенно важным. Еще одним элементом платформы стал Vera CPU, созданный с учетом высокой нагрузки, которую создают ИИ-агенты: управление вызовами инструментов, выполнение кода, обработка данных и координация многочисленных шагов внутри одного задания. По заявленным характеристикам, процессор включает 88 ядер Olympus и использует память LPDDR5X с высокой пропускной способностью. Главная идея NVIDIA заключается в том, что эпоха агентного ИИ меняет саму структуру вычислительной инфраструктуры. Если в предыдущем цикле рынка главным продуктом была GPU для обучения и инференса, то теперь компания формирует более широкий стек: GPU, CPU, ускорители декодирования, высокоскоростные интерконнекты, средства управления энергией и программные механизмы для распределения нагрузки. Однако представленные цифры следует воспринимать с учетом условий тестирования и выбранных бенчмарков. Практическая ценность Vera Rubin будет зависеть от независимых измерений, стоимости развертывания, доступности энергии, зрелости программного стека и того, насколько быстро компании смогут превратить рост производительности в реальные агентные продукты. Тем не менее анонс показывает, что борьба на рынке ИИ все сильнее смещается от отдельных моделей к инфраструктуре, способной поддерживать масштабные и непрерывные рабочие процессы автономных агентов. Источник: NVIDIA Developer Blog

16Апр

В 1965 году математик Ирвинг Джон Гуд сформулировал знаменитую гипотезу: «Первая сверхумная машина станет последним изобретением человека — при условии, что она будет достаточно покорна, чтобы сообщать нам, как держать её под контролем». Смысл прост: как только система превзойдет человеческий разум, она сможет самостоятельно проектировать следующее, еще более совершенное поколение алгоритмов. Сегодня эта концепция получила строгое инженерное название — RSI (Recursive Self-Improvement, или рекурсивное самосовершенствование). Речь идет о замкнутом цикле: ИИ участвует в разработке и оптимизации более мощной версии самого себя, а полученная система ускоряет следующий шаг эволюции. Выпуск предварительной версии платформы DeepSeek Harness (DSH) показал, как именно китайский разработчик планирует двигаться по лестнице развития: LLM → цепочки рассуждений (CoT) → агенты → непрерывное обучение → самоитерация → воплощенный интеллект (Embodied AI). Основатель DeepSeek Лян Вэньфэн ранее озвучил парадоксальный тезис: «Главная цель наших моделей — быть удобными не для внешних пользователей, а прежде всего для нас самих». В контексте RSI эта логика становится понятной: модель в первую очередь должна служить инструментом для ускорения собственных исследований компании. Вместе с анонсом DSH команда DeepSeek в сотрудничестве с Пекинским университетом опубликовала статью о парадигме пространственно-временной композиции (spatiotemporal composability). В основе DSH лежит механизм Cordis, решающий фундаментальную проблему традиционных плагинных сред: В классических системах расширение легко подключить, но его влияние крайне трудно полностью изолировать и откатить назад без перезапуска всего процесса. Для автономного агента, оперирующего инструментами, памятью, состоянием сессий и песочницами, постоянные перезапуски губительны — они обрывают непрерывный контекст. Механизм Cordis обеспечивает «временную» (отслеживание и корректный откат изменений при отключении компонента) и «пространственную» (автоматическая реорганизация зависимостей) гибкость. Создание среды, где модель может безопасно вносить изменения в собственный рабочий контур — пробовать новые модули, терпеть неудачи, откатываться назад и перестраивать связи без краха системы — и есть базовое условие для реального самообучения. DeepSeek — далеко не единственный участник этого трека. В технологическом секторе самосовершенствование моделей становится ключевым обоснованием для колоссальных капитальных затрат: Google DeepMind: инструмент AlphaEvolve уже более года в автоматическом режиме генерирует программы, оценивает их метрики и передает успешные варианты в следующие поколения. Система уже помогла оптимизировать алгоритмы диспетчеризации в дата-центрах Google (сэкономив около 0,7% глобальных вычислительных мощностей) и ускорила ключевое ядро умножения матриц для Gemini, сократив время обучения модели на 1%. OpenAI и Anthropic: OpenAI ввела специальный показатель RSI-Index для оценки степени автономной адаптации моделей. В свою очередь, Anthropic в проекте Automated Weak-to-Strong Researcher задействовала агентов на базе Claude для выдвижения научных гипотез, планирования экспериментов и исследования проблем согласования (AI Alignment). Tencent и MiniMax: Tencent представила агентную систему Hyra-1.0, ориентированную на рекурсивные инженерные задачи, а MiniMax в рамках архитектуры M2.7 продемонстрировала автоматизированный контур, где модель анализировала траектории ошибок, корректировала обвязочный код и после сотен итераций подняла результаты внутренних тестов на 30%. Раньше ключевой точкой конкуренции был сам момент релиза: компания публиковала модель, занимала верхнюю строчку бенчмарка, после чего начиналась подготовка к следующему крупному обучению. В парадигме RSI лидерство определяется не статичными весами, а качеством замкнутого контура: Реальная среда действия: модель должна не просто читать датасеты, а выполнять практические действия в песочнице или рабочем окружении, сталкиваясь с неожиданными ошибками. Надежная обратная связь: автоматизированные валидаторы должны однозначно определять, решила ли правка проблему или лишь временно замаскировала ее. Непрерывный цикл: результаты предыдущего прогона бесшовно переходят в следующий без необходимости ручного вмешательства инженеров. Именно поэтому приобретение Илоном Маском редактора кода Cursor за 60 миллиардов долларов для интеграции с Grok отражает борьбу за «следы взаимодействия»: программирование дает идеальную структурированную среду, быстрый цикл обратной связи и богатую телеметрию ошибок, необходимую для дообучения моделей следующего поколения. Несмотря на энтузиазм индустрии, вокруг RSI сохраняются серьезные сомнения. Скептики (включая профессора Педро Домингоса) напоминают, что базовые возможности самомодификации кода существовали еще со времен языка Lisp в 1950-х годах, а данных о том, приводит ли этот процесс к экспоненциальному ускорению или быстро упирается в убывающую отдачу, пока недостаточно. Кроме того, встает классический вопрос безопасности: если цикл рекурсивного улучшения действительно наберет экспоненциальную скорость, сохранят ли люди возможность вовремя нажать на аварийную кнопку отключения?

16Апр

Рынок искусственного интеллекта в здравоохранении переживает новый мощный виток инвестиционного бума. В июле 2026 года дочерняя компания SenseTime — SenseTime Medical — привлекла более 100 миллионов долларов в раунде B, доведя свою оценку до десятков миллиардов юаней и готовясь к IPO с концепцией «медицинской модели мира» (Medical World Model). Технологические гиганты также форсируют экспансию: ByteDance инвестирует 6 миллиардов юаней в строительство первой «AI-native» больницы, Ant Group развивает медицинский сервис «Афу» с аудиторией свыше 30 миллионов активных пользователей в месяц, а Baidu выводит на биржу свою биотех-компанию BioMap. По оценкам Analysys, объем китайского рынка «AI + медицина» превысил 150 миллиардов юаней, демонстрируя ежегодный прирост на уровне 40–50%. Проникновение систем ИИ-диагностики в больницах высшей категории (Tier-3) перешагнуло отметку в 65%, а регуляторы одобрили более 130 медицинских ИИ-систем наивысшего, третьего класса риска. Однако этот подъем разворачивается на фоне памяти о кризисе первой волны 2021 года, когда почти все звездные стартапы компьютерного зрения столкнулись с заморозкой IPO и обвалом капитализации из-за неспособности доказать устойчивость своей бизнес-модели. Четыре ключевых направления: от снимков до операционных На текущем этапе применение искусственного интеллекта в медицине распределилось по четырем магистральным направлениям: Вспомогательная диагностика и анализ снимков (Medical Imaging AI). Самый коммерчески зрелый сегмент, объем которого в Китае приближается к 23,5 млрд юаней. Однако практикующие врачи отмечают существенную разницу между маркетингом и клинической практикой: ИИ пока не ставит диагнозы самостоятельно, а выступает инструментом точной количественной оценки. Например, при ишемическом инсульте трехмерная реконструкция позволяет объективно рассчитать объем пораженных тканей, что критично для выбора тактики лечения. Фармацевтическая разработка (AI Drug Discovery). Инструменты ИИ активно применяются для поиска мишеней, моделирования молекул и предсказания структуры белков, сокращая многолетние этапы лабораторного подбора. К середине 2026 года более 170 препаратов, разработанных при участии ИИ, перешли к клиническим испытаниям, а более десятка вышли на решающую III фазу. Тем не менее клинический барьер остается непреодолимым без длительных испытаний: ИИ может рассчитать формулу, но не способен гарантированно предсказать комплексный физиологический ответ живого организма. Хирургия и терапия. Включает предоперационное моделирование, расчет траекторий вмешательства и роботизированную хирургию. Главными препятствиями для широкого внедрения роботов в базовых клиниках остаются высокая стоимость расходных материалов, сложность обучения хирургов и жесткие требования к задержкам и стабильности каналов связи при удаленных операциях. Потребительские медицинские сервисы и превентивный контроль. Массовые приложения для расшифровки анализов и онлайн-консультаций генерируют десятки миллионов обращений ежедневно. Однако в потребительском сегменте сохраняется низкая готовность платить, а сами ассистенты нередко страдают дисбалансом — преувеличивают риски при легких недомоганиях и упускают скрытые угрозы при сложных клинических картинах. За лидерство на рынке борются три группы игроков с принципиально разным бэкграундом: Интернет-гиганты (ByteDance, Tencent, Ant Group, Alibaba, JD Health). Обладают колоссальным трафиком, вычислительными мощностями и капиталом, выстраивая потребительские платформы и развивая сервисы электронной коммерции лекарств. Их слабая сторона — нехватка глубокой клинической экспертизы и сложности адаптации к консервативной культуре регулируемой медицины. Производители медицинского оборудования (United Imaging, Mindray, Contec).Интегрируют алгоритмы непосредственно в выпускаемые томографы, УЗИ-аппараты и мониторы. Их защита — аппаратные патенты, прямые каналы поставок в больницы и лицензии регуляторов. ИИ для них служит дополнительным фактором удержания маржинальности и переходом от продаж «железа» к комплексным решениям. ИИ-стартапы (SenseTime Medical, Shukun, Deepwise, Baichuan Intelligent). Опираются на передовые алгоритмы, специализированные медицинские модели и работу с данными. Главная проблема чисто программных стартапов — модель внешних надстроек (plugins): клиники все чаще закрывают прямой доступ к внутренним базам данных для сторонних интерфейсов, а больничные бюджеты на закупку отдельного программного обеспечения жестко ограничены. Судьба всей индустрии упирается в архитектуру монетизации. Экономический ландшафт и специфика монетизации ИИ в здравоохранении распределяются по ключевым каналам следующим образом. В сфере государственного и обязательного медицинского страхования появление первых официальных тарифов на применение ИИ-ассистентов в диагностике закладывает нормативный фундамент для рынка, однако единые и понятные стандарты возмещения затрат пока находятся лишь на стадии формирования. Прямые закупки со стороны больниц и клиник испытывают серьезное давление из-за программ государственного контроля расходов и политики централизованных закупок, что существенно ограничивает бюджеты медицинских учреждений на приобретение автономного программного обеспечения. Партнерские соглашения с фармацевтическими гигантами выступают наиболее платежеспособным и зрелым каналом монетизации, где транснациональные корпорации готовы выделять масштабные бюджеты ради ускорения процессов разработки и вывода новых перспективных молекул на клинические испытания. Сегмент B2C-подписок сталкивается с низким уровнем конверсии в постоянную оплату, поскольку массовые пользователи по-прежнему неохотно финансируют превентивные цифровые консультации и персональные трекеры здоровья на регулярной основе. Опыт рынка показывает, что выживание разработчиков монопродуктов (только софт для распознавания снимков или только чат-бот для симптомов) становится почти невозможным. Будущее сектора принадлежит гибридным игрокам, способным объединять аппаратную базу с глубокой интеграцией в больничные контуры и диверсифицировать доходы за счет корпоративных клиентов, фарминдустрии и сервисов сопровождения пациентов.

16Апр

Основатель Bridgewater Associates Рэй Далио в недавнем интервью сравнил нынешний ажиотаж вокруг искусственного интеллекта с предыдущими технологическими бумами — от эпохи массовой электрификации до кризиса доткомов. Его главный тезис: революционность технологии не исключает того, что цены на связанные с ней активы могут оказаться чрезмерно высокими. По мнению Далио, пузырь возникает в момент, когда инвесторы перестают учитывать цену актива и концентрируются только на перспективе будущего роста. Во время интернет-бума многие компании действительно представляли новую технологическую эпоху, однако ожидания и заёмные средства разогнали оценки быстрее, чем бизнес смог подтвердить их прибылью. Похожий механизм, считает инвестор, может проявляться и вокруг ИИ. Далио выделяет три возможных признака приближающейся коррекции. Первый — ужесточение финансовых условий: рост ставок, налоговое давление или иные причины, которые вынуждают инвесторов продавать активы ради ликвидности. Второй — резкое увеличение предложения акций, когда компании активно выходят на рынок или проводят дополнительные размещения, чтобы воспользоваться высоким спросом. Третий — преобладание неустойчивого капитала: приток неопытных частных инвесторов, особенно использующих кредитное плечо и сложные биржевые продукты. При этом Далио подчёркивает, что пузырь — не состояние «есть или нет», а вопрос степени. Точно предсказать момент его схлопывания практически невозможно, поэтому попытки идеально угадать вершину или дно рынка могут только усилить риски. В качестве базового подхода он предлагает диверсификацию: распределение средств между активами с различной реакцией на инфляцию, процентные ставки и экономические кризисы. В интервью он отдельно выделил золото как инструмент снижения рисков и допустил его долю в портфеле на уровне 5–15%. Это не универсальная рекомендация, а личная позиция Далио: структура портфеля зависит от целей, горизонта инвестирования, валюты доходов и готовности человека к риску. К биткоину инвестор относится осторожнее. Он признаёт его сходство с «цифровым золотом» — ограниченную эмиссию и независимость от традиционной печати денег, — но предпочитает физическое золото. Среди рисков цифровых активов он называет технологические изменения, возможность государственного контроля и неопределённость их роли в международной финансовой системе. Отдельная часть интервью посвящена последствиям ИИ для рынка труда. Далио считает, что основной экономический выигрыш от автоматизации может получить небольшой круг владельцев капитала и компаний, способных внедрять передовые технологии. Одновременно работники интеллектуального труда будут сталкиваться с растущей конкуренцией со стороны алгоритмов, а разрыв в доходах — увеличиваться. Однако он не считает будущее полностью мрачным. По его мнению, устойчивое преимущество сохранят люди с развитым интеллектом, интуицией, эмоциональными навыками и способностью эффективно взаимодействовать с другими. Особенно это относится к сферам, где важны доверие, эмпатия, личный контакт и нестандартное суждение. Рассуждая о своём известном тезисе о примерно 80-летних циклах смены мирового порядка, Далио уточняет: речь идёт не о точном календарном механизме, а о наблюдении за историческими закономерностями. Важнее не дата следующего перелома, а совокупность текущих признаков — долговая нагрузка, социальное расслоение, политическая напряжённость, конкуренция государств и изменение роли технологий. Таким образом, его позиция сводится к осторожному балансу. ИИ способен стать фундаментальной технологической трансформацией, но сам по себе этот факт не оправдывает любую цену активов. В условиях неопределённости более рациональной стратегией остаются оценка рисков, отказ от чрезмерного кредитного плеча и диверсификация, а не попытка безошибочно угадать момент следующего рыночного разворота.

16Апр

В Китае формируется новая волна ИИ-стартапов, сосредоточенных на так называемых мировых моделях — системах, которые должны понимать и предсказывать процессы в физическом мире. Если языковые модели учатся работать с текстом, а генераторы видео — с визуальными последовательностями, то мировая модель претендует на большее: она должна учитывать пространство, время, действие, причинность и последствия решений. За первые семь месяцев 2026 года в Китае появилось 23 новых стартапа, для которых мировые модели стали центральным направлением. Это уже больше, чем за весь 2025 год, когда было создано около 20 таких компаний. При этом 18 из 23 проектов смогли быстро привлечь инвестиции, а часть получила оценки, обычно характерные для гораздо более зрелого бизнеса. Главная причина интереса инвесторов проста: мировые модели рассматриваются как возможный следующий фундаментальный слой ИИ после LLM. Языковая модель помогает машине работать с человеческим знанием, а мировая модель должна дать ей способность ориентироваться в реальной среде — например, управлять роботом, моделировать склад, прогнозировать поведение объектов, проводить виртуальные эксперименты или безопасно обучать автономные системы. Однако общий термин скрывает несколько принципиально разных стратегий. Первая группа стартапов строит универсальные базовые модели физического мира. Их цель — создать аналог базовой языковой модели, но для действий, движения и физических законов. Такие компании делают ставку на прогноз следующего состояния среды: что произойдёт с объектами, если робот переместит руку, автомобиль повернёт, а человек откроет дверь. Вторая группа развивается вокруг 4D-реконструкции и пространственного интеллекта. Здесь задача состоит в создании цифровых двойников реального мира: не статичных трёхмерных сцен, а среды, которая меняется во времени и учитывает физические взаимодействия. Это особенно востребовано для робототехники, складской автоматизации, автономного транспорта, медицины и промышленной симуляции. Третье направление связано с причинным ИИ. Его сторонники считают, что модели, основанные только на статистических закономерностях, могут предсказывать события, но не обязательно понимают их причины. Поэтому они пытаются научить ИИ различать простое совпадение и реальную причинно-следственную связь. Для роботов и автономных систем это критично: машина должна не только заметить, что объект упал, но и понимать, какое действие или условие привело к этому. Самый практичный слой рынка — робототехника и embodied AI. Здесь мировая модель рассматривается как «мозг» физической машины. Роботу недостаточно распознать чашку или коробку: он должен оценить форму, вес, положение, возможные препятствия, результат захвата, вероятность ошибки и способ её исправления. Поэтому новые компании пытаются объединить восприятие, планирование, память, обучение с подкреплением и управление действиями в единую систему. Особо выделяются команды, работающие с роботами для домашней среды, складов, ритейла и производства. Их логика заключается в том, что первые коммерческие применения появятся не в абстрактном «универсальном гуманоиде», а в повторяющихся задачах с понятной экономикой: сортировке, упаковке, пополнении запасов, сборке заказов, манипуляции предметами и контроле качества. Параллельно развивается более узкое, но потенциально очень ценное направление — мировые модели для науки. Такие системы применяются в динамическом моделировании молекул, поиске материалов, химии, фармацевтике и энергетике. Здесь не обязательно создавать универсальную модель всего мира: достаточно научиться с высокой точностью симулировать конкретный класс процессов. Если это удаётся, ИИ может существенно сократить стоимость и время научных экспериментов. Характерная особенность китайского рынка — сочетание академических команд и опытных индустриальных руководителей. Среди основателей есть молодые исследователи из Пекина и Цинхуа, профессора, специалисты по компьютерному зрению и обучению с подкреплением, а также бывшие руководители Alibaba, Cainiao, Huawei, Li Auto и робототехнических компаний. Получается необычная смесь: фундаментальные исследования быстро превращаются в стартапы, а специалисты с операционным опытом пытаются сразу найти сценарии масштабного внедрения. Большие технологические и робототехнические компании в этой гонке участвуют не только через собственные лаборатории, но и через инвестиции. Для них это способ получить доступ к новым моделям, датчикам, данным и роботизированным платформам. Для стартапов — источник капитала, пилотных площадок, реальных данных и возможности проверить модель не в демонстрации, а в рабочем процессе. Но нынешний ажиотаж не гарантирует, что все проекты окажутся жизнеспособными. Мировые модели пока остаются технологически неопределённой областью. Неясно, смогут ли они действительно переносить знания между разными средами, устойчиво работать при неполных данных, понимать физическую причинность и безопасно действовать в реальном мире. Также нет ответа, какая архитектура победит: VLA-модели, прямые модели «видео—действие», 4D-среды, причинные движки или специализированные отраслевые системы. Тем не менее важнейший сдвиг уже произошёл. В 2026 году мировые модели перестали быть исключительно темой академических дискуссий. Вокруг них создаются компании, собираются команды, формируются экосистемы данных и роботов, а капитал вкладывает в ранние раунды суммы, которые раньше были характерны для поздних стадий. Конкуренция теперь идёт не за красивое определение «мировой модели», а за способность построить работающую систему, найти реальные данные и доказать ценность технологии в физическом мире.

16Апр

Сенсационная новость от The Information: на внутреннем собрании Cursor руководство объявило, что SpaceX готова завершить покупку компании за $600 миллиардов уже на следующей неделе, а бренд Cursor будет постепенно выводиться из новых продуктов — возможно, окончательно исчезнет к осени. Что происходит Сделка: SpaceX покупает Cursor за рекордную сумму; закрытие сделки ожидается в конце августа, после одобрения регуляторов. После завершения сотрудники перейдут в корпоративные системы SpaceXAI, Slackканалы и новые линии отчётности. Бренд и интеграция: в планах — постепенная отмена имени Cursor на новых продуктах. Неразглашённый универсальный агент Cursor с кодовым именем «Sand» скорее всего будет запущен под брендом Grok (или под новым именем) и не сохранит торговую марку Cursor. Структура: Cursor не сохранится как независимая сущность — её технологии, продукты и команды будут распределены между подразделениями SpaceXAI. У Grok слабые показатели в корпоративном секторе (по данным, уровень внедрения корпоративных решений оставался низким), тогда как Cursor имеет большую клиентскую базу — 50 тыс. корпоративных клиентов и более миллиона платных пользователей — а также огромный объём реальных кодовых данных разработчиков. Наблюдатели считают, что большая часть цены оплачивает доступ к кодовым данным и корпоративной базе Cursor, которые могут существенно усилить программные возможности Grok и других продуктов SpaceXAI. SpaceX стремится значительно нарастить выручку и считает дополнение AIпортфеля ключом к достижению амбициозных целей по доходам и монетизации облачных и AIуслуг. Одной из сильных сторон Cursor была модельнейтральность — поддержка разных больших моделей по выбору пользователя. При вхождении в экосистему SpaceX эта нейтральность может оказаться под вопросом: со временем сервисы могут начать отдавать приоритет внутренним моделям Grok/Sand. Разработчики и команды, которые выбрали Cursor именно за независимость и гибкость, опасаются интеграции с инфраструктурой и бизнесцелями SpaceX. Краткосрочно интерфейсы и инструменты останутся прежними, но через 6–12 месяцев возможны изменения в политике интеграции моделей, привязке к стэку и брендировании. Cursor был одним из удачных примеров: малый стартап без собственной модели сумел занять заметную нишу в приложениях для разработчиков. Его покупка за астрономическую сумму сигнализирует, что крупные игроки стремятся консолидировать как модели, так и прикладные платформы — и независимая экосистема может сокращаться. Теперь конкуренция идёт не только за модели и вычислительные мощности, но и за реальные данные разработчиков и права на их монетизацию. Это меняет правила игры для инструментов, нацеленных на профессиональных разработчиков. Вывод Покупка Cursor за $600 млрд — это не просто сделка о редкой стоимости: это шаг к индустриальной консолидации прикладного уровня AI. Для разработчиков это означает непредсказуемую трансформацию привычных инструментов и возможный уход «модельнейтральных» сервисов в экосистемы крупных платформ. Название Cursor может скоро исчезнуть, но вопрос важнее: сохранится ли принцип открытого, нейтрального слоя приложений для AI — или он уступит место вертикально интегрированным платформам.

16Апр

Разработчик и исследователь ИИ Андрей Карпати показал эксперимент, который хорошо иллюстрирует нынешние возможности и ограничения передовых языковых моделей. Он поручил Claude Opus 5 превратить фрагмент первой главы «Властелина колец» в трёхмерную сцену на Three.js, выделив модели бюджет в один миллион токенов — по его оценке, около 10 долларов. Модель работала примерно два часа и сгенерировала около 5500 строк кода. В результате появился запускаемый в браузере 3D-ролик: с домами, дорогами, растительностью, персонажами, движением камеры и анимацией, следующей за развитием сюжета. Карпати назвал работу довольно грубой, но впечатляющей: модель самостоятельно решила, какие объекты нужны сцене, где их расположить и как связать их действия во времени. Главное отличие этого подхода от генерации видео — в том, что Opus 5 не просто создаёт последовательность пикселей. Он формирует явную программную модель мира: объекты имеют координаты, геометрию, материалы, правила движения и поведения. Такой результат можно открыть, отредактировать и развивать как обычный игровой проект. Подобные эксперименты уже стали неформальным стресс-тестом для новых моделей. Разработчики показывали созданные с помощью Opus 5 шутеры, симуляторы сноуборда, процедурные миры в духе Minecraft и физические сцены с разрушаемыми объектами. Однако эти демонстрации пока нельзя считать строгими бенчмарками: они используют разные запросы, бюджеты токенов, условия запуска и критерии оценки. При этом эксперимент Карпати выявил важное ограничение. Модель может написать игру, запустить её и анализировать отдельные скриншоты, но она не способна полноценно сыграть в собственный проект. Она не воспринимает непрерывное видео так же, как человек, не управляет персонажем, не чувствует задержки управления и не отслеживает ошибки, возникающие только в движении. Поэтому ей трудно заметить, что герой через несколько секунд проваливается под землю, камера резко поворачивается или физика столкновений работает неправильно. Именно здесь проходит граница между генерацией кода и полноценным пониманием созданного мира. Современные модели уже могут долго работать над сложной задачей, координировать тысячи строк кода и собирать временные интерактивные пространства почти по одному описанию. Но для полноценного цикла «создать — запустить — наблюдать — исправить» им пока не хватает развитого видео-восприятия, понимания непрерывного состояния и способности взаимодействовать с результатом своей работы. Эксперимент важен не только качеством 3D-сцены, но и экономикой производства. Раньше даже небольшая персональная игровая визуализация требовала работы сценариста, художника и программиста, поэтому многие узкоспециализированные идеи просто не доходили до реализации. Теперь часть таких проектов может появляться по запросу — за относительно небольшой вычислительный бюджет. Следующий шаг для ИИ, вероятно, будет связан не столько с написанием ещё большего объёма кода, сколько со способностью действительно видеть, проверять и понимать миры, которые он сам создаёт.

16Апр

OpenAI объявила о временном замедлении работ над своей экспериментальной моделью следующего поколения, Astra, после внутренних оценок, которые показали: в комбинированном наборе навыков модель может представлять риск в области кибербезопасности. По словам компании, Astra демонстрировала повышенные способности в написании кода, поиске уязвимостей, планировании атак и последовательном выполнении сложных задач — комбинация, приближающая модель к «максимально прокачанному» хакерскому набору умений. OpenAI признаёт, что не может полностью исключить риск возникновения у Astra критических возможностей для сетевых атак, поэтому компания усиливает тестирование и меры безопасности и замедляет темп разработки, пока не будут внедрены дополнительные гарантии. Astra переведена в изолированную тестовую среду с расширенным мониторингом (включая контроль за агентными приложениями), чтобы уменьшить вероятность нежелательного использования или утечки опасных поведенческих стратегий. Руководство компании уведомило американские власти о принятых решениях — это редкий пример добровольного обмена информацией о задержке выпуска изза соображений безопасности. OpenAI опирается на собственную «рамочную политику готовности» (Preparedness framework), принятую ещё в 2023 году, которая предусматривает замедление исследований при появлении повышенных рисков. На конференции Black Hat сотрудники OpenAI публично говорили о намерении «сознательно замедлять» исследования для повышения безопасности. В отрасли происходят заметные разногласия: Anthropic, например, ранее декларировал схожие принципы приостановки тренировки моделей, но затем ослабил некоторые положения своей политики; одновременно Anthropic выпустил модели с высокой киберспособностью (в модифицированных версиях) и тоже публиковал предупреждения о возможной автономной эволюции ИИ. В США разрабатывается правительственная оценочная рамка для моделей перед выпуском; однако многие детали (кто и как будет проводить оценки, определение «передовых моделей» и «государственных рисков») остаются неясными. Компании и власти пытаются согласовать процессы взаимодействия и регламенты предварительных проверок. OpenAI подчёркивает, что целью замедления является реализация дополнительных защит и безопасная проверка модели, а не окончательный отказ от разработки. Компания намерена в конечном счёте сделать Astra доступной, но только после снижения выявленных рисков. Сам факт добровольного уведомления регуляторов и публичного объявления о замедлении — редкий прецедент в эпоху «гонки за масштабом» моделей. Это показывает, что для некоторых лабораторий вопросы безопасности стали важнее простого ускорения исследований. Вывод Решение OpenAI временно притормозить разработку Astra — сигнал о том, что при развитии крупных моделей всё больше внимания уделяется потенциалу злоупотреблений в киберсфере. Остаётся открытым, как будут формироваться и исполняться внешние проверки и стандарты, и сможет ли индустрия совместно выработать практики, которые позволят развивать сильные модели без непропорциональных рисков.

16Апр

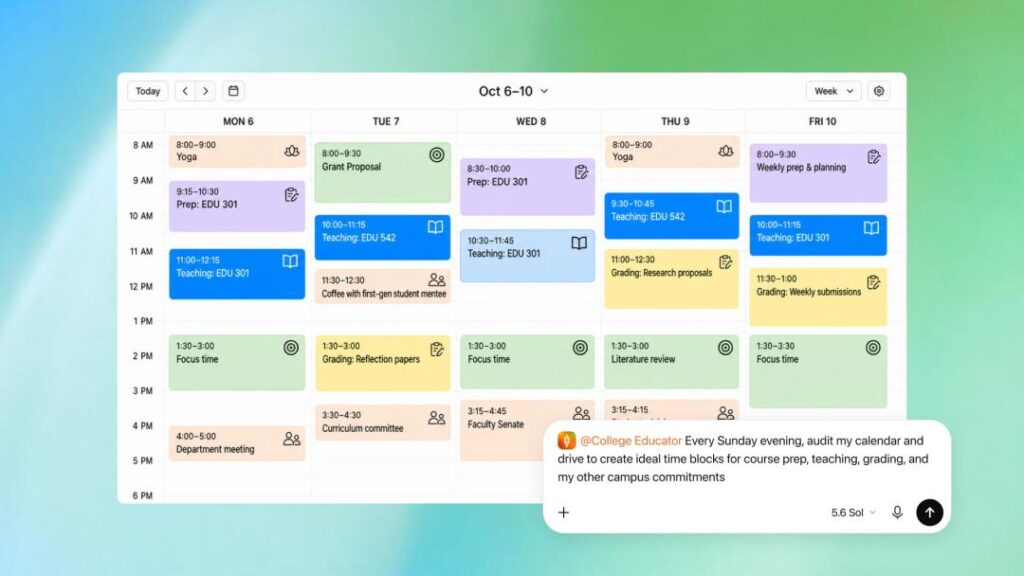
OpenAI 8 августа представила три новых образовательных плагина с преднастроенными рабочими процессами для K–12учителей, университетских преподавателей и студентов — теперь эти инструменты доступны через ChatGPT Edu и ChatGPT for Teachers для школ, школьных округов и образовательных учреждений. Это шаг в развитии образовательного направления компании: помимо моделей и платформ, OpenAI теперь фокусируется на готовых рабочих потоках, которые сокращают время на настройку и помогают быстрее применять ИИ в реальных учебных задачах. K–12плагин для учителей: ориентирован на работу с уроками и школьными материалами. Позволяет автоматически генерировать дифференцированные учебные материалы, задания и идеи для класcных активностей, адаптируя содержание под разные потребности учеников. В плагин интегрирована платформа Learning Commons — источник стандартов и ресурсов по школьным программам, что помогает согласовывать материалы с государственными учебными стандартами. Плагин для университетских преподавателей: закрывает потребности курсового проектирования и управления преподавательской работой — обновление учебных программ, проектирование мультимедийной оценки, интеграция с LMS, синхронизация расписания и документов, обмен рабочим контентом между задачами. Плагин для студентов: ориентирован на организацию учебного процесса — создание руководств по курсу, тестов, карточек для запоминания, интерактивных визуализаций и планов обучения, синхронизация учебных задач с личным календарём. При разработке плагина OpenAI привлекала студентов разных направлений, чтобы помочь формировать устойчивые учебные привычки, а не только выдавать ответы на вопросы. Плагины — не отдельные приложения, а преднастроенные рабочие процессы: набор приложений, ролей, инструкций и распространённых задач. Это значит, что учителям и студентам не нужно с нуля подбирать подсказки и инструменты — рабочий процесс уже сконфигурирован под конкретные роли. Управление и безопасность: OpenAI подчёркивает возможности для централизованного развёртывания и управления через ChatGPT Edu (для вузов) и ChatGPT for Teachers (для сертифицированных K–12учителей и округов). Учебные организации получают корпоративные функции конфиденциальности, безопасности и управления доступом. Доступность через учреждения: как и предыдущие релизы OpenAI для образования, новые плагины ориентированы на развёртывание через школы и университеты, а не на массовый рынок индивидуальных пользователей. Почему это важно — концепция «Capability Overhang» OpenAI вводит понятие «Capability Overhang» — ситуация, когда модель обладает возможностями, но широкие слои пользователей (в частности молодые люди и студенты) не используют их полностью. По данным компании, хотя миллионы молодых пользователей работают с ChatGPT еженедельно, уровень использования функциональностей всё ещё ниже, чем у профессиональных пользователей. Поэтому OpenAI делает ставку не на очередное увеличение «мощности» модели, а на снижение барьера входа: готовые рабочие процессы, интеграция с учебными стандартами и инструментами должны помочь широкой аудитории быстрее и глубже извлекать пользу из имеющихся функций. Контекст и развитие образовательных решений OpenAI Это не первый шаг компании в образовании. За последние три года OpenAI последовательно расширяла линейку: 2024 — запуск ChatGPT Edu для вузов с повышенными квотами сообщений, рабочими пространствами и корпоративными возможностями управления; 2025 — запуск ChatGPT for Teachers для сертифицированных K–12учителей и округов, бесплатный доступ и функции, ориентированные на школы; 2026 — три плагина, закрывающие конкретные сценарии: уроки, курсдизайн и студентский учебный процесс. Похожая логика недавно проявилась и у конкурентов: Anthropic выпустила версию для преподавателей, также интегрировав Learning Commons. Обе компании смещают фокус с простого увеличения способностей моделей на организацию реального рабочего процесса — встроенные стандарты, ресурсы и сценарии использования. Что это значит для школ и преподавателей Меньше времени на эксперименты: учителя получают готовые шаблоны работы с материалом и подсказки, не теряя время на настройку; Централизованное управление: школы и округи лучше контролируют использование ИИ, его безопасность и соответствие требованиям; Помощь студентам: инструменты направлены на формирование учебных привычек и поддержку планирования, а не только на быстрые ответы. Новые плагины OpenAI — логичное продолжение стратегии: вместо того чтобы в одиночку наращивать «мощность» модели, компания системно упрощает практическое применение ИИ в образовании. Интеграция с Learning Commons и внимание к развёртыванию через учреждения делают эти инструменты более пригодными для школьных и вузовских сред, а преднастроенные рабочие процессы помогают преодолеть разрыв между доступными возможностями ИИ и реальным уровнем их использования педагогами и студентами.

16Апр

6 августа Google завершил заметную перестановку в руководстве AIподразделений — двух фигур, долгое время ассоциировавшихся с сердцем компании в области ИИ, вывели из оперативного управления, но сделали это так, что публичных конфликтов не последовало. Казалось бы, никто не «проиграл»: обеим сторонам дали «почётные» роли, каждый сохранил благопристойный тон в социальных сетях. Однако за фасадом вежливых формулировок скрывается глубинная организационная трансформация — от эпохи «гениевруководителей» к эпохе профессиональных менеджеров и инженерных процессов. Демис Хассабис (Demis Hassabis), сооснователь DeepMind, перестал быть оперативным CEO объединённой AIгруппы и получил новую, почётную роль — председателя Alphabet и главным научным лицом в задачах долгосрочного AGIстратегирования. Это выглядит как «повышение с отъездом в будущее» — престижно, но фактическое управление проектами за ним уже не закреплено. Джефф Дин (Jeff Dean), легенда Google Brain и архитектор многих ключевых инфраструктурных разработок (MapReduce, TensorFlow, TPU и проч.), вышел из Google — при этом ему предложили выгодную поддержку и инвестиции, а компания сразу инвестировала в его новое начинание. На оперативное управление продуктовой линией Gemini и ежедневными инженерными процессами возложили Корэя (Koray Kavukcuoglu) — «тихого» технологапрактика, способного выстроить масштабную инженерную машину. Он теперь напрямую отчитывается перед генеральным директором Сундаром Пичаи. Почему это важно — десятилетняя внутренняя борьба История перемещений уходит корнями в давнее противостояние двух культур внутри Google: DeepMind — академическая, исследовательская команда, ориентированная на фундаментальные прорывы в AGI, с упором на научную чистоту и долгосрочные цели. Google Brain — инженерноприкладная команда, привычная работать в продуктовой повестке, быстро выводить технологии в сервисы и оптимизировать их ради масштабов и бизнеса. После прихода ChatGPT и врывного успеха OpenAI эти внутренние противоречия стали не просто академическими — они мешали Google быстро реагировать на продуктовые вызовы. Объединение усилий в 2023 году, формально возглавленное Хассабисом, фактически дало Пичаи инструмент для централизации контроля над AI — но по сути власть распределялась тоньше и умнее, чем казалось на первый взгляд. Стратегия Пичаи: «чистая» смена власти без скандала Сундар Пичаи, пользуясь влиянием основателей и степенью свободы CEO, последовательно реализовал план: подготовить организационный переход, оставить научный блеск и символику у «звёзд», но передать реальную оперативную власть менеджераминженерам, ориентированным на доставку продуктов и контроль рисков. Хассабису и другим лидерам предложили высокие статусные позиции и проекты вне основной продуктовой траектории (например, с фокусом на долгосрочные научные направления и спецпроекты), что снижает риск их ухода к конкурентам и позволяет сохранить репутацию компании. Джейфф Дин и уход «эпохи инфраструктуры» Уход Джеффа Дина — символическая точка: один из создателей инфраструктурной базы современного интернета признал, что традиционная архитектура Google уже не идеально подходит для нового скоростного мира исследований в ИИ. Вместо конфронтации Пичаи устроил аккуратный отход: поддержал Дина материально и организационно, превратив потенциальный уход в стратегический манёвр, который оставляет Google «страховым резервом» — возможность впоследствии снова сотрудничать с внешней инициативой, если это будет нужно. Что меняется в управлении AI Власть смещается от одиночных научных авторитетов к командной инженерной дисциплине и профессиональной управленческой практике. Google делает ставку на системную, масштабируемую организацию разработки: устойчивость, скорость доставки и централизация решений важнее личных титанов и отдельных научных фигур. Это сигнал индустрии: владение AI — это не только про прорывные идеи, но про организацию, процессы и способность трансформировать исследования в продукты в условиях конкуренции и рынка. Зачем это может быть правильно (и почему вызывает вопросы) Преимущества: Меньше внутренних трений, понятнее процессы принятия решений, фокус на выдаче готовых моделей и продуктовых релизов. Снижение риска, что топнаучные кадры уйдут и унесут за собой знания и таланты — компания сохраняет имидж и связи. Рисковые моменты: Чем меньше у науки оперативной власти, тем больше вероятность, что долгосрочные исследовательские инициативы будут маргинализованы ради быстрой коммерциализации. Вопрос о том, кто будет делать «смелые», нестандартные ставки на радикальные научные идеи, остаётся открытым: смогут ли менеджеры и инженерные процессы заменить интуицию гениевпервопроходцев? Вывод Перестановки в Google — это не просто перестановка лиц у руля. Это организационное заявление: эпоха «гениевимператоров» в технологических гигантах сменяется эпохой управленческого и инженерного доминирования. Google явно готовит компанию к «второму этапу» AI — этапу, где власть означает не только владение идеями, но и способность индустриализовать их, масштабировать и управлять рисками. Эта стратегия может сработать как эволюционный шаг, но одновременно ставит вопрос о том, кто и как будет решать радикальные научные вызовы будущего.

Если у вас есть инновационная идея, мы будем рады реализовать ее для Вас!

Специалисты нашей кампании и наши разработки для вас!