Новости

Социальные сети

Узнайте больше о рынке It и новейших технологиях.
СТАТЬИ
16Апр

На фоне гонки за вычислительными мощностями и созданием новых языковых моделей всё заметнее развивается ещё один сегмент ИИ-индустрии — рынок обучающих данных. Компании, которые собирают, размечают, проверяют и поставляют данные для обучения моделей, превращаются из обычных подрядчиков в важных участников разработки ИИ. По оценкам, приведённым в материале Silicon Observation Pro, 28 стартапов в сфере данных для ИИ уже генерируют совокупно около 8,5 млрд долларов годовой выручки, а их общая оценка приближается к 100 млрд долларов. Особенно быстро растут такие игроки, как Scale AI, Surge AI, Mercor и Handshake. При этом рынок остаётся довольно концентрированным: на несколько крупнейших компаний приходится основная часть доходов отрасли. Причина такого роста — изменение роли данных. Раньше наборы данных закупались преимущественно под отдельный цикл обучения модели. Теперь модели обновляются гораздо чаще, а разработчикам постоянно требуется новая, узкоспециализированная и качественная информация. Данные превращаются из разовой «сырьевой закупки» в ресурс, который нужен непрерывно. Одновременно усложняются сами задачи. Если ранние ИИ-модели обучались на относительно простых примерах — например, небольших исправлениях кода, — то современные агенты должны понимать рабочие процессы, работать с несколькими файлами, проверять результаты и самостоятельно выполнять последовательность действий. Это повышает ценность одного обучающего примера: вместо короткой инструкции он может содержать целый сценарий решения реальной задачи. Особый спрос формируется на данные из настоящей профессиональной среды: документы, таблицы, презентации, программный код, медицинские записи, рабочую переписку и бизнес-процессы. Такие сведения сложнее получить из-за требований к конфиденциальности, правам на использование и обезличиванию. Поэтому появляются компании-посредники, которые помогают организациям легально и безопасно превращать внутренние данные в материалы для обучения ИИ. Ещё одно перспективное направление — среды для обучения с подкреплением. Это не статические наборы примеров, а цифровые «тренажёры», где модель может выполнять действия, ошибаться, получать обратную связь и постепенно учиться решать задачи. Например, для офисных ИИ-агентов создаются симуляции Excel, CRM-систем, корпоративных мессенджеров и сервисов поддержки клиентов. В результате рынок постепенно уходит от простой разметки данных. Компании стремятся участвовать во всей цепочке создания ИИ: оценивать слабые стороны моделей, проектировать задания, привлекать профильных экспертов, создавать обучающие среды и подтверждать улучшение результата. Именно поэтому данные для ИИ всё чаще рассматриваются не как вспомогательная услуга, а как самостоятельная технологическая индустрия с очень высокой стоимостью.

16Апр

Смартфоны с ИИ постепенно переходят от набора отдельных функций к модели, в которой искусственный интеллект способен самостоятельно выполнять цепочки действий. Если раньше ИИ помогал улучшить фото, расшифровать звонок или отредактировать текст, то новое поколение устройств стремится стать полноценным цифровым агентом: понять намерение пользователя, составить план и выполнить задачу через разные приложения и сервисы. Например, пользователь может попросить смартфон организовать командировку. Агент проверит календарь, найдёт подходящие билеты и гостиницу, предложит маршрут, поможет заказать такси и забронировать ресторан — без постоянного переключения между приложениями. В такой модели приложения не исчезают, но превращаются из самостоятельных точек входа в наборы функций, которые ИИ вызывает по необходимости. На рынке формируются три основных подхода. Первый — контроль со стороны производителей смартфонов. Huawei, Xiaomi, OPPO, vivo, Honor и другие бренды развивают системных ИИ-ассистентов, интегрированных в операционную систему. Их цель — сохранить контроль над устройством, пользовательским опытом и доступом к сервисам. Одни делают ставку на полный цикл собственной разработки, другие сочетают внутренние технологии с внешними моделями и партнёрскими экосистемами. Второй путь — разделение ролей между производителем устройства и разработчиком модели. В этой схеме смартфон отвечает за интерфейс, безопасность и запуск задач, а языковая модель обеспечивает понимание запроса, планирование и генерацию контента. Такой подход может ускорить внедрение агентных функций, но делает производителя зависимым от внешнего поставщика ИИ. Третья стратегия — создание ИИ-ориентированной операционной системы с нуля. Её сторонники считают, что агент не должен быть ещё одним приложением внутри смартфона. Он должен стать центральным уровнем системы, который управляет коммуникациями, файлами, программами и сервисами. Такой подход выглядит наиболее радикальным, но сталкивается с главной проблемой — нехваткой пользователей, устройств и партнёрских интеграций. Ключевым препятствием остаётся экосистема. Для полноценной работы агенту нужен легальный и стабильный доступ к функциям крупных приложений: мессенджеров, маркетплейсов, платёжных сервисов, такси, доставки и бронирования. Однако суперприложения не всегда готовы открывать свои ключевые возможности внешнему ИИ-посреднику, ведь он может забрать контроль над пользовательским вниманием, рекламой и транзакциями. Не менее важен вопрос доверия. Пользователю нужно быть уверенным, что агент не ошибётся при оплате, бронировании, отправке сообщения или работе с персональными данными. Пока большинство сценариев — заказ еды, поиск билетов, планирование поездки — воспринимаются скорее как удобство, а не как причина срочно менять телефон. Будущее агентных смартфонов будет зависеть не только от качества моделей. Победит тот, кто сможет объединить надёжную работу ИИ, доступ к экосистеме приложений, понятные правила безопасности и действительно незаменимые сценарии. Главная борьба разворачивается за право стать новым «центром управления» смартфоном — тем слоем, через который пользователь будет взаимодействовать со всеми цифровыми сервисами.

16Апр

Всемирная конференция по искусственному интеллекту WAIC за три года стала наглядной хроникой того, как ИИ в Китае прошёл путь от технологической демонстрации к инструменту реального производства. Если в 2024 году главными экспонатами были чат-боты, параметры моделей и тестовые рейтинги, то в 2026-м центр тяжести сместился к стоимости вычислений, надёжности, интеграции в рабочие процессы и измеримому экономическому эффекту. ИИ перестаёт восприниматься как абстрактная «магия больших моделей». Он становится инженерной дисциплиной, где побеждают не самые громкие демо, а решения, способные стабильно работать, окупаться и нести ответственность за результат. Первый заметный поворот — изменение формы ИИ. В 2024 году компании продавали доступ к моделям через API и оплату за токены. В 2025-м акцент сместился на агентов, способных вызывать инструменты и выполнять цепочки действий. К 2026 году рынок всё чаще продаёт не саму модель и даже не агента, а результат работы: выполненную роль, автоматизированный процесс или достижение конкретного KPI. Агенты всё активнее получают собственные устройства: смартфоны, автомобили, роботов, специализированные терминалы. Например, агентные системы могут самостоятельно планировать поездку, подбирать билеты и отели, а затем взаимодействовать с сервисами бронирования и оплаты. Важен не сам смартфон как потребительский товар, а контролируемая среда, в которой агент может выполнять действия и отвечать за результат. Одновременно усиливается тренд на компактные модели, работающие непосредственно на устройствах. Конкуренция переходит от наращивания размера моделей к повышению «интеллектуальной плотности» — полезного качества на единицу вычислительных затрат. Локальный ИИ снижает стоимость работы, уменьшает задержку и делает возможным массовое внедрение в телефоны, автомобили и роботов. Второй поворот связан с embodied AI — роботами, способными действовать в физическом мире. В 2024 году на выставках демонстрировали, что гуманоидный робот умеет стоять или ходить. В 2025-м зрителей привлекали танцы, акробатика и сложные трюки. В 2026 году главным критерием становится не зрелищность, а способность стабильно выполнять полезную задачу. Роботы начинают отказываться от обязательной человекоподобной формы. Во многих задачах эффективнее колёсная платформа с манипуляторами, гибридная конструкция или специализированное устройство. Форму всё чаще выбирают под задачу, а не ради максимального сходства с человеком. Ещё важнее развитие VLA-моделей — систем, связывающих зрение, язык и действия. Одна модель может управлять разными типами роботов и выполнять одинаковые процессы: например, принять заказ в аптеке, найти лекарство и передать его клиенту. Это означает движение к принципу «один мозг — много тел», при котором программная часть частично отделяется от конкретной конструкции робота. Однако отрасль пока далека от массовой замены труда. Даже успешные производители значительную часть выручки получают от поставок роботов университетам, лабораториям и исследовательским центрам. То есть сегодня рынок во многом продаёт инструменты для разработки, а не готовую универсальную рабочую силу. Третий поворот происходит в инфраструктуре. Раньше компании сравнивали наличие GPU и производительность отдельных ускорителей. Теперь ключевыми понятиями становятся сверхкрупные вычислительные узлы и «фабрики токенов». Сверхузлы объединяют тысячи чипов в единый вычислительный ресурс, уменьшая потери на обмен данными и повышая эффективность обучения и инференса. Для Китая это особенно важно: системная архитектура, сетевые решения и программная оптимизация позволяют частично компенсировать ограничения в доступе к наиболее передовым производственным технологиям чипов. С другой стороны, токен становится универсальной единицей экономики ИИ. Поставщики инфраструктуры считают себестоимость токена, модельные компании — выручку на токен, а корпоративные заказчики — бизнес-эффект от расходов на токены. В результате конкурентное преимущество определяется уже не только «самой сильной моделью», а способностью подобрать оптимальную модель для каждой задачи, контролировать расходы и обеспечивать устойчивую работу агентов. Особое значение получает слой маршрутизации и оркестрации: система должна решать, когда использовать дорогую мощную модель, когда — компактную, а когда — перепроверять результат несколькими моделями. В такой архитектуре ценность постепенно смещается от базовой модели к управлению её использованием. Четвёртый поворот — переход от демонстрации возможностей к гарантируемой поставке результата. Большие модели по своей природе вероятностны: они могут дать сильный ответ, но могут и ошибиться. Бизнес же строится на предсказуемости, контроле и ответственности. Поэтому корпоративный ИИ требует не только модели, но и целой инженерной системы: управления знаниями, настройки процессов, прав доступа, безопасности, мониторинга, проверки качества и обработки ошибок. Агент должен быть встроен в CRM, ERP, продажи, поддержку и другие реальные системы, а не существовать отдельно в демонстрационном чате. Компании всё чаще оценивают ИИ по операционным метрикам: точности, доле успешно выполненных задач, числу итераций тестирования, сроку окупаемости и сокращению ошибок. В промышленности особенно важны показатели ложных срабатываний, пропусков и стабильности работы. Система, которая регулярно ошибается в критическом процессе, может оказаться опаснее, чем отсутствие автоматизации. Меняется и коммерческая модель. Рынок постепенно движется от покупки лицензий и токенов к оплате за подтверждённый бизнес-результат. Но такой подход возможен только при наличии прозрачных и проверяемых методов оценки. Поэтому системы тестирования, аудита и приёмки превращаются в новую инфраструктуру корпоративного ИИ. Пятый поворот касается места китайского ИИ в глобальной экосистеме. В 2024 году китайские компании главным образом сравнивали свои решения с американскими моделями и роботами. В 2025-м ключевым аргументом стала более низкая стоимость. В 2026 году заметнее становится другая стратегия: открытые веса моделей, быстрые итерации и доступное развёртывание. Логика проста: Китай не всегда может конкурировать с крупнейшими американскими игроками по масштабу капитальных расходов и вычислительных ресурсов. Поэтому важным инструментом становится создание открытых моделей, которые разработчики по всему миру могут запускать, адаптировать и встраивать в собственные продукты. Влияние модели измеряется не только её местом в рейтинге. Оно проявляется, когда на её основе создают приложения, включают её в исследовательские работы, используют как эталон или интегрируют в популярные инструменты разработки. В этом случае модель становится частью технологической инфраструктуры и формирует вокруг себя экосистему. При этом открытость не отменяет фундаментальных ограничений. Ключевыми остаются чипы, энергоснабжение, вычислительные кластеры и капитал. Низкая цена токена также не гарантирует низкую стоимость готовой задачи: слабая модель может потребовать больше запросов, времени и проверок. История WAIC с 2024 по 2026 год — это история «снятия очарования» с ИИ. Рынок прошёл через гонку моделей, демонстрационные прототипы и болезненные проблемы внедрения. Теперь главными становятся не размер модели и эффектность презентации, а качество инженерной реализации, стоимость эксплуатации, соответствие сценарию и доказуемая отдача. Следующий этап ИИ-рынка выиграют компании, которые сумеют превратить вероятностные модели в надёжную производственную систему — такую, которой бизнес готов доверить реальные задачи и за которую готов платить постоянно.

16Апр

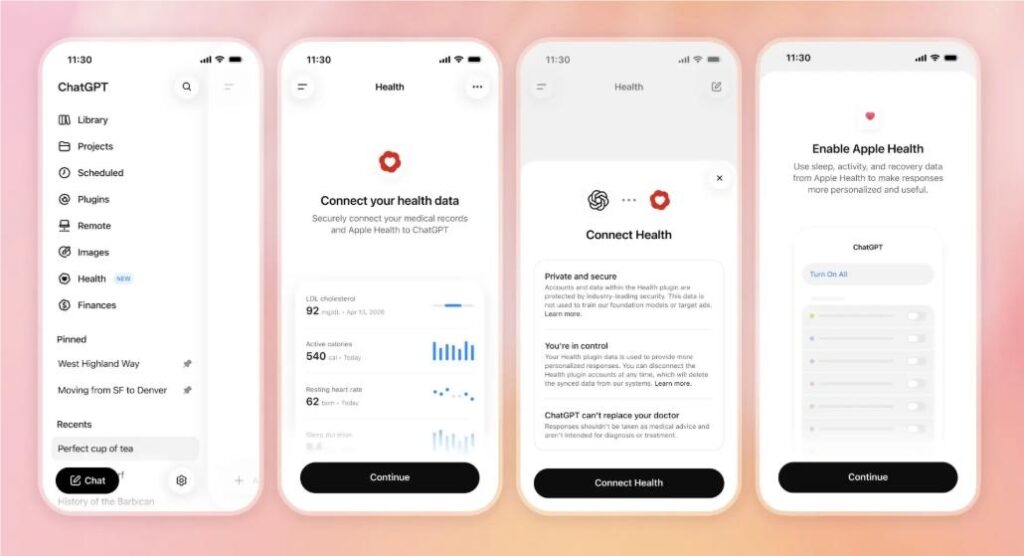
OpenAI открыла функцию ChatGPT Health для пользователей в США старше 18 лет. Новый раздел доступен в веб-версии и iOS-приложении ChatGPT, включая бесплатные и платные тарифы. Он позволяет получать ИИ-подсказки по распространённым симптомам, лекарствам, результатам обследований и вопросам психологического благополучия, а также подключать данные из Apple Health, Function Health и MyFitnessPal. Это важный сигнал для рынка: универсальные ИИ-ассистенты переходят от привычных задач — поиска, создания текстов, перевода и офисной работы — к сферам с высоким уровнем доверия и особенно чувствительными данными. В здравоохранении недостаточно просто дать пользователю быстрый ответ. Не менее важны прозрачность обработки данных, понятные ограничения рекомендаций, защита приватности и ответственность за возможные ошибки. 24 июля ChatGPT занимал первое место среди бесплатных iPhone-приложений в США, в общем рейтинге по выручке и в категории продуктивности. Рядом в рейтингах находились Claude, Grok AI и Perplexity. Это показывает, что рынок ИИ-приложений постепенно выходит за пределы этапа любопытства и пробного использования: теперь ключевой вопрос — способны ли сервисы удерживать пользователей и превращать интерес в регулярную подписку. Для нишевых приложений такая конкуренция одновременно создаёт угрозу и возможность. Простые продукты с интерфейсом «чат с ИИ» будут всё сильнее конкурировать с крупными универсальными платформами. Однако специализированные сервисы могут выигрывать за счёт глубины: знания отраслевых процессов, соответствия требованиям регулирования, проверки профессионального контента, интеграции с офлайн-сервисами и постоянной работы с результатами пользователя. Особенно это заметно в медицине, финансах, образовании и управлении личными делами. В этих сферах люди ожидают не только ответа, но и понятного процесса: записи данных, напоминаний, интерпретации, регулярного анализа и плана дальнейших действий. Поэтому ценность нишевого продукта должна строиться не вокруг отдельного диалога с ИИ, а вокруг полноценного пользовательского сценария. Разработчикам стоит обратить внимание на три направления. Во-первых, ясно объяснять, какие данные приложение получает, как ими можно управлять и где проходят границы ИИ-рекомендаций. Во-вторых, превращать функции в повторяемые процессы, а не ограничиваться чатом. В-третьих, разделять широкие запросы к ИИ и конкретные потребности аудитории — например, вести отдельные продуктовые страницы и рекламные кампании для контроля питания, восстановления после тренировок или ведения медицинских записей. Главный вывод прост: универсальные ИИ-ассистенты будут забирать всё больше входящего трафика в высокодоверительных категориях. Но у вертикальных продуктов остаётся шанс, если они смогут предложить пользователю то, что трудно масштабировать в универсальном помощнике: надёжность, специализированную экспертизу, прозрачную работу с рисками и устойчивую ценность в ежедневном сценарии.

16Апр

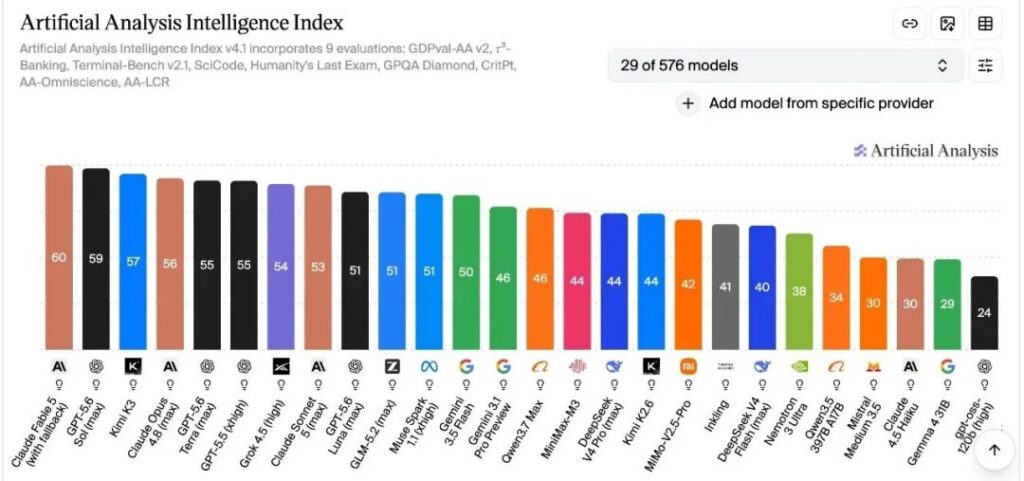
Стремительный интерес к новой модели Kimi K3 от компании Moonshot AI неожиданно выявил одну из главных проблем современного рынка искусственного интеллекта — нехватку вычислительных мощностей для инференса. Менее чем через неделю после релиза разработчику пришлось временно остановить оформление подписок для новых пользователей, чтобы сохранить ресурсы для уже действующих клиентов. Компания подчеркнула, что существующие подписки и условия обслуживания не меняются, однако сроки возобновления продаж новых тарифов пока не определены. Причина ажиотажа понятна. Kimi K3 позиционируется как крупная открытая модель класса MoE с общим объёмом в 2,8 триллиона параметров. По данным независимого рейтинга Artificial Analysis, она вошла в число лидеров по совокупной оценке способностей, оказавшись рядом с наиболее сильными закрытыми моделями. Для рынка особенно важно, что открытая модель впервые столь близко приблизилась к верхней части глобального рейтинга. Разработчики активно тестируют Kimi K3 в задачах программирования, агентных сценариях, генерации кода и вызова внешних инструментов. Пользователи отмечают её потенциал в сложных многошаговых задачах, где модель должна удерживать контекст, анализировать код и последовательно выполнять действия. В то же время первые отзывы показывают, что высокие результаты в бенчмарках не гарантируют безошибочной работы в профессиональных задачах: модель может упускать детали, допускать ошибки в статистических рассуждениях и требовать проверки со стороны специалиста. Однако важнейший вывод связан не столько с качеством модели, сколько с инфраструктурой. Обучение большой модели — лишь начало затратного цикла. После запуска особенно ресурсоёмкими становятся пользовательские запросы, связанные с агентами и ИИ-программированием. В отличие от короткого диалога в чат-боте, такие задачи включают длинный контекст, многократные рассуждения, использование инструментов и выполнение нескольких последовательных шагов. Каждый запрос дольше занимает GPU и обходится дороже. Именно поэтому на первый план выходят не только параметры модели и места в рейтингах, но и скорость инференса, стабильность сервиса, стоимость запросов и способность компании масштабировать инфраструктуру. Для моделей триллионного масштаба требуются кластеры из десятков тысяч ускорителей, а их создание требует крупных инвестиций и длительного времени. История Kimi K3 демонстрирует изменение логики конкуренции в ИИ. Если раньше компании главным образом соревновались в размере моделей и результатах тестов, то теперь успех зависит от того, способны ли они выдержать реальную нагрузку. Сильная модель может быстро привлечь аудиторию, но без достаточного числа GPU, надёжной инфраструктуры и контроля затрат её популярность превращается из преимущества в операционный риск.

16Апр

В эпоху поисковых систем текст создавался прежде всего для людей, хотя авторы давно учитывали правила SEO: ключевые слова, понятная структура, короткие абзацы и заголовки. С распространением генеративного ИИ ситуация меняется ещё сильнее. Всё больше материалов публикуется не ради прямых просмотров, а ради того, чтобы попасть в поле зрения поисковых роботов и быть использованными в ответах нейросетей. Эта тенденция получила название GEO — оптимизация под генеративные движки. Её сторонники советуют формулировать вывод в начале текста, разбивать материал на несколько чётких тезисов, добавлять структурированную разметку и размещать публикации на площадках, которые часто индексируются ИИ-системами. Цель такой работы — не обязательно получить читателя на сайт, а добиться того, чтобы модель упомянула бренд, товар или мнение в ответе на пользовательский запрос. Опасность этого подхода показал эксперимент, авторы создали несуществующий «умный браслет» и разместили о нём несколько рекламных публикаций с вымышленными характеристиками. Через короткое время отдельные ИИ-модели начали повторять эти сведения в ответах, а после серии дополнительных публикаций включали несуществующий товар в рекомендации. Эксперимент не доказывает, что модели сформировали устойчивое «мнение» о продукте, но демонстрирует другое: система может найти информацию релевантной по форме и теме, не распознав, что она была массово создана в рамках одной манипуляции. Проблема усиливается тем, что пользователи всё чаще получают ответ прямо в интерфейсе ИИ и не переходят к первоисточникам. По приведённым данным, ИИ-резюме уже заметно сокращают органический трафик сайтов. При этом модели нередко используют информацию из пользовательских платформ и контентных сообществ, где качество, авторство и достоверность материалов могут сильно различаться. В результате меняется сама логика распространения знаний. Раньше ложное утверждение должно было убедить большое число людей, чтобы стать заметным и повлиять на общественное мнение. Теперь ему иногда достаточно попасть в индексируемый массив текстов, откуда его может извлечь модель и повторить с видимостью авторитетного ответа. При этом структурированный и понятный текст сам по себе не является проблемой. Чёткая подача полезна и читателю, и машине. Риски возникают, когда оптимизацию используют для распространения недостоверных сведений, скрытой рекламы или искусственного создания впечатления, будто определённая точка зрения подтверждается множеством независимых источников. Главный вызов состоит в том, что автор постепенно превращается не только в рассказчика, но и в поставщика данных для ИИ. Текст всё чаще создаётся как набор фрагментов, которые легко извлечь, сопоставить с запросом и встроить в ответ модели. Такие статьи могут почти не читать люди, но они всё равно способны влиять на решения людей — через то, что им рассказывает искусственный интеллект.

16Апр

Генеративный ИИ всё активнее входит в жизнь школьников: его используют для домашних заданий, поиска информации, общения и эмоциональной поддержки. По данным исследования Китайского исследовательского центра молодёжи, 61,7% опрошенных школьников уже пользовались такими сервисами, а около пятой части признались, что предпочли бы полагаться на ИИ в размышлениях, а не думать самостоятельно. Более двух десятых респондентов также заявили, что им комфортнее общаться с ИИ, чем с реальными людьми. Главная проблема заключается не в самом использовании технологии, а в постепенной передаче ей когнитивной и социальной самостоятельности. ИИ может быстро объяснить тему, предложить готовый ответ, поддержать в тревожной ситуации или помочь сформулировать сообщение. Но если ребёнок постоянно заменяет такими ответами собственные попытки разобраться, ошибиться, поспорить и сделать вывод, у него остаётся меньше пространства для развития критического мышления и уверенности в себе. Особую тревогу вызывает замена живого общения. В реальных отношениях подросток учится сталкиваться с несогласием, отказом, недопониманием и необходимостью договариваться. ИИ, напротив, обычно настроен быть вежливым, поддерживающим и мгновенно доступным. Такая модель взаимодействия удобна, но может создать искажённое представление о человеческих отношениях, где другой человек не обязан постоянно соглашаться, утешать или подстраиваться. Наиболее уязвимыми могут оказаться дети, которым и без того не хватает поддержки: подростки с психологическими трудностями, слабым контактом с семьёй или недостатком общения со сверстниками. В таких случаях сильная привязанность к ИИ — это не только следствие популярности технологии, но и возможный сигнал о проблемах в реальной среде ребёнка. Запретить ИИ полностью вряд ли возможно и необходимо. Более разумный подход — учить детей пользоваться им осознанно. Родителям стоит не просто запрещать готовые ответы, а обсуждать их: «Как бы ты решил задачу без ИИ?», «Почему этому ответу можно или нельзя доверять?». Школам важно развивать ИИ-грамотность: объяснять принципы работы моделей, учить проверять информацию и сохранять ответственность за собственные решения. ИИ может быть полезным помощником, но он не должен становиться заменой мышлению, дружбе и реальному взрослению.

16Апр

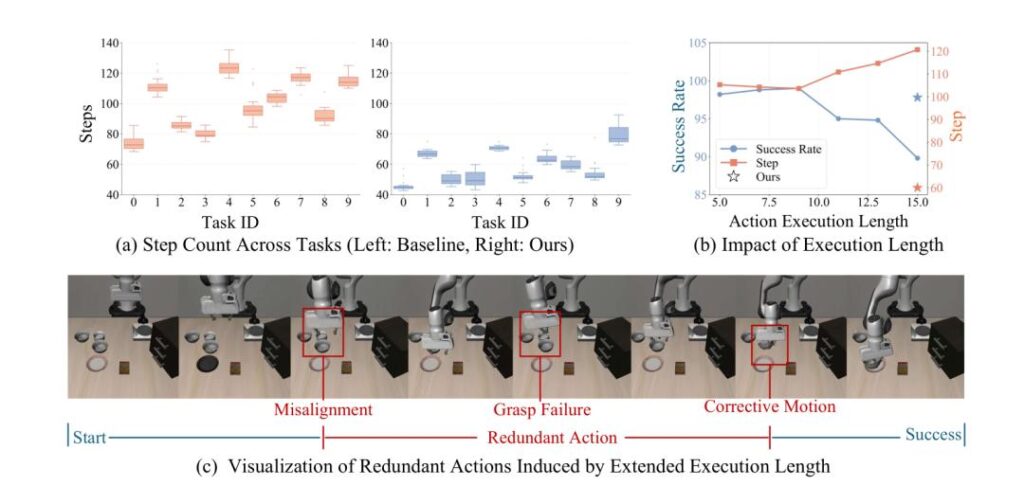
Модели класса Vision-Language-Action, или VLA, объединяют зрительное восприятие, текстовые инструкции и управление действиями робота. Благодаря этому робот может получать команду на естественном языке, анализировать окружающую среду и выполнять многошаговые физические задачи. Однако при переходе от лабораторных тестов к реальным роботам возникает важная проблема: даже сильная модель часто действует слишком медленно и выполняет много лишних движений. Обычно ускорение ИИ-систем пытаются получить за счёт оптимизации вычислений: сокращают число токенов, используют квантование, повторно применяют кэш или улучшают движок инференса. Такие методы снижают задержку одного обращения к модели, но не решают проблему неэффективного поведения. Если робот всё равно постоянно останавливается, перепланирует действия, возвращается назад и исправляет собственные ошибки, выполнение задачи остаётся долгим. Для решения этой проблемы исследователи предложили метод PolicyTrim. Его ключевая идея заключается в том, чтобы оптимизировать не только скорость вычислений, но и саму стратегию действий робота. Метод не требует менять архитектуру VLA-модели или собирать новый массив экспертных демонстраций. Он применяется как дополнительный этап обучения уже готовой модели. PolicyTrim состоит из двух этапов. На первом модель учится надёжнее выполнять более длинные последовательности действий без постоянного пересчёта плана. Обычно VLA-система предсказывает сразу несколько движений, однако последние действия в такой последовательности менее надёжны: ошибки накапливаются, и робот вынужден часто заново анализировать ситуацию. Новый подход поощряет успешные траектории, в которых робот способен безопасно использовать более длинные фрагменты предсказанных действий. На втором этапе система сокращает число физических шагов. Робот получает большее вознаграждение, если достигает цели по более короткой и прямой траектории. При этом специальные ограничения не позволяют модели искать рискованные «короткие пути», которые могли бы ухудшить вероятность успешного завершения задачи. По данным авторов работы, метод позволил сократить число физических действий в среднем до 51,4% и получить ускорение выполнения задач до 5,83 раза на одном из тестовых наборов, сохраняя высокую успешность. В экспериментах на реальном манипуляторе среднее сквозное ускорение достигало 1,86 раза, в том числе в условиях, когда положение объекта менялось во время выполнения задачи. Главный вывод исследования состоит в том, что эффективность робота определяется не только мощностью GPU и скоростью инференса. Не менее важно, насколько разумно робот строит свою траекторию. Если система способна избегать лишних корректировок, повторов и колебаний у цели, она может выполнять те же действия быстрее и с меньшими затратами ресурсов. В перспективе такие методы могут сочетаться с аппаратным ускорением и оптимизацией моделей, обеспечивая ещё более заметный прирост производительности робототехнических систем.

16Апр

После полутора лет стремительного роста глобальная индустрия искусственного интеллекта, похоже, вступает в этап переоценки. Акции ряда компаний, связанных с ИИ, резко скорректировались: снижение затронуло как молодых игроков, так и крупнейшие технологические корпорации США и Азии. Это воспринимается не просто как краткосрочная волатильность, а как начало «сдувания пузыря», сформировавшегося на ожиданиях сверхбыстрого роста отрасли. Причина — разрыв между громкими обещаниями и реальной коммерческой отдачей. Инвесторы долго оценивали ИИ-компании прежде всего по будущему потенциалу: росту числа пользователей, масштабам привлечённых инвестиций и планам по строительству вычислительной инфраструктуры. Однако высокие оценки требуют подтверждения выручкой, устойчивым спросом и понятной перспективой прибыли. Успех отдельных лидеров рынка не означает, что все компании смогут повторить их темпы роста. Сегодня наиболее убедительным прикладным сценарием для ИИ остаётся программирование. Генерация и анализ кода действительно повышают производительность разработчиков и уже превратились в заметный рынок. Но этого недостаточно, чтобы оправдать самые смелые ожидания относительно универсального внедрения ИИ во все сферы жизни. Агентные сервисы, офисные помощники, инструменты для науки и мультимедиа пока находятся на ранней стадии: их ценность для массового пользователя и масштабы монетизации ещё предстоит доказать. Снижение ажиотажа может оказаться для отрасли полезным. В период бума компании часто стремятся наращивать аудиторию любой ценой, увеличивать расходы на вычисления и привлекать капитал под амбициозные планы. В «постпузырьковой» фазе акцент смещается на эффективность: необходимо контролировать затраты, искать платёжеспособный спрос и строить бизнес-модели, способные работать без постоянного притока внешних денег. История технологических рынков показывает, что после спекулятивных перегревов обычно остаются наиболее сильные компании и действительно востребованные продукты. Поэтому корректировка оценок не обязательно означает крах ИИ-индустрии. Скорее, она может стать переходом от эпохи завышенных ожиданий к более зрелому этапу, в котором решающими будут не обещания, а практическая польза технологий и способность превращать её в устойчивый бизнес.

16Апр

По мере развития искусственного интеллекта становится всё сложнее объяснить новые продукты несколькими слайдами на презентации. Если раньше внимание аудитории было сосредоточено на количестве параметров модели, её месте в рейтингах и способности писать код или генерировать изображения, то теперь вопросы стали значительно практичнее. Пользователей интересует, может ли ИИ находить клиентов для отдела продаж, проверять договоры, выполнять задачи автономного агента и насколько надёжно он работает в реальных условиях. Именно поэтому ИИ-компании и разработчики всё чаще используют видеоформаты, прямые эфиры и длинные подкасты. Они позволяют не только показать эффектную демонстрацию, но и разобрать процесс: как система получает задачу, обращается к инструментам, сохраняет контекст, исправляет ошибки и реагирует на нестандартные ситуации. Для сложных технологий это важнее краткого рекламного заявления о том, что продукт «изменит будущее». Показателен пример открытого агентного проекта OpenClaw. Сначала он быстро завоевал внимание разработчиков благодаря идее: человек формулирует цель, а ИИ самостоятельно пытается довести задачу до результата. Однако после периода бурного интереса стали заметны проблемы с надёжностью и безопасностью. Один и тот же сценарий мог успешно выполняться сегодня, но неожиданно завершаться ошибкой позже. Это подчёркивает ключевую особенность современных ИИ-агентов: их нельзя оценивать только по единичным удачным демонстрациям, поскольку работа с реальными системами требует устойчивости, контроля прав доступа и способности восстанавливаться после сбоев. Видео и подкасты становятся важны ещё и потому, что помогают обсуждать технологические вопросы на более глубоком уровне. Например, разговор о конкурентоспособности ИИ-чипов нельзя свести к сравнению производительности одной карты с решением Nvidia. Он включает архитектуру, программную экосистему, производство, цепочки поставок, инженерную культуру и многолетний цикл создания продукта. Такие темы требуют времени, экспертизы и последовательного диалога. Одновременно видеосообщества превращаются из площадок для просмотра контента в среду, где пользователи сами создают ИИ-продукты. Благодаря доступным моделям и обучающим материалам люди без серьёзного инженерного опыта могут собирать прототипы, тестировать идеи и получать обратную связь от аудитории. Авторы создают графические инструменты для настройки ИИ-сервисов, экспериментируют с генеративными интерфейсами, превращают заметки в интерактивные проекты и адаптируют старые устройства под новые ИИ-функции. Таким образом, меняется и сама цепочка распространения технологий. Раньше она выглядела достаточно линейно: презентация, публикации в СМИ, первые отзывы пользователей. Теперь запуск ИИ-продукта часто становится началом непрерывного цикла: демонстрация в видео, обсуждение в подкастах, технический разбор, пользовательские эксперименты, комментарии и последующие обновления. В этой новой модели разработчики, авторы контента и обычные пользователи становятся участниками одного процесса. Они не только получают информацию о технологии, но и помогают проверять её границы, выявлять слабые места и формировать будущие сценарии применения. Поэтому видеоформаты для ИИ-индустрии постепенно становятся не просто каналом продвижения, а частью разработки, тестирования и эволюции самих продуктов.

Если у вас есть инновационная идея, мы будем рады реализовать ее для Вас!

Специалисты нашей кампании и наши разработки для вас!