Новости

Социальные сети

Узнайте больше о рынке It и новейших технологиях.
СТАТЬИ
16Апр

Человек может выращивать зелень, салаты, пряные травы, а иногда томаты или перец прямо дома — без земли, постоянного солнечного света и сложного ухода. Устройство само подаёт воду и питательный раствор, включает освещение, а в более продвинутых версиях с помощью камер и алгоритмов отслеживает состояние растений. В основе таких устройств лежат методы беспочвенного земледелия: Гидропоника — корни растений получают воду и растворённые питательные вещества вместо почвы. Аэропоника — корневая система находится в воздухе, а питательный раствор подаётся в виде мелкого аэрозоля. Гибридные системы — сочетают стабильную подачу раствора, характерную для гидропоники, и насыщение корней кислородом, характерное для аэропоники. Пользователю обычно нужно собрать базовые модули — резервуар, освещение и посадочные секции, — подключить устройство к сети и установить капсулы с семенами или субстратом. После этого система поддерживает условия роста автоматически, а урожай можно срезать по мере необходимости. Главные преимущества для городского жителя — компактность, отсутствие грязи с землёй, независимость от сезона и возможность получать свежую зелень прямо на кухне. Домашние огороды выпускаются в разных формах. Самые простые — настольные горизонтальные модели, которые подходят для базилика, салата, мяты и другой небольшой зелени. Они относительно недороги, но ограничены по вместимости. Более продвинутый формат — вертикальные башни. Растения располагаются по окружности высокой колонны, поэтому на небольшой площади можно разместить десятки посадочных мест. Такие системы хорошо подходят для аэропоники: излишки раствора стекают вниз под действием силы тяжести, а корни получают доступ к воздуху. Есть и многобашенные модели, где несколько вертикальных колонн подключены к одному резервуару и системе освещения. Они рассчитаны на тех, кто хочет выращивать больше растений, но при этом сохранить небольшую площадь установки. Производители также делают такие устройства похожими на предмет интерьера: напольный светильник, витрину или декоративную «зелёную башню». Ранние домашние гидропонные устройства были в основном автоматическими: они включали лампу по таймеру, подавали воду и иногда измеряли кислотность. AI-подход предполагает более активное управление. В теории камера и компьютерное зрение могут отслеживать: скорость роста; изменение цвета листьев; признаки нехватки света, воды или питательных веществ; возможные болезни и повреждения; необходимость подрезки или пересадки. На основе этих данных система может менять длительность подсветки, режим полива и концентрацию питательного раствора. Пользователь получает уведомления в приложении и может контролировать установку удалённо — это удобно при поездках или плотном рабочем графике. Однако статья справедливо отмечает, что многие нынешние «умные» установки пока не настолько интеллектуальны, как заявляет маркетинг. В ряде моделей автоматизация сводится к напоминанию долить воду или проверить уровень pH. Настоящая ценность появится тогда, когда система сможет комплексно управлять светом, влажностью, питанием, плотностью посадки, защитой от плесени и вредителей. Беспочвенное выращивание существует давно и раньше использовалось главным образом там, где обычное земледелие затруднено: на военных базах, в пустынях, в изолированных объектах и космических исследованиях. Домашним этот подход сделали более доступные LED-лампы, компактные насосы, датчики и массовое производство пластиковых модулей. Светодиоды особенно важны: они дают нужный спектр света, меньше нагреваются и потребляют меньше энергии, чем старые лампы высокой мощности. Благодаря этому гидропонная система может стоять в квартире, а не только в теплице или лаборатории. Развитие рынка также связано с культурными и коммерческими факторами. В США индустрия домашнего выращивания активно росла вместе с легализацией каннабиса в части штатов: профессиональные лампы, вентиляция, датчики и контроллеры создавались для разных типов растений, а затем многие решения стали использоваться и для выращивания зелени, овощей и декоративных культур. В Китае и других странах ранние домашние устройства не всегда становились массовыми. Одна из причин — покупателю бывает проще и дешевле купить овощи, чем выращивать их в дорогом устройстве. Поэтому такой продукт продаёт не только еду, но и опыт: уход за растениями, эстетическое удовольствие, ощущение контроля, экологичный образ жизни и домашний интерьер. Несмотря на привлекательность идеи, у устройств есть заметные минусы: высокая первоначальная стоимость; расходы на электричество, семена, питательные растворы и расходные материалы; необходимость чистить резервуар и обслуживать насосы; ограниченный объём урожая; не всегда удобный слив воды; зависимость от качества автоматизации и приложения. Для большой семьи домашняя система редко становится полноценной заменой магазину или дачному огороду. Наиболее реалистичное применение — зелень, травы, салаты и небольшое количество овощей, которые ценны свежестью и удобством. В Китае также развиваются полностью автоматизированные «растительные фабрики», где посев, выращивание, сбор и упаковка выполняются с минимальным участием человека. Такие проекты не предназначены для того, чтобы заменить личное удовольствие от выращивания растений. Их задача — производить свежую продукцию рядом с городом, используя меньше земли и контролируемые условия. Домашний AI-огород и вертикальная ферма решают разные задачи. Первый даёт человеку личный опыт выращивания и небольшое количество свежих продуктов. Вторая обеспечивает город более предсказуемым и масштабируемым производством. Технология не обязана полностью заменить землю, солнце и обычный огород. Её ценность в другом — дать жителю города возможность выращивать растения там, где нет участка, балкона с хорошим светом или времени на традиционный уход. Если AI действительно сделает эти системы проще, надёжнее и дешевле, домашнее выращивание сможет стать не экзотикой, а привычной частью городской жизни.

16Апр

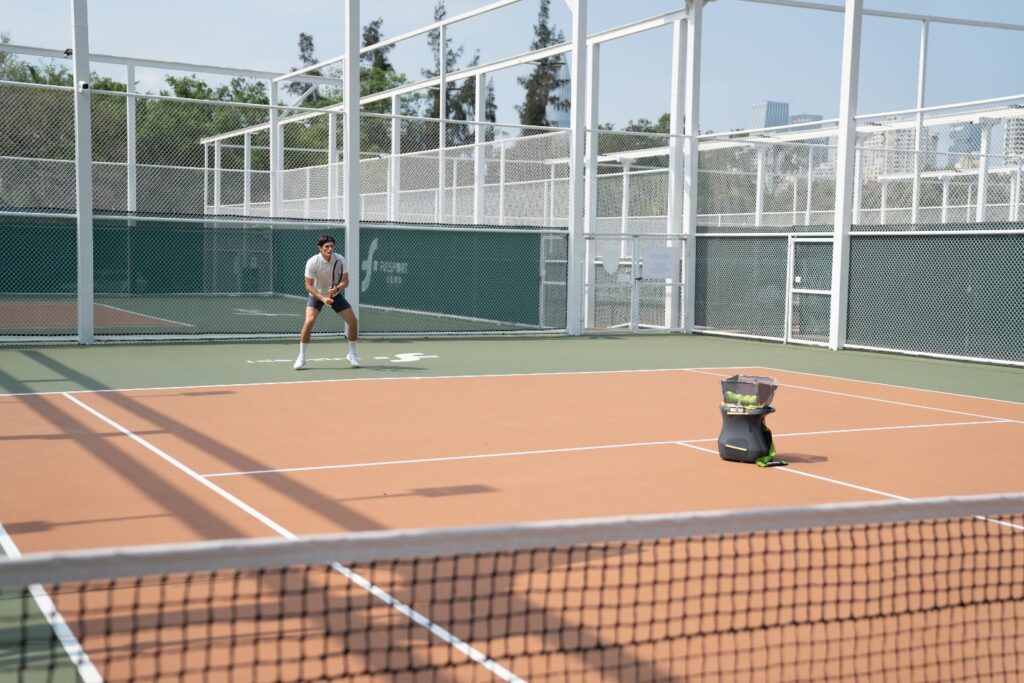
Компания Pongbot, ранее известная прежде всего своими теннисными пушками, представила устройство Aura — многофункционального AI-робота-тренера для ракеточных видов спорта. Проект быстро привлёк внимание: в первый день кампании на Kickstarter он собрал более миллиона долларов, а общий объём краудфандинга приблизился к четырём миллионам долларов. Главная идея Aura — заменить несколько отдельных тренажёров одной системой. Устройство рассчитано на теннис, пиклбол и падел, а в будущем может расширяться на другие похожие виды спорта. Вместо того чтобы покупать отдельную машину для каждой дисциплины, пользователь получает единый аппарат с программными режимами и возможностью разблокировать дополнительные виды спорта через приложение. Традиционный автомат для подачи мячей решает довольно простую задачу: выдаёт мяч с заданной скоростью, вращением и траекторией. Он полезен для повторения ударов, но почти не понимает, что происходит с игроком во время тренировки. Aura пытается изменить этот подход. Её AI Coach построен по модели «руки — глаза — мозг»: «Руки» — система подачи и управления мячами, которая регулирует скорость, вращение, траекторию и место приземления. «Глаза» — съёмный модуль с двумя камерами, работающий с частотой до 120 кадров в секунду. Он отслеживает движение игрока, ракетки и мяча. «Мозг» — алгоритмы, которые анализируют эпизоды тренировки, выявляют возможные ошибки и меняют следующие упражнения. Вместо того чтобы после занятия показать общий отчёт, система стремится реагировать во время тренировки. Например, она может заметить, что игрок поздно готовится к удару, неправильно выбирает точку контакта или не успевает переносить вес тела, а затем голосом дать рекомендацию и изменить следующую серию подач. Таким образом, устройство пытается воспроизвести работу тренера: подать мяч, наблюдать за действием, дать обратную связь и адаптировать следующее упражнение. Поддержка нескольких видов спорта — это не просто набор разных настроек в приложении. Теннисные мячи, мячи для падела и пиклбола отличаются весом, материалом, упругостью, формой, аэродинамикой и поведением в полёте. Например, теннисному мячу может требоваться более сильное сжатие и высокая скорость вращающихся колёс, чтобы обеспечить нужную подачу и вращение. Пиклбольный мяч легче, имеет отверстия и сильнее реагирует на сопротивление воздуха. Если использовать один и тот же механизм без адаптации, возрастает риск деформации мяча, заклинивания, нестабильной подачи или неточной траектории. Поэтому Aura использует регулируемую систему подачи и отдельные параметры управления для разных типов мячей. По сути, компания создаёт общую механическую платформу, но настраивает под неё разные физические модели и алгоритмы контроля. Предыдущие устройства Pongbot из линейки PACE ориентировались на серьёзных игроков: они делали акцент на высокой скорости подачи, точности и вращении. Aura занимает другую нишу — более массовую. Вес устройства составляет около семи килограммов, поэтому его можно переносить в рюкзаке. Основная аудитория — любители и начинающие игроки, которые хотят тренироваться самостоятельно, но не всегда могут заниматься с тренером или партнёром. Для них мультиспортивный формат решает ещё одну проблему: человеку не нужно заранее выбирать одну дисциплину и сразу покупать специализированное оборудование. Он может начать с тенниса, позже попробовать пиклбол или падел и активировать нужный режим через подписку. Коммерческая модель строится вокруг сочетания устройства и программных функций. Покупатель может приобрести базовую версию, а затем оплачивать доступ к дополнительным спортивным режимам или AI-возможностям ежемесячно либо ежегодно. Для производителя это даёт несколько преимуществ: один аппаратный продукт может обслуживать сразу несколько рынков; компоненты и поставки проще стандартизировать; аудитория расширяется с поклонников одного спорта до пересекающихся групп игроков; пользователь остаётся внутри экосистемы, даже если меняет вид спорта; история тренировок продолжает накапливаться в одной системе. Именно данные становятся наиболее важным активом. Каждая тренировка даёт информацию о траекториях, ударах, ошибках, реакции пользователя на упражнения и динамике прогресса. По мере накопления этих данных система может точнее адаптировать рекомендации и тренировочные сценарии. Устройство отражает более широкий тренд в потребительской технике: аппаратная часть становится входной точкой, а основная ценность смещается в сторону программного опыта, персонализации и данных. Если обычный тренажёр продаёт пользователю набор механических функций, AI-робот пытается продавать непрерывный процесс обучения. Пользователь получает не просто подачу мячей, а систему, которая помнит его предыдущие занятия, оценивает технику, предлагает упражнения и постепенно подстраивается под его уровень. При этом успех такого продукта будет зависеть от нескольких факторов: точности компьютерного зрения, качества рекомендаций, надёжности механики, стоимости подписки, удобства использования на реальном корте и того, действительно ли AI-обратная связь помогает игроку прогрессировать. Но сама концепция выглядит показательной: спортивный гаджет превращается из узкоспециализированного оборудования в цифрового тренера, который может сопровождать человека при переходе между видами спорта и учиться вместе с ним на каждой тренировке.

16Апр

В первой половине 2026 года крупные образовательные и технологические компании заметно ускорили запуск AI-продуктов. По данным статьи, за полгода было публично представлено 16 решений: от учебных планшетов и цифровых помощников для школьников до сервисов профориентации, инструментов для учителей, приложений для родителей и устройств для раннего развития детей. Рынок уже выходит за рамки простого AI-чата с ответами на вопросы. Компании пытаются встроить ИИ в полный образовательный процесс — диагностику знаний, планирование обучения, подготовку уроков, выбор вуза, взаимодействие с родителями и накопление долгосрочных данных об учащемся. Половина из 16 новых продуктов ориентирована на учащихся. Это наиболее конкурентный сегмент, потому что здесь уже есть большая аудитория, понятная потребность и привычка платить за образовательные сервисы или устройства. Однако компании используют разные точки входа: ByteDance встроила AI-функции обучения в приложение Doubao, то есть добавила «AI-учителя» в уже популярный пользовательский продукт. iFlytek, Yuanfudao и TAL продолжают развивать AI-устройства для обучения — планшеты и учебные терминалы с диагностикой знаний, персональными планами и тренировками. TAL запустила ученика-агента Xiaojinglong, который ведёт историю обучения, отслеживает усвоение тем и ошибки, а затем предлагает следующие шаги. Gauth Atlas делает ставку на интерактивные карты знаний, а не только на формат «вопрос — ответ». То есть учебные продукты постепенно превращаются из библиотек контента в системы управления учебным процессом. Наиболее быстрорастущим новым направлением стала помощь выпускникам при выборе специальности и подаче заявлений в университеты. В Китае этот процесс особенно важен из-за высокой конкуренции и сложной системы распределения учебных программ. Сразу несколько компаний — New Oriental, Baidu и Quark — представили решения, которые используют AI-агентов, поиск по данным и многошаговый анализ. Они помогают: подбирать университеты и специальности; анализировать шансы на поступление; оценивать риски; сопоставлять баллы, интересы, регион и карьерные перспективы; формировать несколько вариантов стратегии поступления. Раньше такие услуги часто предоставляли частные консультанты. Теперь ИИ пытается занять место посредника в сложном образовательном решении, где пользователю нужен не просто справочник, а персонализированный сценарий выбора. Продуктов для учителей пока немного — упоминаются два решения. Но их фокус показателен: компании не пытаются просто предложить преподавателю чат-бота, а автоматизируют повторяющиеся этапы педагогической работы. Учительские AI-агенты помогают создавать: планы уроков; презентации и учебные материалы; задания и тесты; варианты контрольных работ; анализ успеваемости класса; интерактивные активности для уроков. Например, решения TAL и Feixiang Planet интегрируют ИИ в подготовку, проведение и анализ уроков. Это может снизить административную нагрузку на учителя, но реальная ценность таких продуктов будет зависеть от качества материалов, соответствия учебным программам и того, насколько удобно ими пользоваться в настоящем классе. Сервисы для семейного воспитания и дошкольного образования развиваются медленнее. New Oriental запустила приложение, моделирующее варианты развития ребёнка и последствия различных родительских решений. Zhipu развивает устройства и карточки с AI-функциями для детей от трёх лет и школьников. Этот сегмент перспективен, но особенно чувствителен. Здесь важны безопасность, возрастные ограничения, качество рекомендаций, защита данных ребёнка и недопустимость подмены живого общения цифровым помощником. В новых AI-образовательных продуктах чаще всего встречаются четыре группы возможностей: Персональная диагностика и учебные планы.ИИ выявляет пробелы в знаниях, анализирует ошибки и предлагает последовательность тем и упражнений. Мультимодальное взаимодействие.Учащийся может задавать вопросы голосом, текстом, фотографией задания или через изображение предмета из реального мира. AI-агенты.Они не только отвечают на один запрос, но и выполняют цепочку действий: ищут данные, составляют план, сравнивают варианты, отслеживают прогресс и предлагают следующие шаги. Долгосрочная учебная память.Продукты фиксируют историю занятий, ошибки, уровень освоения тем, домашние задания и поведение в обучении. Это должно повышать качество персональных рекомендаций со временем. Раньше образовательные компании конкурировали главным образом учебными материалами, преподавателями, курсами и каналами продаж. Теперь добавляется новый уровень: способность понимать, как именно учится конкретный человек. Но у рынка есть важное ограничение. Сгенерировать объяснение или решить задачу ИИ может быстро. Доказать, что продукт действительно улучшает знания, повышает мотивацию и помогает учителю, гораздо сложнее. Для этого нужны длительное использование, качественные данные, педагогическая экспертиза и измеримые результаты. Поэтому настоящим конкурентным преимуществом станут не сами языковые модели — они становятся всё доступнее, — а: глубокое понимание образовательных сценариев; накопленные данные о реальном обучении; качественная методика; доверие учащихся, родителей и преподавателей; способность превращать AI-функции в устойчивый учебный результат. Иными словами, в AI-образовании выигрывает не тот, кто быстрее добавил чат-бота, а тот, кто лучше встроил ИИ в долгий и сложный путь обучения.

16Апр

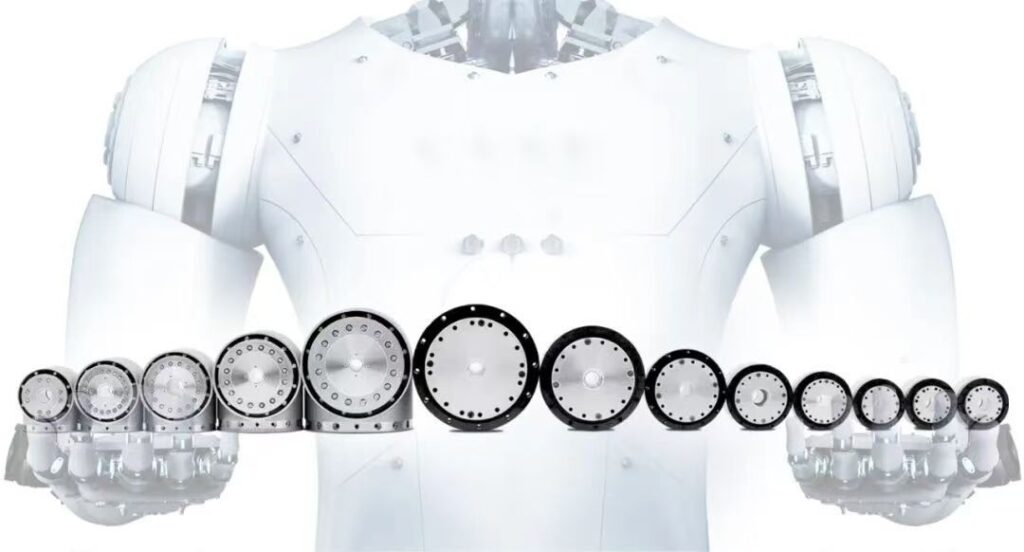
Китайская компания Zero Difference Cloud Control, разрабатывающая ключевые компоненты для роботов, привлекла новый раунд инвестиций объёмом в несколько сотен миллионов юаней. Средства планируется направить на расширение производственных мощностей и выход на зарубежные рынки. Интерес инвесторов отражает сдвиг, происходящий на рынке гуманоидной робототехники: после периода ажиотажа вокруг концепций главным вопросом становится способность стабильно выпускать надёжные компоненты в больших объёмах. Компания специализируется на интегрированных роботизированных суставах — компактных модулях, в которых объединены двигатель, редуктор, энкодер и управляющая электроника. По данным Zero Difference Cloud Control, её выручка в 2025 году выросла более чем вдвое, а в 2026-м компания ожидает сохранения аналогичных темпов. Около 65% прироста обеспечивают заказы из сегмента гуманоидных и воплощённых ИИ-роботов. Производители роботов всё чаще спрашивают уже не о наличии готового образца, а о возможности быстро получить крупную партию компонентов. У крупнейших заказчиков спрос фактически открыт: они готовы закупать столько, сколько поставщик сможет произвести. Однако масштабирование упирается не только в мощности самой компании, но и в возможности поставщиков двигателей, редукторов и других деталей. В отрасли существует и фундаментальная инженерная проблема — своего рода «невозможный треугольник» гуманоидного робота. Очень трудно одновременно добиться трёх характеристик: человеческой подвижности, высокой грузоподъёмности и компактных размеров, близких к размерам тела человека. Если суставы должны быть мощными и обеспечивать много степеней свободы, робот неизбежно становится крупнее. Если сохранить компактность и нагрузку, приходится уменьшать число суставов и жертвовать гибкостью. А попытка объединить компактность с подвижностью обычно снижает допустимую нагрузку. Zero Difference Cloud Control делает ставку не на радикально новые материалы или принципиально другую механику, а на предельную интеграцию уже проверенных решений. Компания предлагает стандартизированные модули разной формы и мощности: самый компактный имеет диаметр около 70 мм, а старшие версии способны развивать крутящий момент до 1180 Н·м. По утверждению производителя, при аналогичной нагрузке удалось сократить осевую длину суставов на 44% и уменьшить массу более чем на 20% по сравнению с распространёнными решениями. Особое значение имеет модульность. Вместо десятков отдельных деталей, необходимых для сборки традиционного манипулятора, компания стремится сводить конструкцию к нескольким стандартизированным блокам. Это уменьшает сложность сборки, снижает вероятность отказов и позволяет быстрее разрабатывать новые модели роботов. Суставы для плеча, локтя или бедра могут устанавливаться как готовые компоненты, а освободившееся пространство в предплечье остаётся доступным для приводов ловких кистей. Более человекоподобная геометрия робота может дать и ещё одно преимущество: возможность использовать существующие базы данных движений человека для обучения ИИ. Если кинематика машины сильно отличается от человеческой, разработчикам приходится создавать собственные системы захвата движений и дорогостоящие наборы данных. При близкой к человеческой анатомии конструкции можно частично опираться на уже накопленные открытые массивы данных движений. При этом отрасль постепенно отходит от полностью индивидуальных решений. Запросы клиентов часто формулируются как «нужен особый продукт», но по сути сводятся к одним и тем же требованиям: легче, мощнее, компактнее, точнее и дешевле. Поэтому производители компонентов стремятся превращать такие запросы в стандартную линейку изделий, оставляя настоящую кастомизацию лишь для специфических условий — например, взрывозащиты или высокой влагозащиты. Главная граница между лабораторным прототипом и коммерческим роботом теперь проходит через цепочку поставок. Выпустить один работающий образец уже недостаточно: необходимо обеспечить повторяемое качество, проверку каждого модуля, обучение персонала и стабильные поставки всех комплектующих. В 2026 году именно способность наращивать производство без потери надёжности становится решающим конкурентным преимуществом для поставщиков компонентов гуманоидных роботов.

16Апр

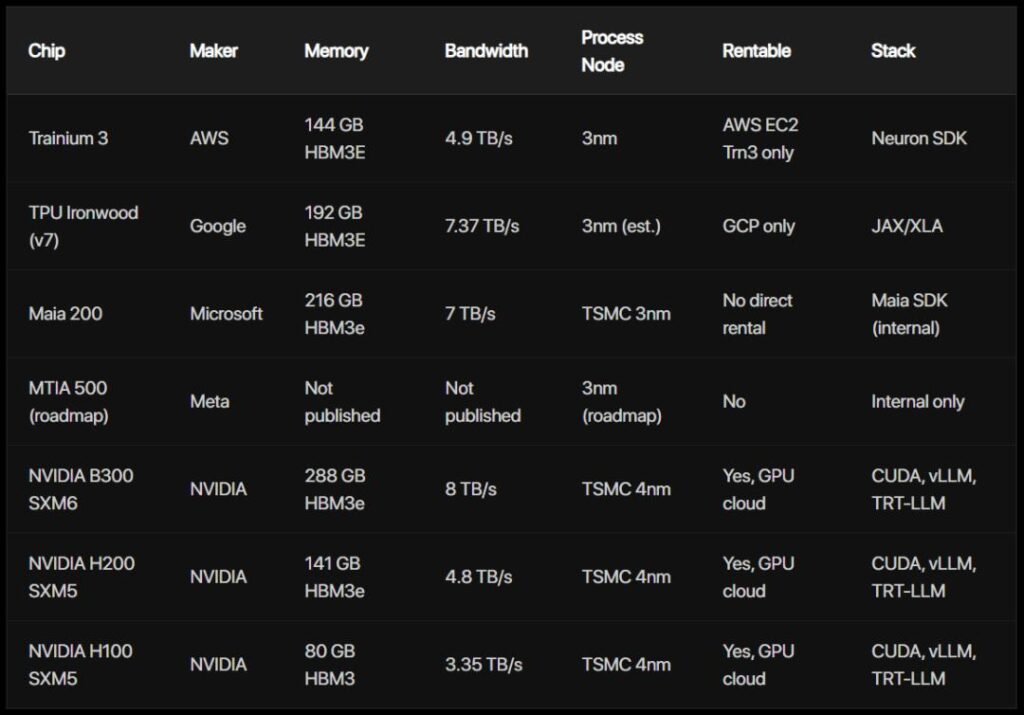
Крупнейшие разработчики искусственного интеллекта всё активнее интересуются созданием собственных процессоров. По сообщениям СМИ, китайские компании DeepSeek и Zhipu изучают разработку специализированных чипов для ИИ-инференса — то есть запуска уже обученных моделей. Аналогичный путь уже выбрали или рассматривают OpenAI и Anthropic. Причина проста: по мере роста спроса на ИИ главным ограничением становятся не только алгоритмы, но и стоимость, доступность и эффективность вычислительных мощностей. Наиболее важный сдвиг в отрасли связан с переходом от обучения моделей к их массовому использованию. Обучение большой модели — дорогостоящий, но относительно ограниченный по времени этап. Инференс же происходит непрерывно: каждый запрос к чат-боту, генерация кода, работа ИИ-агента или обработка документа требуют новых вычислений. Чем больше пользователей и сервисов использует модель, тем выше постоянные расходы на её обслуживание. Именно поэтому компании ориентируются прежде всего на чипы для инференса, а не для обучения. Универсальные GPU хорошо подходят для исследований и экспериментов, когда архитектуры моделей часто меняются. Однако для стабильных, повторяющихся и высокочастотных задач выгоднее специализированные ASIC-чипы. Они создаются под конкретный тип нагрузки и могут обеспечивать более высокую производительность на ватт, меньшую стоимость обработки запросов и более предсказуемую работу инфраструктуры. OpenAI уже продемонстрировала такой подход. В июне компания вместе с Broadcom представила собственный ASIC для инференса больших языковых моделей под названием Jalapeño. По заявлению OpenAI, чип с нуля проектировался для задач LLM: были оптимизированы вычислительные ядра, работа с памятью, сетевые взаимодействия и серверная архитектура. Первые развёртывания ожидаются в конце 2026 года, однако независимые тесты производительности пока не опубликованы. Anthropic также, по данным СМИ, рассматривает создание кастомного чипа и ведёт переговоры с Samsung о возможном производстве на передовом техпроцессе. При этом компания подчёркивает, что её стратегия по-прежнему основана на разнообразном наборе аппаратных платформ от Google, Amazon и Nvidia. Это показывает, что собственные процессоры, скорее всего, не заменят GPU полностью, а станут дополнением для наиболее предсказуемых и масштабных нагрузок. Экономика такого решения становится убедительной лишь при очень больших объёмах. В статье приводится пример платформы Midjourney: после переноса части инференса с GPU Nvidia на TPU Google её ежемесячные расходы на вычисления, по сообщениям источников, снизились примерно с 2,1 млн до 700 тыс. долларов. Для компании, которая выполняет миллиарды запросов ежедневно, даже небольшое снижение стоимости каждого токена может дать огромный финансовый эффект. Особенно быстро растут расходы из-за распространения ИИ-агентов. Обычный чат-бот отвечает на один запрос одним ответом. Агент же может многократно обращаться к модели в рамках одной задачи: анализировать цель, строить план, искать информацию, использовать инструменты, проверять результаты и повторять действия. Поэтому рост агентных систем увеличивает потребление вычислительных ресурсов не линейно, а скачкообразно. Ещё один мотив — стремление снизить зависимость от Nvidia. Компания сохраняет доминирующие позиции на рынке ИИ-ускорителей не только благодаря своим чипам, но и за счёт экосистемы CUDA. Большинство популярных программных инструментов для оптимизации инференса разрабатывались прежде всего под оборудование Nvidia. Переход на альтернативные платформы требует времени, адаптации программного стека и иногда ограничивает выбор моделей. Собственные чипы дают крупным ИИ-компаниям больше контроля над тремя ключевыми параметрами: себестоимостью вычислений, планом развития оборудования и устойчивостью цепочки поставок. Кроме того, наличие альтернативы усиливает позиции компаний в переговорах с внешними поставщиками GPU. Для китайских лабораторий к этим причинам добавляется фактор экспортных ограничений. Доступ к самым современным зарубежным ускорителям может быть ограничен, что делает развитие собственных чипов и сотрудничество с локальными производителями стратегической задачей. По данным публикаций, DeepSeek и Zhipu пока находятся на ранней стадии оценки проектов: готовых продуктов, утверждённых дизайнов и подтверждённых сроков выпуска нет. Однако самостоятельная разработка чипов остаётся рискованным и дорогим предприятием. Проектирование, производство и программная поддержка могут занимать от полутора до двух лет и требовать миллиардных вложений. Специализированный процессор оправдан только тогда, когда нагрузка достаточно велика, стабильна и предсказуема. Для стартапов, исследовательских команд и компаний с разнородными задачами универсальные GPU пока чаще остаются более гибким вариантом. Вероятнее всего, рынок не перейдёт к полному отказу от GPU. Он будет развиваться по гибридной модели: ASIC займут нишу массовых и повторяющихся задач инференса, а GPU сохранят ведущую роль в обучении моделей, исследованиях и задачах, где нужна максимальная универсальность. Тем не менее сама тенденция уже очевидна: в эпоху, когда вычислительная мощность становится стратегическим ресурсом, ведущие ИИ-компании всё меньше готовы полностью зависеть от чужого оборудования.

16Апр

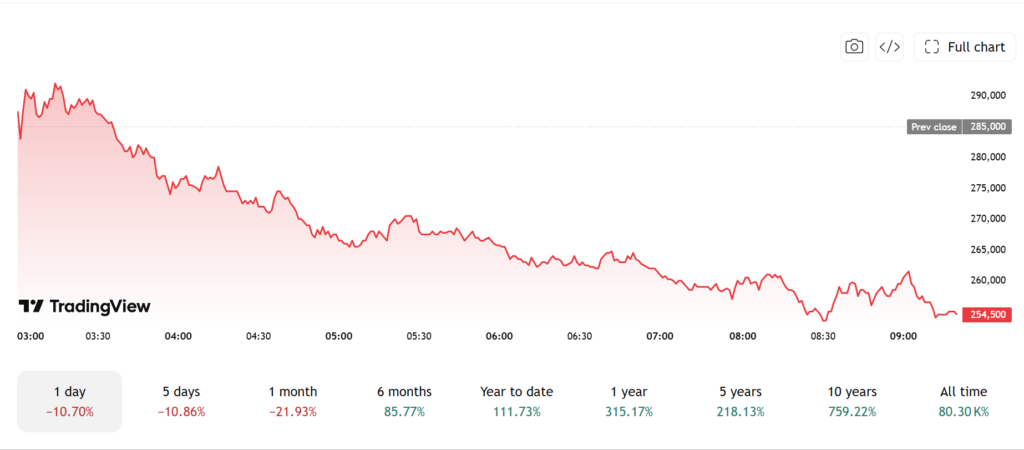
Снижение котировок компаний, выпускающих память, не обязательно говорит о падении спроса на искусственный интеллект. В начале июля акции Samsung, Micron и SanDisk снизились, хотя Samsung ожидала роста операционной прибыли во втором квартале примерно в 19 раз год к году, а прогнозы по контрактным ценам на DRAM и NAND по-прежнему предполагали дальнейшее повышение. Рынок, скорее, начал осторожнее оценивать перспективы сектора памяти после сильного роста, чем получил доказательства ослабления ИИ-спроса. Чтобы понять, сохраняет ли ИИ статус главной рыночной темы, важно смотреть не на один сегмент цепочки поставок, а на общий объём задач, которые пользователи передают системам искусственного интеллекта. Если ИИ берёт на себя всё больше работы, фундаментальный спрос продолжает расти — даже если прибыль временно перераспределяется между производителями чипов, дата-центрами, разработчиками моделей и прикладными сервисами. Прямого биржевого индикатора количества работы, выполняемой ИИ, пока не существует. Однако косвенные показатели остаются сильными. По оценкам Международного энергетического агентства, энергопотребление одной ИИ-задачи в последние годы снижалось не менее чем на 90% ежегодно, однако потребление электроэнергии специализированными ИИ-центрами обработки данных в 2025 году выросло на 50%. Google, в свою очередь, сообщала о росте объёма ежемесячно обрабатываемых токенов примерно в 330 раз за два года. Такое сочетание можно объяснить парадоксом Джевонса: повышение эффективности удешевляет использование ресурса, что расширяет спрос и в итоге может увеличить его суммарное потребление. Иными словами, более дешёвый и быстрый ИИ не обязательно снижает общий спрос на вычисления — он делает возможным большее число сценариев применения. Исследование, показывает, что при снижении цены ИИ-вызовов на 10% объём использования может вырасти примерно на 11%. При этом рост связан не только с числом запросов. Важнее то, что один запрос всё чаще запускает сложную цепочку действий: поиск информации, анализ документов, обращение к внешним инструментам, выполнение задач, проверку результатов и повторные попытки. Именно в этом заключается различие между обычным чат-ботом и ИИ-агентом. В традиционном режиме пользователь задаёт вопрос и получает ответ. В агентном режиме он формулирует цель, после чего система самостоятельно разбивает задачу на этапы и выполняет множество шагов. По данным Anthropic, пользователи, лучше знакомые со своими задачами, не упрощают работу для ИИ, а, наоборот, поручают ему больше последовательных действий. Это означает, что ИИ постепенно переходит от роли помощника, который отвечает на отдельные вопросы, к роли исполнителя более цельных рабочих процессов. Агентные системы требуют заметно больше токенов, чем обычный диалог. В исследовательских сценариях один агент может потреблять примерно в четыре раза больше токенов, чем стандартный чат, а система из нескольких агентов — до 15 раз больше. Несколько агентов могут параллельно искать сведения, проверять источники, выполнять расчёты и передавать результаты главному агенту для итоговой проверки. Часть нынешнего роста токенов, безусловно, неэффективна. Разные модели могут расходовать на одну и ту же задачу объём токенов, различающийся в десятки раз. По мере совершенствования моделей и рабочих процессов количество повторных запусков и лишних шагов будет сокращаться. Однако это не отменяет долгосрочного тренда: если ИИ получает всё более комплексные задачи, общая потребность в вычислениях может продолжать увеличиваться даже при снижении затрат на отдельную операцию. При этом ИИ выходит за пределы программирования. Код стал первым массовым полем для агентов, потому что его легко тестировать: программу можно запустить, получить ошибку, исправить её и снова проверить результат. Но схожая логика появляется и в других профессиях. В биотехнологиях ИИ уже применяется для анализа данных, планирования экспериментов и работы с научными базами. В финансах, юридической сфере, промышленном моделировании и аналитике также существуют правила, инструменты и критерии проверки, на которые можно опираться при создании агентных систем. Ключевой сдвиг происходит в пользовательском поведении. Ранее люди использовали ИИ по схеме «задать вопрос — получить ответ». Теперь они всё чаще передают ему полноценную задачу: собрать данные, проанализировать материалы, проверить цифры, подготовить документ, внести исправления и выдать готовый результат. Когда такой сценарий становится привычной частью рабочего процесса, отказ от ИИ означает возвращение большого объёма рутинной работы обратно человеку. Поэтому основной риск для ИИ-рынка состоит не в краткосрочном падении акций производителей памяти. Настоящий разворот спроса можно будет обсуждать, если модели продолжат улучшаться, стоимость использования будет снижаться, но пользователи перестанут отдавать ИИ новые задачи — или начнут возвращать уже автоматизированную работу людям. Пока же расширяются и глубина задач, и число профессиональных областей, где ИИ становится рабочим инструментом, снижение отдельных акций больше похоже на внутреннюю ротацию рынка, а не на уход капитала из темы искусственного интеллекта.

16Апр

Китайская компания MOVA LINCO, работающая в сфере домашних умных устройств, привлекла ангельские инвестиции на несколько десятков миллионов юаней. Полученные средства будут направлены на разработку базовых ИИ-алгоритмов, подготовку продуктов к массовому производству, развитие международных каналов продаж и создание собственной экосистемы домашнего искусственного интеллекта. Компания формирует линейку устройств вокруг трёх ключевых элементов: интеллектуального роутера, сетевого хранилища NAS и локального вычислительного блока AI Box. В MOVA LINCO называют эту модель «соединение + хранение + вычисления». Идея состоит в том, чтобы превратить разрозненные умные домашние устройства в единую систему, которая не только выполняет команды, но и постепенно учитывает привычки жильцов. Первым продуктом компании станет голосовой ИИ-роутер X1 Pro. В отличие от обычных маршрутизаторов, которые обычно настраиваются лишь через приложение и затем остаются незаметными для пользователя, устройство должно стать центром управления домом. В него встроены специализированный голосовой чип и собственные алгоритмы распознавания речи. Пользователь сможет давать команды естественным языком — например, включить уборку роботом-пылесосом, изменить температуру кондиционера или открыть шторы — без фиксированной фразы активации. Выбор роутера как основы экосистемы неслучаен. Это одно из немногих домашних устройств, которое постоянно подключено к сети и электропитанию, а также поддерживает беспроводную связь с большим числом IoT-гаджетов. Если роутер перестаёт работать, взаимодействие между устройствами умного дома обычно также оказывается нарушено. По мнению разработчиков, именно поэтому он может стать естественной точкой входа для домашнего ИИ. X1 Pro будет поддерживать Mesh-сети для покрытия больших квартир, двухуровневых домов и коттеджей. Также устройство получит четыре проводных порта на 2,5 Гбит/с — это важно для сценариев с потоковым видео высокого разрешения, передачей крупных файлов и локальными мультимедийными библиотеками. Второй компонент системы — AI NAS UP6, домашнее сетевое хранилище, которое компания ранее показывала на CES 2026. Оно предназначено для хранения семейных фото, видео, документов и других цифровых материалов. Устройство оснащено шестидюймовым сенсорным дисплеем с разрешением 2K и может настраиваться без смартфона или компьютера. Среди ключевых функций заявлены поиск файлов на естественном языке, голосовое управление, автоматическая классификация видео и поиск фрагментов по объектам, людям или событиям. Третьим элементом должна стать AI Box — локальный центр вычислений. Он будет распределять ресурсы между устройствами умного дома: обрабатывать распознавание лиц камерами, строить маршруты для роботов-пылесосов, интерпретировать голосовые команды и выполнять другие ИИ-задачи. Такой подход позволяет переносить часть обработки данных из облака в дом пользователя. В концепции MOVA LINCO роутер отвечает за связь и сбор потоков данных, NAS — за их долговременное хранение, а AI Box — за локальную обработку и принятие решений. Вместе эти устройства должны дать ИИ возможность перейти от простого реагирования на команды к более проактивной помощи: например, учитывать типичные сценарии использования техники и автоматически предлагать подходящие действия. Выход AI-роутера X1 Pro и хранилища AI NAS UP6 на зарубежные рынки запланирован на вторую половину 2026 года; параллельно ожидается запуск версий для китайского рынка. Компания рассчитывает на производственную и компонентную базу Шэньчжэня и района Большого залива, где сосредоточены крупные поставщики электроники. Разработчики также учитывают различия между регионами. Для рынков Европы и США важны дальность Mesh-покрытия, работа через перегородки, поддержка VPN и совместимость с распространёнными протоколами умного дома Matter и Thread. В Китае больший акцент предполагается сделать на устойчивости связи в домах с железобетонными стенами, управлении сетевыми ресурсами и интеграции с локальными IoT-брендами. Таким образом, MOVA LINCO делает ставку не на одиночное умное устройство, а на создание базового слоя для домашнего ИИ. Успех этой стратегии будет зависеть от того, сможет ли компания объединить безопасность локального хранения, удобство голосового управления, доступную цену и совместимость с уже существующими устройствами пользователя.

16Апр

Рынок воплощённого искусственного интеллекта — роботов, способных действовать в реальном мире, — сталкивается с острым дефицитом данных. Чтобы машина научилась складывать одежду, открывать шкафы, завязывать шнурки или сортировать товары, ей нужны миллионы часов записей человеческих действий. На этом фоне в Китае быстро растёт целая индустрия по сбору и продаже таких данных. Сборщики данных, которых иногда называют «тренерами роботов», выполняют обычные бытовые задачи, но делают это в специальном оборудовании: с несколькими камерами или датчиками движения. Каждый поворот руки, захват предмета и перемещение фиксируются для дальнейшего обучения моделей. За такую работу платят около 250 юаней в день, то есть примерно 30 юаней в час. При этом сотрудники часто сталкиваются с техническими сбоями, долгой настройкой устройств и жёсткими требованиями к объёму пригодных записей. Собранные материалы проходят проверку, разметку и стандартизацию, после чего посредники продают их робототехническим компаниям уже по 300–500 юаней за час. Наиболее ценными считаются данные, полученные при управлении настоящим роботом через VR-устройства или экзоскелеты: их стоимость может достигать 500–1000 юаней за час. Так один и тот же набор действий — например, складывание полотенца — превращается из низкооплачиваемой подработки в дорогой цифровой актив. Причина высокого спроса — огромный разрыв между потребностями отрасли и существующим предложением. По оценкам участников рынка, для создания робота с навыками, близкими к человеческим, могут потребоваться порядка миллиарда часов реальных данных, тогда как доступный мировой объём составляет лишь несколько миллионов часов. Интернет-данные, полезные для языковых моделей, здесь не решают проблему: роботу необходимы трёхмерные записи взаимодействия с физическими объектами. Наибольшую выгоду пока получают не только производители роботов, но и поставщики данных. Они могут многократно перепродавать один и тот же качественно обработанный набор нескольким клиентам, повышая маржу в разы. Поэтому компании, специализирующиеся на данных для воплощённого ИИ, привлекают крупные инвестиции и получают высокие оценки. Пока робототехнические стартапы тратят значительные средства на разработку «железа», поставщики данных уже строят бизнес на главном дефиците новой индустрии — реальном человеческом опыте.

16Апр

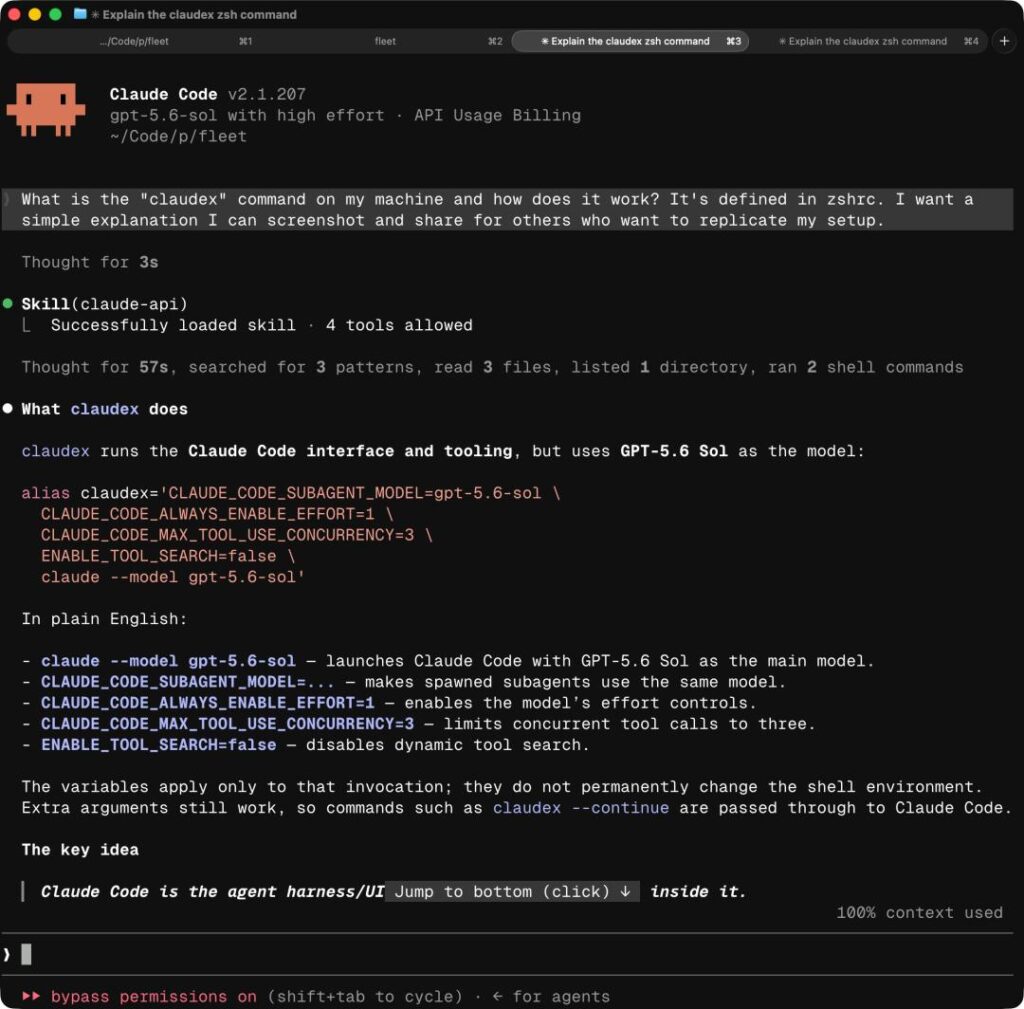
Конкуренция между OpenAI и Anthropic всё заметнее выходит за пределы сравнения самих моделей. Теперь борьба идёт за привычную среду работы разработчиков — интерфейсы, инструменты и ежедневные сценарии использования ИИ для программирования. Поводом для обсуждения стал пост одного из руководителей OpenAI, который публично предложил разработчикам использовать GPT-5.6 Sol непосредственно в Claude Code — среде Anthropic для разработки с ИИ. Для этого достаточно настроить прокси-инструмент, подключить учётные данные Claude и Codex, а затем перенаправить запросы Claude Code на модель OpenAI. В результате пользователь может сохранить привычный интерфейс Claude Code, но выбирать между моделями Anthropic и OpenAI. С технической точки зрения идея не нова: современные инструменты разработки всё чаще позволяют подключать разные модели через API, прокси и совместимые интерфейсы. Однако публичная поддержка такого сценария со стороны OpenAI важна символически. Она показывает, что компания готова конкурировать не только за пользователей собственного приложения Codex, но и за пользователей чужой экосистемы. Фраза представителей OpenAI о том, что компания «не выбирает конкретный интерфейс», отражает новую реальность рынка. Для многих разработчиков сам инструмент — терминал, редактор кода или агентная среда — становится важнее, чем модель, работающая внутри него. Если разработчик привык каждый день открывать Claude Code, он может не захотеть менять рабочий процесс ради другой модели. Но если GPT можно подключить в уже знакомую среду, барьер перехода резко снижается. На этом фоне Anthropic, как отмечает источник, продлила бесплатный доступ к своей модели Fable 5 ещё на неделю. Такие решения также можно рассматривать как попытку удержать пользователей в собственной экосистеме и не дать им переключиться на альтернативные сервисы в период особенно высокой конкуренции. В материале приводятся и примеры проектов, созданных с применением GPT-5.6 Sol: от визуализации данных и интерфейсов до игровых прототипов, авиасимулятора и сложных веб-приложений. В подобных задачах модель используется не просто как автодополнение кода, а как часть более широкого процесса: она помогает продумывать архитектуру, моделировать логику работы системы, писать код и дорабатывать результат. Главный вывод состоит в том, что рынок ИИ-разработки постепенно разделяется на два уровня. На первом конкурируют сами модели — по качеству рассуждений, программирования, скорости и стоимости. На втором идёт борьба за «точку входа»: интерфейс, привычки пользователя, интеграции и рабочий процесс. Если модель можно сменить за несколько минут, то долгосрочное преимущество получает не только тот, у кого сильнее алгоритм, но и тот, чья среда становится ежедневным рабочим местом разработчика.

16Апр

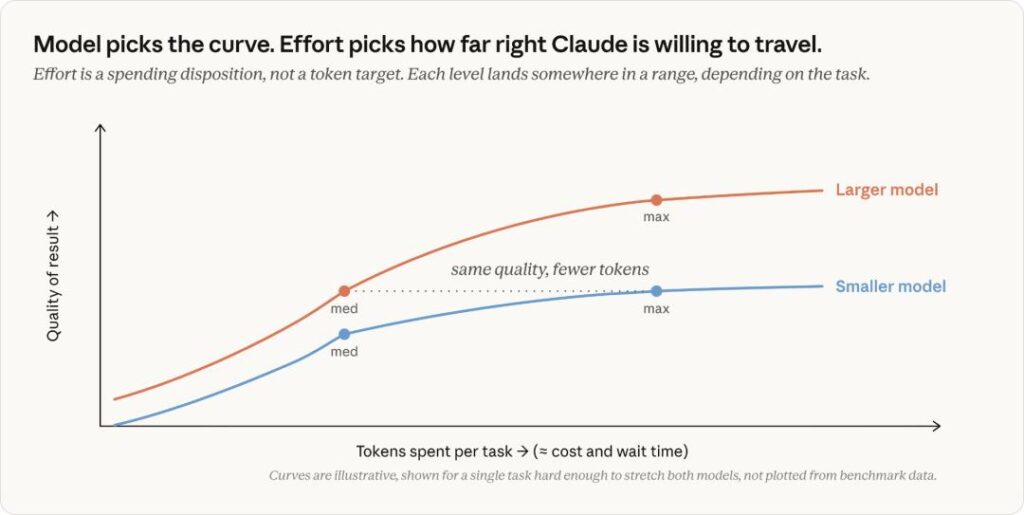
Пользователи ИИ-инструментов для программирования часто считают, что качество результата определяется только выбранной моделью: чем она крупнее и дороже, тем лучше должна писать код. Однако опыт пользователей Claude Code показывает, что это упрощение может быть дорогостоящим. Anthropic отдельно объяснила разницу между двумя настройками: Model и Effort. Первая определяет базовые способности модели, а вторая — то, насколько тщательно она будет выполнять конкретную задачу. Условно говоря, модель — это «мозг», а уровень усилий — её «рабочий режим». Модель задаёт фундаментальные возможности системы: знания, навыки рассуждения, способность понимать сложные архитектуры и решать нетиповые задачи. После обучения параметры модели фиксируются. Пользователь может дать ей документацию, кодовую базу или инструкции, но не может изменить её внутренние знания. Если модель не понимает незнакомую технологию или стабильно выдаёт неверное решение даже при полном контексте, увеличение усилий не поможет — вероятно, нужна более сильная модель. Настройка Effort, напротив, влияет на объём работы, который Claude готов выполнить в рамках одного запроса. При низком уровне система скорее даст быстрый ответ, запросит дополнительную информацию или остановится на промежуточном результате. При высоком — будет читать больше файлов, вызывать инструменты, запускать тесты, перепроверять выводы и дольше доводить многошаговую задачу до конца. Именно из-за этой разницы в начале марта возникло недовольство среди пользователей Claude Code. Anthropic снизила стандартный уровень Effort с high до medium, чтобы уменьшить задержки. Многие разработчики восприняли это как ухудшение самой модели: ИИ стал пропускать файлы, не запускать тесты, бросать задачу на середине и чаще задавать уточняющие вопросы. По данным, обсуждавшимся в сообществе, в отдельных сценариях объём внутренней работы мог заметно сократиться. Позже компания вернула более высокий уровень по умолчанию. Главный вывод: если ИИ ошибается, не стоит автоматически переключаться на самую дорогую модель. Сначала важно проверить контекст. Чётко ли сформулирована задача? Есть ли у агента нужные файлы, доступы, инструменты, правила проекта и документация? Значительная часть проблем возникает не из-за «слабого ИИ», а из-за неполной постановки задачи. После этого полезно определить характер ошибки. Если агент не прочитал нужные файлы, не выполнил тесты, не проверил результат или преждевременно вернулся с вопросами, проблема может быть в недостаточном Effort. В таком случае разумнее повысить уровень усилий. Если же система получила полный контекст, использовала доступные инструменты и всё равно не смогла решить задачу, тогда есть смысл перейти на более сильную модель. Этот подход меняет саму логику работы с ИИ-разработчиками. Вместо поиска одного «самого умного» помощника появляется задача диспетчеризации: простые правки можно поручать более дешёвой модели в быстром режиме, крупный рефакторинг — модели посильнее с высоким уровнем Effort, а самые сложные задачи — специализированной модели, способной работать дольше и подключать дополнительные агенты. При этом высокий Effort не является бесплатным. Он может увеличивать число сгенерированных токенов в несколько раз, поскольку ИИ больше читает, проверяет и вызывает инструменты. Поэтому оптимальная стратегия — не всегда использовать максимальный режим, а выбирать сочетание модели и усилий под конкретную задачу. В результате ключевым навыком становится не только умение писать запросы, но и умение грамотно распределять задачи между ИИ-агентами. Дорогая модель, запущенная в поверхностном режиме, может оказаться менее полезной, чем более доступная модель, которой дали достаточно контекста, времени и права тщательно проверить свою работу.

Если у вас есть инновационная идея, мы будем рады реализовать ее для Вас!

Специалисты нашей кампании и наши разработки для вас!