Новости

Социальные сети

Узнайте больше о рынке It и новейших технологиях.
СТАТЬИ
16Апр

Стремительное развитие генеративных моделей для создания видео делает задачу выявления подделок все более сложной. Если еще несколько лет назад детекторы могли опираться на характерные визуальные артефакты, то современные модели, такие как Sora, Veo, Kling и другие, способны создавать ролики кинематографического качества, в которых традиционные признаки генерации практически незаметны. На этом фоне исследователи из Университета искусственного интеллекта имени Мохамеда бин Заида (MBZUAI), Китайского народного университета и Гарвардского университета представили обзорную работу, в которой предлагают пересмотреть сам подход к обнаружению AI-видео. Статья уже принята к публикации на конференции ACL 2026. Авторы считают, что задача больше не должна сводиться к простому ответу «настоящее видео или сгенерированное». Вместо этого предлагается концепция «проверки фактической достоверности» (Fact Fidelity Verification), при которой система должна объяснять, на каких доказательствах основан ее вывод и соответствует ли содержание ролика реальному миру. Исследователи выделяют три основных типа современных AI-видео: локально измененные реальные записи (например, дипфейки с заменой лица); видео с изменением аудио, речи или синхронизации губ; полностью сгенерированные ролики, созданные с нуля современными генеративными моделями. Для анализа таких материалов предлагается четырехуровневая система проверки. Первый уровень занимается поиском низкоуровневых визуальных признаков: анализируются шумы изображения, текстуры, особенности сжатия, физиологические сигналы человека (например, моргание или едва заметные движения лица), а также другие статистические отклонения. Второй уровень оценивает пространственно-временную согласованность видео. Здесь проверяется, насколько естественно меняются объекты, движения, освещение и поведение персонажей на протяжении всего ролика. Даже качественно сгенерированные видео могут содержать ошибки в длинных последовательностях кадров или нарушать физическую логику происходящего. Третий уровень анализирует соответствие различных модальностей между собой. Система сравнивает изображение, звук, речь, субтитры и текстовое описание, выявляя несоответствия между движением губ, голосом, содержанием речи и визуальным рядом. Самый высокий, четвертый уровень предполагает проверку содержания с использованием мировых знаний и логического рассуждения. На этом этапе система должна определить, соответствует ли происходящее законам физики, общеизвестным фактам, причинно-следственным связям и здравому смыслу. Авторы предлагают использовать для этого большие мультимодальные модели и специализированные ИИ-агенты, способные обращаться к внешним источникам информации и формировать объяснимую цепочку доказательств. Исследователи подчеркивают, что будущие системы проверки должны не просто выдавать вероятность того, что видео создано искусственным интеллектом, а предоставлять прозрачное обоснование своих выводов. Такой подход особенно важен в условиях, когда AI-контент становится все сложнее отличить от реальной съемки, а ошибочные решения могут привести как к распространению дезинформации, так и к ложному обвинению подлинных видеоматериалов в использовании генеративного ИИ. По мнению авторов, надежная проверка AI-видео потребует объединения достижений компьютерного зрения, обработки естественного языка, мультимодальных моделей и систем логического вывода. Только сочетание анализа изображения, понимания контекста и проверки фактов позволит создавать действительно объяснимые и устойчивые инструменты для выявления синтетического видеоконтента.

16Апр

Тема рекурсивного самоулучшения искусственного интеллекта, еще недавно считавшаяся скорее теоретической концепцией, постепенно становится частью практической разработки современных AI-систем. Об этом в последние месяцы все чаще говорят руководители ведущих исследовательских лабораторий, включая генерального директора Google DeepMind Демиса Хассабиса. По словам Хассабиса, сегодня практически все крупнейшие AI-компании работают над автоматизацией исследований и созданием систем, способных помогать в разработке следующих поколений моделей. Однако одновременно он признает, что перспектива полного исключения человека из этого цикла вызывает у него серьезные опасения с точки зрения безопасности. Во время конференции Google I/O Хассабис заявил, что человечество уже находится «у подножия сингулярности», а ближайшие годы могут стать решающими для подготовки к эпохе искусственного общего интеллекта (AGI). Он считает нынешнее развитие AI-агентов своего рода испытанием перед появлением значительно более мощных систем. Одним из признаков этой тенденции называют так называемое «мягкое рекурсивное самоулучшение». Речь идет не о полностью автономном создании новых моделей ИИ, а о ситуации, когда существующие модели все активнее помогают инженерам разрабатывать, тестировать и совершенствовать программное обеспечение, включая инструменты самого искусственного интеллекта. Anthropic ранее сообщала, что к маю 2026 года более 80% изменений в ее программном коде создавались при участии Claude. При этом окончательные решения о принятии изменений по-прежнему принимают разработчики, а сама статистика не означает полностью автономную разработку без участия человека. По данным компании, использование AI значительно повысило производительность инженерных команд. Если ранее на выполнение отдельных задач уходили недели, то теперь многие процессы занимают считанные дни благодаря автоматизации написания, анализа и тестирования кода. Сооснователь Anthropic Джек Кларк также обращает внимание на изменение характера работы программистов. По его мнению, искусственный интеллект постепенно берет на себя наиболее трудоемкие этапы разработки — поиск ошибок, исправление кода и оптимизацию. Это позволяет специалистам сосредоточиться на постановке задач и контроле результатов. Однако именно ускорение процесса разработки вызывает вопросы у исследователей безопасности. Если системы начнут самостоятельно проектировать и совершенствовать новые поколения ИИ, скорость технологического прогресса может существенно возрасти. В таком случае даже небольшие ошибки в первоначальных целях или ограничениях модели способны со временем привести к непредсказуемым последствиям. Некоторые исследователи предлагают замедлить наиболее рискованные направления развития и создать механизмы международного контроля за разработкой сверхмощных моделей. В частности, Anthropic ранее выступала с инициативой проверяемых механизмов ограничения развития наиболее передовых AI-систем. Однако добиться подобной координации между крупнейшими игроками отрасли будет непросто, поскольку конкуренция в сфере искусственного интеллекта продолжает усиливаться. Несмотря на громкие заявления о приближении «сингулярности», специалисты подчеркивают, что пока речь идет прежде всего об ускорении существующих процессов разработки, а не о появлении полностью автономного сверхразумного ИИ. Тем не менее автоматизация исследований и программирования уже становится одним из ключевых направлений развития отрасли и может существенно изменить скорость создания новых технологий в ближайшие годы.

16Апр

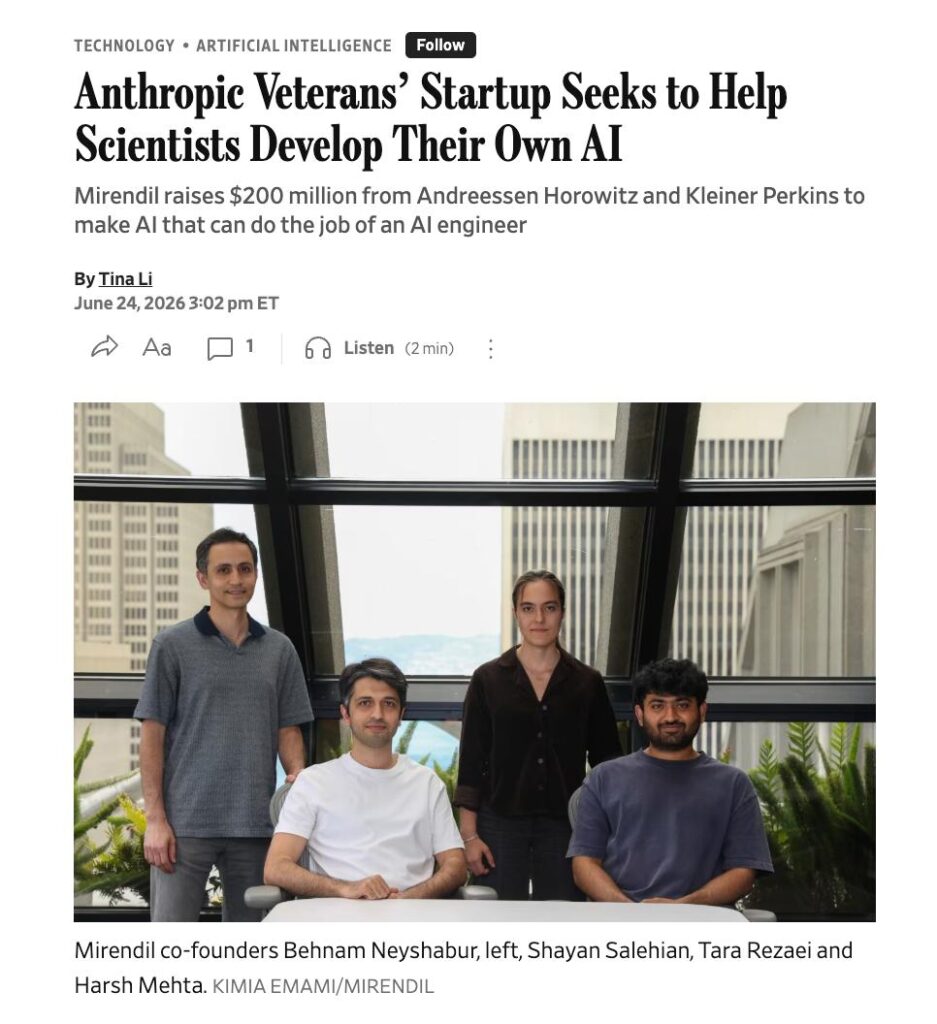
Бывшие сотрудники Anthropic Бенам Нейшабур (Behnam Neyshabur) и Харш Мехта (Harsh Mehta) объявили о запуске собственного ИИ-стартапа Mirendil, который уже на стадии посевного раунда привлек $200 млн инвестиций. После завершения финансирования компания получила оценку в $1 млрд, став одним из самых дорогих молодых проектов в сфере искусственного интеллекта. В число инвесторов вошли Andreessen Horowitz (a16z), Kleiner Perkins и NVIDIA. Команду Mirendil составляют около 20 исследователей и инженеров, ранее работавших в Anthropic, OpenAI, Google DeepMind и xAI. Главная цель стартапа — разработка технологий «рекурсивного самоулучшения» (Recursive Self-Improvement), при которых системы искусственного интеллекта способны самостоятельно совершенствовать собственные модели и инструменты под контролем человека. По мнению основателей, именно такой подход позволит значительно ускорить научные исследования. В отличие от традиционной концепции «AI for Science», когда ИИ помогает ученым решать исследовательские задачи, Mirendil делает ставку на создание платформы, которая позволит самим научным коллективам разрабатывать и обучать специализированные модели искусственного интеллекта для своих областей — от медицины до материаловедения. В качестве примера основатели приводят создание моделей для прогнозирования риска болезни Альцгеймера без зависимости от универсальных решений крупных технологических компаний. Идея проекта сформировалась задолго до его запуска. Нейшабур и Мехта познакомились еще в Google в 2019 году, где их объединил интерес к использованию ИИ для ускорения научных открытий. Позднее оба перешли в Anthropic, а в конце 2025 года, вскоре после выхода модели Claude Opus 4.5, решили покинуть компанию и основать собственный бизнес. По их словам, именно прогресс современных ИИ-агентов убедил их в том, что необходимые технологии наконец достигли достаточного уровня зрелости. Создатели Mirendil считают, что на рынке существует свободная ниша. Крупные разработчики активно используют искусственный интеллект для собственных исследований, однако зачастую ограничивают применение своих моделей для обучения конкурирующих систем. Это открывает возможности для независимых компаний, которые смогут предложить научным организациям инструменты для создания собственных ИИ-решений. В ближайшие месяцы Mirendil планирует представить первый продукт и начать тестирование платформы с участием первых пользователей. В долгосрочной перспективе компания рассчитывает стать технологической основой для тысяч исследовательских лабораторий, работающих над наиболее сложными научными задачами современности.

16Апр

В 2026 году мировая технологическая отрасль столкнулась с новой масштабной волной сокращений. По данным сервиса Layoffs.fyi, с начала года более 202 технологических компаний объявили об увольнении свыше 120 тысяч сотрудников — почти столько же, сколько было сокращено за весь 2025 год. При этом другая аналитическая платформа, TrueUp, оценивает число затронутых работников уже более чем в 153 тысячи. В отличие от кризисной волны увольнений 2022–2023 годов, вызванной переизбытком найма после пандемии и ухудшением экономической ситуации, нынешние сокращения происходят на фоне высоких доходов и устойчивых финансовых показателей крупнейших игроков рынка. Основной причиной все чаще становится перераспределение ресурсов в пользу развития искусственного интеллекта. Одним из наиболее показательных примеров стала Oracle. Согласно годовому отчету компании, за последние 12 месяцев численность персонала сократилась примерно на 21 тысячу человек — с 162 до 141 тысячи сотрудников. В документах для регуляторов компания прямо указала, что внедрение технологий искусственного интеллекта уже привело и может в дальнейшем привести к сокращению штата. Похожие процессы происходят и в других крупных компаниях. В течение года о сокращениях сообщили Microsoft, Google, Amazon, Meta, Cisco, IBM, Dell, Salesforce, PayPal, Intuit, GitLab, Coinbase, Atlassian и ряд других корпораций. Во многих случаях руководство открыто объясняет изменения тем, что развитие генеративного ИИ и ИИ-агентов позволяет автоматизировать значительную часть рутинной работы. При этом речь идет не просто об экономии расходов. Многие компании одновременно увольняют сотрудников и активно набирают специалистов по искусственному интеллекту. Так, Meta сократила около 8 тысяч человек, одновременно переведя примерно 7 тысяч сотрудников на проекты, связанные с ИИ. IBM сообщила о замещении части HR-функций интеллектуальными агентами, параллельно увеличивая набор инженеров по искусственному интеллекту. General Motors после сокращений продолжает искать специалистов в области ИИ, автономного транспорта и высокопроизводительных вычислений. Наибольшему риску сегодня подвергаются сотрудники, занятые в административных подразделениях, службах поддержки, обработке данных, кадровых службах и других направлениях, где задачи могут быть стандартизированы и автоматизированы. Одновременно растет спрос на инженеров по машинному обучению, разработчиков больших языковых моделей, специалистов по инфраструктуре ИИ, центрам обработки данных и вычислительным системам. Аналогичные тенденции постепенно проявляются и в Китае. В последние месяцы в социальных сетях регулярно появляются сообщения о сокращениях в ByteDance, Alibaba, Meituan и других крупных компаниях, хотя официально большинство подобных слухов не подтверждается. Вместе с тем сами компании продолжают активно расширять команды, работающие над фундаментальными моделями, видеогенерацией и облачными ИИ-платформами. В частности, генеральный директор ByteDance Лян Жубо недавно заявил о намерении сократить число непрофильных направлений бизнеса и сосредоточить ресурсы на развитии искусственного интеллекта. Эксперты отмечают, что далеко не каждое сокращение действительно связано с внедрением ИИ. Ранее генеральный директор OpenAI Сэм Альтман предупреждал, что некоторые компании используют искусственный интеллект как удобное объяснение заранее запланированных организационных изменений, хотя реальная роль ИИ в этих процессах может быть значительно скромнее. Тем не менее общий тренд становится все более очевидным. Искусственный интеллект меняет не только технологии, но и структуру занятости в отрасли. Компании все чаще отказываются от повторяющихся и легко автоматизируемых функций, одновременно инвестируя в специалистов нового поколения. Поэтому речь идет не столько о сокращении рабочих мест в целом, сколько о масштабной перестройке требований к квалификации сотрудников и всей кадровой структуры технологического сектора.

16Апр

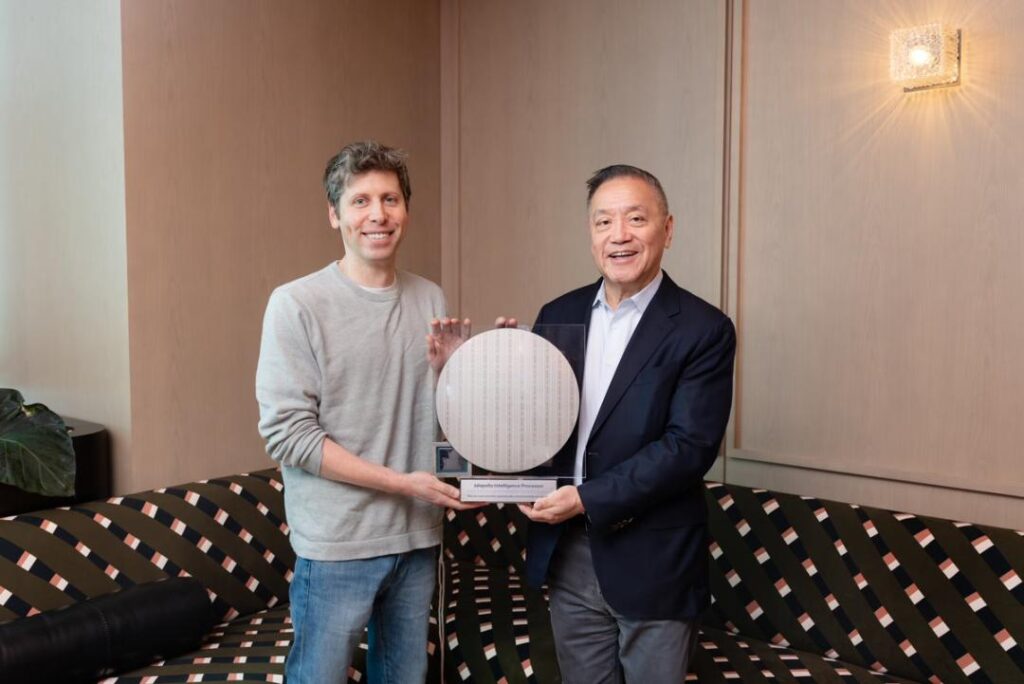
OpenAI объявила о разработке своего первого специализированного чипа для выполнения выводов (инференса) больших языковых моделей. Новый процессор получил название Jalapeno и был создан совместно с Broadcom и производителем серверного оборудования Celestica. В компании заявляют, что Jalapeno разрабатывался специально для обслуживания таких продуктов, как ChatGPT, Codex и будущих AI-агентов. В отличие от универсальных графических процессоров (GPU), новый ASIC оптимизирован исключительно для выполнения задач вывода больших языковых моделей, что должно повысить эффективность использования вычислительных ресурсов. По данным OpenAI, от начала проектирования до изготовления первого опытного образца прошло около девяти месяцев — компания называет это одним из самых быстрых циклов разработки высокопроизводительных специализированных микросхем подобного класса. Первые развертывания чипов планируются к концу 2026 года в дата-центрах Microsoft и других партнеров. Разработкой проекта руководил Ричард Хо (Richard Ho), ранее входивший в команду Google TPU. Он также работал в компании Lightmatter, занимающейся фотонными вычислениями, и имеет большой опыт в проектировании специализированных ускорителей для искусственного интеллекта. По словам OpenAI, архитектура Jalapeno оптимизирована не только с точки зрения вычислительной мощности, но и с учётом пропускной способности памяти, сетевого взаимодействия и перемещения данных между компонентами системы. Компания считает, что именно такая комплексная оптимизация позволяет приблизить реальную производительность к теоретическим возможностям оборудования. Broadcom отвечала за проектирование кремниевой части и сетевой инфраструктуры, включая использование собственных высокоскоростных сетевых решений для масштабирования вычислительных кластеров. Компания рассматривает этот проект как начало строительства дата-центров нового поколения с вычислительной мощностью на уровне гигаватт. На момент объявления OpenAI не опубликовала независимых результатов тестирования производительности. Компания лишь сообщила, что предварительные испытания показали значительное улучшение показателя производительности на ватт по сравнению с существующими решениями, а инженерные образцы уже используются для запуска одной из внутренних моделей семейства GPT. Подробные технические характеристики обещают представить позднее. Появление Jalapeno продолжает общую тенденцию среди крупнейших разработчиков искусственного интеллекта. Ранее собственные AI-ускорители представили Google (TPU), Amazon (Inferentia и Trainium) и Microsoft (Azure Maia). Кроме того, ранее сообщалось, что Anthropic также изучает возможность создания собственного специализированного чипа. Таким образом, крупнейшие клиенты NVIDIA постепенно начинают разрабатывать собственные процессоры для ИИ. Основная причина — стремление снизить зависимость от стороннего поставщика, лучше контролировать стоимость вычислений и оптимизировать оборудование под собственные модели. В OpenAI называют такой подход частью стратегии создания «полного технологического стека» (full-stack advantage), при котором компания контролирует не только модели и программное обеспечение, но и ключевые элементы вычислительной инфраструктуры. По мнению руководства компании, по мере роста роли искусственного интеллекта вычислительные мощности становятся одним из важнейших стратегических ресурсов, что делает развитие собственной аппаратной платформы все более значимым направлением.

16Апр

OpenAI объявила о выпуске обновленной модели GPT-5.5 Instant, которая сначала станет доступна подписчикам ChatGPT, а затем — бесплатным пользователям. Новая версия заменит GPT-5.3 Instant в качестве модели по умолчанию и будет использоваться для большинства повседневных запросов в сервисе. Главная цель обновления — повысить качество ответов без увеличения времени отклика. По данным OpenAI, новая модель стала заметно точнее в задачах, связанных с медициной, правом и финансами, а также снизила количество фактических ошибок. Кроме того, улучшены результаты в математике, научных задачах и мультимодальном анализе. Одним из наиболее заметных изменений станет стиль общения модели. Ответы стали короче и более структурированными: разработчики сократили объем избыточных пояснений, длинных списков и шаблонных фраз, сделав взаимодействие более естественным и лаконичным. GPT-5.5 Instant также получила улучшенное понимание изображений, более точный веб-поиск и качественную обработку технических запросов, включая программирование, перевод и решение STEM-задач. Еще одной особенностью модели стал механизм интеллектуальной маршрутизации запросов. Простые задачи обрабатываются в режиме быстрого ответа, а при необходимости более глубокого анализа система автоматически использует режим расширенного рассуждения без участия пользователя. Такой подход позволяет сохранять высокую скорость работы в повседневных сценариях, одновременно повышая качество ответов на сложные вопросы. Запуск новой модели происходит на фоне изменения стратегии OpenAI. В последние месяцы компания все активнее развивает инструменты для автоматизации рабочих процессов и AI-агентов, стремясь превратить ChatGPT из чат-бота в универсальную рабочую платформу. При этом улучшение модели по умолчанию должно сохранить привлекательность сервиса для массовой аудитории, которая редко переключается между различными моделями вручную. Обновление также отражает усиливающуюся конкуренцию на рынке генеративного ИИ. OpenAI сталкивается с растущим давлением со стороны Anthropic, Google и других разработчиков, а пользователи все чаще оценивают не только максимальные возможности моделей, но и удобство повседневной работы, скорость отклика и качество пользовательского опыта. В результате стратегия компании постепенно смещается от демонстрации исключительно рекордных результатов в тестах к комплексному улучшению продукта. Вместо гонки за количеством параметров все большее значение приобретают точность, лаконичность ответов, эффективность использования вычислительных ресурсов и удобство использования в реальных сценариях. На фоне зрелости рынка больших языковых моделей именно такие обновления могут стать одним из ключевых факторов удержания пользователей и дальнейшего распространения технологий искусственного интеллекта среди массовой аудитории.

16Апр

С развитием генеративного искусственного интеллекта традиционные CAPTCHA перестают эффективно отличать людей от ботов. В ответ Google, по данным СМИ, тестирует новую версию системы reCAPTCHA, в которой для подтверждения личности пользователю необходимо записать короткое видео с жестом — например, помахать рукой перед камерой. Во время проверки система анализирует движение руки, отслеживая около 21 ключевой точки, включая положение ладони и суставов пальцев. Предполагается, что такой механизм позволит эффективнее бороться с автоматической регистрацией аккаунтов, подбором учетных данных и другими видами мошенничества. Причина изменений проста: современные модели искусственного интеллекта научились успешно решать классические CAPTCHA. Если раньше защита строилась на распознавании искаженного текста или выборе изображений, то мультимодальные модели сегодня способны понимать визуальную информацию почти так же хорошо, как человек. Исследование Калифорнийского университета в Ирвайне, опубликованное в 2024 году, показало, что ИИ распознает CAPTCHA с точностью более 95%, тогда как показатели людей составляют от 50 до 86% в зависимости от сложности задания. Новая система делает ставку не на усложнение головоломок, а на использование того, что пока остается непростой задачей для ИИ, — точного воспроизведения движений человеческой руки. Из-за большого количества суставов, разнообразия возможных поз и взаимного перекрытия пальцев рука считается одним из самых сложных объектов для компьютерного зрения. Именно поэтому ошибки при генерации рук до сих пор встречаются даже у современных моделей создания изображений. Кроме того, требование использовать камеру повышает стоимость создания автоматизированных систем для злоумышленников, поскольку им придется имитировать не только поведение пользователя, но и реалистичное видео с движением руки. Однако идея уже вызвала дискуссию о конфиденциальности. Несмотря на заявления Google о том, что изображения и видеозаписи после проверки не сохраняются и не используются для других целей, часть пользователей опасается, что подобные технологии могут стать первым шагом к массовому сбору биометрических данных. Эксперты отмечают, что даже если система хранит лишь координаты ключевых точек, а не сами изображения, потенциальная возможность связать эти данные с конкретным пользователем вызывает вопросы о защите персональной информации. Дополнительные опасения связаны с тем, что крупные технологические компании уже использовали взаимодействие пользователей для обучения своих алгоритмов. В частности, ранние версии reCAPTCHA помогали оцифровывать тексты и размечать данные. В то же время сбор данных о движении рук может иметь и практическую ценность для развития мультимодальных моделей. Сегодня объем открытых датасетов с изображениями и жестами рук значительно уступает наборам данных для распознавания лиц, что ограничивает возможности ИИ при генерации изображений и видео. Таким образом, переход от традиционных CAPTCHA к анализу жестов отражает новую реальность: по мере того как искусственный интеллект становится лучше в решении привычных задач проверки, интернет-сервисам приходится искать более сложные способы подтверждения того, что перед ними действительно находится человек. Одновременно это усиливает дискуссию о балансе между безопасностью и защитой приватности пользователей.

16Апр

Вокруг новых флагманских моделей Anthropic и OpenAI вновь возникла волна обсуждений после того, как некоторые пользователи сообщили о временном появлении модели Claude Fable 5 в приложении Claude Code. Скриншоты и видеозаписи быстро распространились в социальных сетях, породив предположения о возобновлении тестирования модели. По словам пользователей, Fable 5 отображалась в списке доступных моделей и могла выполнять отдельные задачи, связанные с программированием, включая работу с Git и генерацию SVG-графики. Однако вскоре сотрудники Anthropic заявили, что официального повторного запуска не происходило, а появление модели, вероятно, было связано с ошибкой пользовательского интерфейса. Несмотря на это, некоторые разработчики также сообщили о возможности увидеть упоминания Fable 5 в инфраструктуре Amazon Web Services (AWS), хотя доступ к модели требовал дополнительной авторизации. Это лишь усилило предположения о том, что Anthropic может постепенно готовить модель к новому этапу ограниченного тестирования. Официального подтверждения этой информации пока нет. Claude Fable 5 привлекла большое внимание сообщества еще во время первых демонстраций благодаря высокой производительности при решении сложных задач программирования. Пользователи отмечали способность модели работать с очень крупными проектами, генерировать игровые прототипы и создавать приложения практически без дополнительных подсказок. После того как доступ к модели был ограничен, в профессиональном сообществе регулярно появлялись слухи о ее скором возвращении. На фоне этих сообщений появились и новые сведения о GPT-5.6. По информации ряда СМИ, OpenAI готовится выпустить модель в формате ограниченного предварительного доступа. Ожидается, что первые пользователи будут подключаться поэтапно после индивидуального согласования доступа, а не через традиционный массовый запуск. Такой подход, как сообщается, связан с дополнительными требованиями к оценке безопасности наиболее мощных моделей искусственного интеллекта. Если обе компании действительно перейдут к поэтапному развертыванию своих флагманских моделей, это может стать новой практикой для отрасли. Вместо одновременного глобального релиза разработчики все чаще выбирают ограниченные программы предварительного доступа, позволяющие постепенно расширять аудиторию пользователей по мере завершения необходимых проверок. При этом значительная часть информации о сроках запуска и возможностях новых моделей по-прежнему основана на утечках, сообщениях пользователей и публикациях профильных СМИ. Ни Anthropic, ни OpenAI пока не объявили официальные даты широкого запуска своих новых флагманских моделей.

16Апр

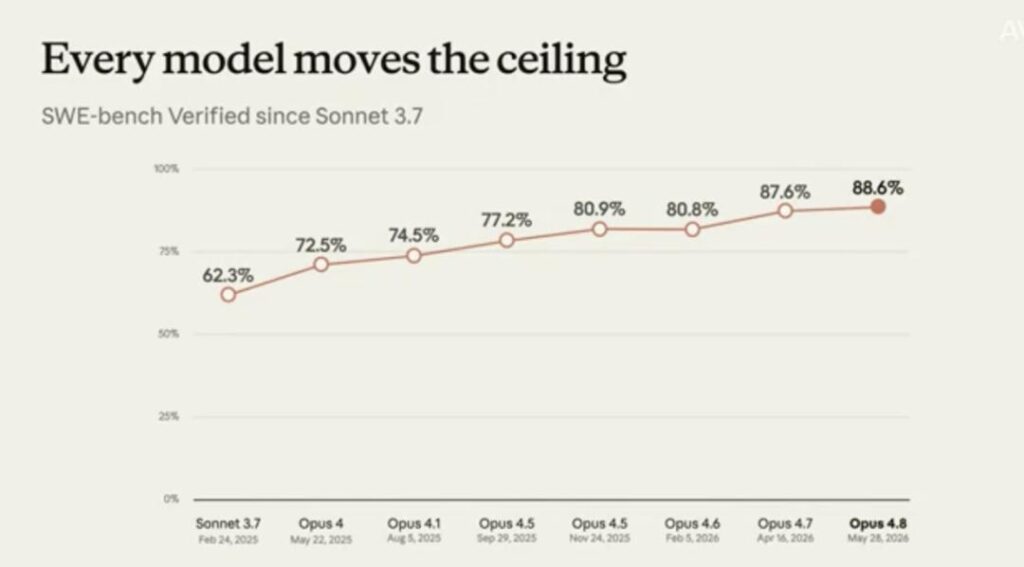
Продакт-менеджер исследовательской команды Anthropic Теодора Чу (Theodora Chu) рассказала о том, как меняется роль больших языковых моделей в разработке программного обеспечения. По ее словам, Claude уже перестал быть просто инструментом для генерации кода и становится полноценным участником инженерного процесса. Одним из самых заметных фактов стало заявление о том, что сегодня более 80% изменений, попадающих в кодовую базу Anthropic, создаются с помощью Claude. При этом речь идет не о полностью автономной разработке: модель помогает писать код, однако итоговые проверки и интеграция изменений по-прежнему находятся под контролем команды разработчиков. По словам Чу, главным отличием современных AI-агентов становится способность работать в замкнутом цикле — не только выполнять задачу, но и самостоятельно проверять результат, получать обратную связь, исправлять ошибки и продолжать работу до достижения нужного результата. В компании называют такой подход «Close the Loop» («замкнуть цикл»). Anthropic отмечает, что за последний год возможности моделей заметно выросли. Внутренние оценки показывают значительное улучшение результатов на тестах по программной инженерии. При этом разработчики считают более важным не рост итоговых баллов, а снижение числа ошибок, поскольку именно это позволяет поручать моделям более продолжительные и сложные задачи. По наблюдениям компании, современные модели также лучше справляются с планированием работы. Если предыдущие поколения часто сразу приступали к написанию кода, то новые версии сначала анализируют задачу, строят план действий и лишь затем начинают реализацию. Такой подход позволяет уменьшить количество лишних действий и повторных исправлений. Еще одним важным изменением стала способность моделей восстанавливаться после ошибок. Ранее AI нередко попадал в так называемый «цикл повторения», когда после неудачи многократно пытался использовать один и тот же неэффективный способ решения. Теперь модели лучше анализируют причины неудач и способны выбирать альтернативные стратегии. Кроме того, современные системы значительно увереннее работают с большими объемами информации. Это позволяет передавать модели целые проекты или крупные фрагменты кода вместо отдельных файлов, сохраняя целостное понимание задачи на протяжении длительной работы. На основе этого опыта Anthropic рекомендует разработчикам пересмотреть подход к созданию AI-продуктов. В частности, компания советует регулярно обновлять собственные системы оценки качества моделей, поскольку задачи, которые были сложными год назад, сегодня уже могут не отражать реальные возможности современных ИИ. Еще одна рекомендация касается так называемых «строительных лесов» (scaffolding) — большого количества дополнительных инструкций, ограничений и вспомогательной логики, которыми разработчики окружали ранние модели. По мере роста возможностей ИИ такие конструкции могут не только перестать приносить пользу, но и ухудшать результаты, поэтому их стоит постепенно упрощать. Наконец, в Anthropic считают, что наиболее эффективные AI-агенты должны иметь возможность самостоятельно проверять результаты своей работы. Для этого модели необходимо предоставить доступ к инструментам тестирования, взаимодействию с интерфейсом приложения и другим механизмам, позволяющим оценивать качество выполненной задачи без постоянного участия человека. По мнению компании, именно сочетание планирования, самопроверки, исправления ошибок и длительной автономной работы станет основой следующего поколения интеллектуальных программных агентов, способных выполнять все более сложные задачи в реальной среде разработки.

16Апр

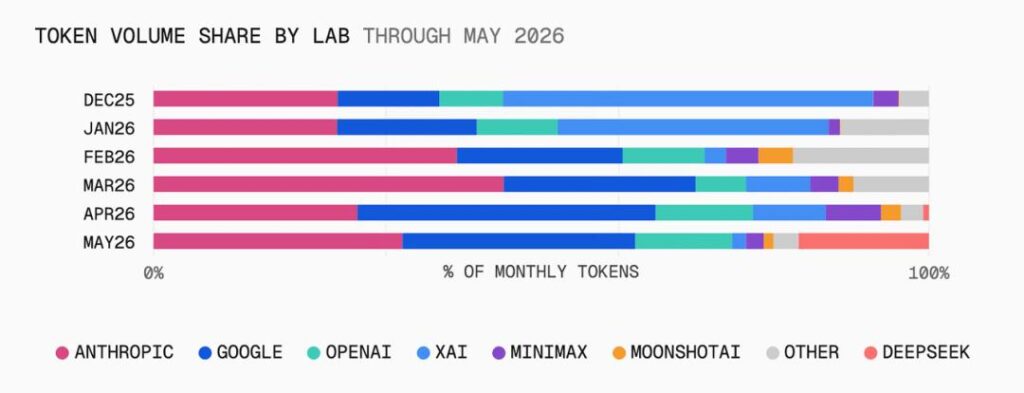
Американская компания Lindy, разрабатывающая платформу для создания AI-агентов, объявила о полном переходе своей производственной инфраструктуры с моделей Anthropic на DeepSeek V4. По словам основателя и генерального директора компании Фло Кривелло (Flo Crivello), это решение позволит ежегодно экономить миллионы долларов на вычислительных расходах, а в ряде ключевых сценариев новая модель показала даже лучшие результаты. Lindy позволяет компаниям без программирования создавать AI-ассистентов для обработки электронной почты, планирования встреч, работы с CRM, подготовки документов и других офисных задач. Для подобных сервисов расходы на инференс становятся одной из крупнейших статей бюджета. Ранее Кривелло сообщал, что затраты на работу языковых моделей уже превысили расходы компании на заработную плату сотрудников. По его словам, переход на DeepSeek не был спонтанным. Команда изучала альтернативы Anthropic на протяжении шести–девяти месяцев, тестируя различные открытые модели, включая решения китайских разработчиков. В итоге выбор пал на DeepSeek V4, который компания начала использовать после серии внутренних испытаний. При этом миграция оказалась значительно сложнее, чем ожидалось. Кривелло отметил, что фактический объем работ оказался примерно в сто раз больше первоначальных оценок. Замена модели потребовала не только изменения API, но и переработки всей экосистемы вокруг нее: настройки промптов, систем оценки качества, мониторинга, маршрутизации запросов и проверки пользовательского опыта. Для оценки результатов команда проводила как автоматические тесты, так и ручную проверку ответов моделей. После поэтапного внедрения разработчики отслеживали влияние новой модели на качество сервиса и удержание пользователей. Несмотря на полный переход производственной нагрузки на DeepSeek, Lindy не отказалась от Anthropic полностью. Сотрудники компании продолжают использовать Claude в повседневной работе благодаря выгодной подписке, а наиболее сложные задачи при необходимости могут передаваться более мощным моделям Anthropic в качестве резервного варианта. Решение Lindy отражает более широкую тенденцию на рынке искусственного интеллекта. Если еще недавно компании выбирали модели главным образом по их возможностям, то теперь все большее значение приобретает стоимость эксплуатации. По мере того как разрыв в качестве между ведущими закрытыми и открытыми моделями сокращается, многие разработчики начинают искать баланс между производительностью и расходами. Эту тенденцию подтверждает и статистика рынка. По данным Vercel AI Gateway, доля DeepSeek в общем объеме токенов, обработанных платформой, за один месяц выросла менее чем с 1% до 17%. При этом доля выручки осталась около 1%, что отражает значительно более низкую стоимость использования модели по сравнению с конкурентами. По мнению Кривелло, компаниям, ежедневно обрабатывающим огромные объемы запросов, приходится задавать себе практический вопрос: стоит ли платить в несколько раз больше за небольшое преимущество в качестве модели. Для Lindy ответ оказался однозначным — если сопоставимый результат можно получить значительно дешевле, переход становится экономически оправданным. История Lindy показывает, что конкуренция на рынке больших языковых моделей постепенно смещается от гонки возможностей к борьбе за эффективность. Если раньше главным преимуществом считалась максимальная производительность, то сегодня одним из ключевых факторов выбора становятся совокупная стоимость владения и способность модели обеспечивать необходимое качество при минимальных затратах.

Если у вас есть инновационная идея, мы будем рады реализовать ее для Вас!

Специалисты нашей кампании и наши разработки для вас!