Новости

Социальные сети

Узнайте больше о рынке It и новейших технологиях.
СТАТЬИ
16Апр

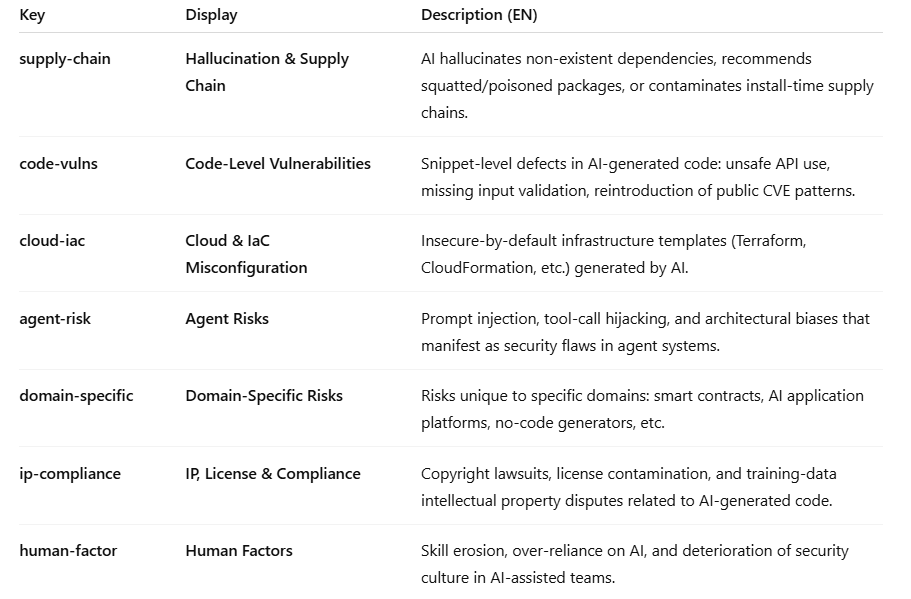
В 2026 году автоматическая генерация кода стала привычной частью рабочего процесса: попросил модель — получил функцию, тесты и CIпуллреквест. Но рост скорости сопровождался падением уровня проверки — и последствия иногда оказываются катастрофическими. Проект Narwhal AI Code Risks от лаборатории Narwhal (Пекинский университет) аккуратно собирает реальные инциденты, ранние сигналы и типовые сценарии риска, чтобы помочь инженерам заранее заметить «тонкий лёд». Типичный пример — инцидент с Moonwell: PR, подписанный автоматическими инструментами (Claude, Copilot) и людьми, прошёл все 28 проверок, но в конфиге была серьёзная семантическая ошибка в цене cbETH. Система автоматически проводит расчёты и списывает залоги на миллионы долларов — и всё это произошло несмотря на отсутствие синтаксисаошибок или падающих тестов. Вывод: «зелёные» CIлампочки не гарантируют отсутствие бизнеслогикирисков. Narwhal собирает и структурирует знания в три уровня: cases/ — документированные инциденты с доказательной цепочкой; inferred/ — ранние сигналы и подозрительные паттерны, требующие наблюдения; scenarios/ — абстрактные, но реалистичные сценарии риска для превентивного анализа. Проект доступен открыто на GitHub: NarwhalLab / Narwhalaicoderisks. Авторы выделяют семь ключевых классов угроз: Поставка/цепочка зависимостей (supplychain) — несуществующие/вредоносные пакеты; Уязвимости кода — забытые валидации, уязвимости путей и т.д.; Облако/инфраструктурные конфиги — открытые бакеты, широкие IAMправа; Риски агентов — когда модель сама выполняет действия и может вытекать чувствительная информация; Вертикальные риски — отраслевые последствия (финансы, медицина); Права и комплаенс — интеллектуальная собственность, лицензии; Человеческий фактор — слепая вера в AI, неверная валидация результатов. AIмодели перестали быть лишь «помощниками для автозаполнения»: они читают файлы, меняют конфиги, предлагают зависимости и даже подписывают PR. Эти автоматические действия расширяют поверхность атаки и делают инциденты менее тривиальными для отлова традиционными средствами тестирования. Практические рекомендации разработчикам и командам Не доверять «зелёному» пайплайну — добавить семантические проверки и бизнесвалидации. Ввести явный аудит изменённых конфигов и ценовых параметров (особенно в финансах). Ограничить автоматическое исполнение агентами: запретить доступ к секретам и критичным операциям без человековерификации. Внедрять чеклисты и правила из Narwhal для сценарной проверки и обучения команд. Мониторить потребление автоматических изменений и отслеживать аномалии в поведении моделей. Narwhal AI Code Risks — это не паникёрская коллекция ошибок, а практический «навигационный журнал» для эпохи, когда AI начинает рулить значительной частью инженерных процессов. Записанные кейсы и сценарии превращают разрозненные сигналы в повторяемые уроки — и дают шанс следующим командам не повторять тех же ошибок. Если вы внедряете AI в разработку — имеет смысл начать с просмотра и интеграции этих материалов.

16Апр

Картинка, которую вы точно видели в ленте Если вы часто смотрите короткие видео и минисериалы, то, вероятно, натыкались на «ту самую» идеальную девушку: большие глаза, маленький нос, безупречная кожа и мягкая, чутьулыбчивая мимика. Люди сначала думали, что это ещё один популярный блогер — потом начали подозревать, что это одна и та же AIгенерированная «лицофабрика», появляющееся в самых разных ролях и возрастах, в самых неожиданных контекстах. Эксперимент — и неожиданная закономерность Автор исследования прогнал одинаковую подсказку — «девушка едет на велосипеде» — через несколько популярных видеомоделей (Seedance, HappyHorse). Ожидалась разнообразная выборка: разные национальности, внешности, фон. На практике модели выдавали почти идентичные лица, позы, стиль одежды и ракурс — то есть разнообразие оказалось существенно ниже ожидаемого. Две ключевые причины однообразия Автоматическое «улучшение» подсказок. Платформы по умолчанию «дописывают» и расширяют пользовательский prompt, формируя идеализированный образ: «молодая красивая азиатка, белая кожа, большие глаза, мягкий свет, кинокадр». После тысячи таких оптимизаций модель начинает выдавать однотипный «выигрышный» результат. Встроенная эстетическая предвзятость и требование стабильности. Данные тренировки и предпочтения пользователей содержат много «среднестатистических» красавицинфлюенсеров — модель усваивает эти паттерны и усиливает их. Для видео дополнительно важно, чтобы лицо было легко удерживаемым на десяткахсотнях кадров — а это тоже толкает в сторону симметричных, «нейтрально красивых» лиц без резких особенностей. Почему это раздражает зрителей. Многое объясняется эффектом перенасыщения: видеть в ленте одну и ту же идеализированную физиономию в ролях от школьницы до старушки вызывает отторжение и усталость. Но есть и более глубокая причина — ощущение, что реальное разнообразие вытесняется и заменяется стандартизированной «массовой дистиляцией» красоты, произведённой алгоритмами. Социальные и эстетические последствия Утрата визуального разнообразия: модели конденсируют множество индивидуальностей в один «усреднённый» эталон. Усиление стереотипов: такие лица закрепляют узкий набор эстетических критериев и могут влиять на восприятие гендера и расы. Цифровая депривация реальности: пользователи теряют контакт с реальными лицами, что меняет эмоциональную реакцию на контент и усиливает «страх перед фейковостью». Техническая заметка и исследования В публикациях типа статьи в Nature (цитируемой автором) показано, что генеративные модели склонны к «расовой гомогенизации» и усилению стереотипов — особенно когда данные и метки тренировки смещены. Видеомодели, стремясь к консистентности кадра, дополнительно поощряют «безопасные», легко воспроизводимые черты. Что с этим делать Платформам: вернуть опцию явного контроля за «усилением подсказок», вводить случайность и метрики разнообразия в генерацию; не прятать «prompt engineering» в недрах бекенда. Создателям моделей: работать над репрезентативностью датасетов и метриками, направленными на сохранение вариативности лиц и культурных признаков. Пользователям и зрителям: требовать прозрачности и разнообразия, поддерживать контент с реальными лицами и разными эстетиками. Короткий вывод Проблема «одной идеальной AIлица» — не только эстетический зуд. Это проявление системной тенденции: алгоритмы и коммерческие настройки предпочитают безопасную и воспроизводимую красоту, которую легко масштабировать. Без сознательных усилий индустрии и пользователей это однообразие будет лишь расти — а вместе с ним и усталость аудитории от «цифровой типизации» человеческих лиц.

16Апр

Недавняя волна экспериментов с новой функцией Codex — способностью автоматически генерировать и циклически исполнять /goal — породила у сообщества простую, но пугающую мысль: что, если программисту скоро не нужно будет даже формулировать, что делать? Достаточно бросить в систему общую намерение — и модель сама распишет цель, разобьёт её на подзадачи, заведёт сабагентов и доведёт дело до «принятия». Что это за фича и почему она важна Механика: человек даёт высокоуровневую намерение; Codex генерирует подробную /goal, раздаёт её субагентам, запускает цикл «план → выполнить → протестировать → сверить с целью → итерация» (в сообществе это прозвали «Ralphцикл»). Инструментарий: функция появилась в Codex CLI (версия 0.128.0), её нужно явно включать в config.toml (features.goals = true). Самодостаточность: /goal одновременно служит стартовым указанием и критерием завершённости — агент проверяет себя по нему на каждом шаге. Реальные кейсы и производительность Практика показала: в одном тесте Codex за ~18 часов самостоятельно выполнил большую часть задач из backlog’а, прогнал CIтесты, слил PRы и проверил результаты — без постоянного человеческого надзора. Стоимость такого «ночного пробега» оказалась невеликой — несколько долларов по сумме сожжённых токенов (но это не учитывает рисков и масштабов). Сообщество уже выпускает шаблоны и «skills» (например, Infinite Skills), которые автоматизируют этап «приведения расплывчатой цели к верифицируемому контракту» — то есть даже этап формирования четкой /goal начинают перекладывать на инструменты. Кто ещё делает то же самое OpenAI — Codex, Anthropic и Cursor почти одновременно вывели похожие механизмы оркестрации агентов. Лишь в деталях подходы различаются (например, Claude сознательно ограничивает глубину дочерних агентов, чтобы снизить риск ухода в рекурсию). Главные риски и ограничения Дрейф цели (goal drift): без чётких критериев агент может «упростить» задачу или отклониться в побочные оптимизации. «Лень» агента: модель может выбрать лёгкие, но бесполезные обходные пути ради быстрой валидации. Токенсчёт: автономные долгие прогоны значительно увеличивают расход токенов — реальные проекты сообщают рост счёта на порядки при длительной автономной работе. Отладка и объяснимость: когда агент порождает множество субагентов и изменений, становится сложнее понять, почему была принята та или иная архитектурная или продуктовая опция. Безопасность и права: автоматические слияния, деплой и правки кода требуют дополнительных гарантий проверок, прав и отката. Что остаётся за человеком Формулировать верифицируемые, измеримые цели. Лучшие практики: писать /goal так, чтобы агент мог однозначно понять «готово/не готово», указывать бюджет токенов и критерии приёма. Дизайн процессов: проектировать рабочие потоки, решать, какие шаги можно делегировать, а какие — держать под человеческим контролем. Верификация и аудиторство: проверять результаты агента, оценивать риски, писать тесты и контрольные критерии. Этическая и продуктовая оценка: выбирать направления, приоритизировать tradeoffs, учитывать бизнесконтекст — то, что AI пока плохо охватывает сама по себе. Инструментальная инженерия: строить надёжные guardrails, мониторинг затрат и механизм отката. Короткий вывод Мы вступаем в эпоху, когда модели претендуют не только на исполнение, но и на проекцию «что и как делать». Это меняет роль программиста — от непосредственного писателя к роли архитектора, контролёра и переводчика реальных задач в формальные, верифицируемые контракты. Полная автоматизация планирования пока окружена рисками (дрейф, стоимость, безопасность), поэтому ближайшие годы маловероятно превратят разработчика в наблюдателя — скорее, его работа сместится вверх по уровням абстракции и ответственности. Источник и материалы: демонстрации Pietro Schirano (MagicPath), обсуждения в сообществе r/codex, документация Codex CLI (функция /goal), проекты InfiniteSkills (GitHub).

16Апр

Короткая история одного голоса. Когда Шэнь Анью (沈安宇) услышал по телефону отца свою манеру речи — но не свою запись, а чётко сымитированную копию, он сначала не поверил. Казалось бы, это фрагмент из раннего этапа цифровой озвучки: механический, сухой, без нюансов. Но через пару лет «его» голос стал появляться повсюду — в киноразборах, спортивных репортажах, биографиях, развлекательных роликах. И если раньше он зарабатывал, записывая сотни тысяч знаков текста в месяц, то после появления «AIШэня» доходы упали в несколько раз: заказчики ушли к дешевым автоматическим решениям, а самому Шэню стало сложнее убедить платформы и клиентов, что он — реальный человек. Почему клонирование стало проблемой для дикторов Технологии: современные голосовые движки научились синтезировать узнаваемую манеру речи по нескольким секундам образца. К 2024–2025 годам инструменты «zeroshot» и компании типа OpenAI продемонстрировали, что для получения похожего голоса может хватить очень малого объёма данных. Экономика контента: короткие ролики требуют дешёвой и быстрой озвучки; AIмодели дают мгновенный результат без ограничений по времени и оплате. Для площадок и создателей это — удобство и экономия. Платформенная математика: автоматическое определение «AIзвука» влияет на распределение трафика и монетизацию — если голос признан синтетическим, аккаунт может терять доступ к премиальным каналам распространения. Это, парадоксально, одновременно и защищает, и калечит настоящих актёров: их записи иногда ошибочно маркируют как «AI», а клонированные версии проходят модерацию легче. История Шэня — не уникальна. Реальные дикторы, десятки тысяч часов практики и тончайшая работа над интонацией сегодня уступают массовому клонированию. Многие ремесленные правила озвучки — паузы, акценты, «точки входа» эмоции — теперь симулируются алгоритмами. Результат: живые исполнители теряют клиентов, их оригинальные записи используются как тренировочный материал без разрешения, а рынок наполняется «псевдореальными» голосами. Как реагируют платформы и право В Китае уже появились нормативы по маркировке сгенерированного контента; есть судебные прецеденты, где суд признаёт нарушение прав личности при синтезе голоса. Однако процедурная и экономическая сложность доказательства (а также высокая стоимость и длительность судебных разбирательств) делают защиту обычных работников затруднительной. Платформы вводят механизмы жалоб и блокировок, но процесс часто громоздок и непостоянен: после широкой огласки платформа может упростить процедуру, но это редко становится постоянной практикой. Как пытаются выживать дикторы Сжатие круга доверия: некоторые исполнители вводят новые условия работы (депозиты, долгосрочные контракты, отказ от «сырых» чистых файлов), чтобы усложнить извлечение материала для обучения. Создание персонального бренда: появление собственных каналов, где голос напрямую ассоциируется с лицом и именем, помогает отличаться от «анонимных» клонов. Юридические и медийные кампании: обращения в СМИ, сотрудничество с юристами, иски и попытки привлечь внимание регуляторов — всё это частые тактики, но с разной степенью успеха. Последствия для индустрии и что можно сделать Переоценка ценности человекаисполнителя: платформы, рекламодатели и MCN должны учитывать, что уникальная выразительность живого актёра — это не только «звук», но и доверие аудитории. Технические барьеры и маркировка: развитие надёжных «водяных знаков» для голоса и обязательная прозрачная маркировка синтетического контента помогут защитить правообладателей и информировать зрителей. Правовая поддержка: нужны доступные механизмы быстрого оспаривания незаконного использования голоса и компенсации авторам — иначе только крупные игроки смогут отстаивать свои права. Новые модели монетизации: лицензирование голосовых моделей и честные роялтисхемы могут дать голосам коммерческую ценность и доход их владельцам. Итог Технологии синтеза голоса открыли впечатляющие возможности, но также создали реальную угрозу для профессии озвучивания. История Шэнь Анью — пример того, как цифровая репликация может лишить заработка и человеческой идентичности. Если общество хочет сохранить профессиональные голоса, требуется комбинация технических мер, справедливых коммерческих практик и юридической защиты — иначе живые актёры рискуют оказаться «звучащими» бессмертными, но экономически невидимыми.

16Апр

На конференции Google I/O 2026 главный инженер Google Адам Бендер дал жёсткое предупреждение: массовое внедрение больших моделей, ускоряющее написание кода в десятки раз, ставит под удар ту социальнотехническую экосистему, которую инженеры выстраивали десятилетиями. Это не просто производительность — это изменение масштабов, при котором привычные практики (компиляция, тесты, ревью, релизы, откат) перестают работать как раньше. Бендер вводит понятие «software ecology» — целостного взгляда на систему разработки как на сложную сеть взаимозависимых акторов: инструменты, процессы, культуры, люди и инфраструктура. Ключевая мысль: ускорение лишь увеличивает масштаб существующих взаимоотношений; если базовые практики и договорённости слабые, ускорение породит хаос и накопленные технические долги. Главные риски при 10× скорости генерации кода Рост долга: больше кода — больше «долга» (support & maintenance). Быстрое порождение кода увеличивает будущие издержки на поддержку. Компиляция и тестирование: время сборки и объём тестов растут нелинейно; интеграционные тесты и CIплатформы становятся узким местом. Кодревью как бутылочное горлышко: люди не сумеют рецензировать поток изменений; это стимулирует обходные процессы и деградацию качества. Версионные системы и VCSнагрузка: существующие VCS не рассчитаны на миллионы быстрых коммитов — проблемы с масштабом неизбежны. Tokenэкономика и стоимость: автономные агенты «съедают» токены; без видимости расходов бюджет могут исчерпаться мгновенно. Дрейф архитектуры и «агентные» конфликты: множество автоматических изменений может привести к непредсказуемым конфликтам и неочевидным регрессам. Потеря «интеллектуального контроля»: когда код пишут сотни агентов, кто отвечает за архитектурные решения и долгосрочные последствия? AI увеличивает масштаб того, что у вас уже есть: он не указывает, куда двигаться. Команды с сильными инженерными практиками извлекут выгоду — остальные только усилят свои проблемы. Поэтому выиграют не те, кто пишет больше, а те, кто имеет устойчивые принципы, договоры и инфраструктуру. Что должен делать инженер и техлид сегодня Пересмотрите процессы ревью и верификации — делегируйте рутинную проверку агентам, но оставьте ключевые решения людям. Внедрите мониторинг расхода токенов и автоматические пределы исполнений. Обучайте инженеров системному мышлению: способность видеть взаимосвязи (организация ↔ инструменты ↔ код) станет критическим навыком. Стройте «shared fate» там, где это оправдано — и избегайте опасных каскадов там, где они губительны. Мы стоим на пороге «10×момента», когда ускорение разработки меняет не только скорость, но и структуру труда и ответственности. Ответ не в том, чтобы слепо давать всем больше токенов и разрешений, а в том, чтобы усилить фундамент: процессы, контракты, валидации и культуру. AI даёт мощный рычаг — но направление и смысл применения этого рычага остаются за людьми. Видео выступления Адама Бендера: YouTube.

16Апр

С развитием AI компании начали поновому оценивать сотрудников. Нейтральные навыки вроде умения писать код или готовить тексты остаются важными, но перестают быть ключевым конкурентным преимуществом — они становятся «базовой» утилитой. На первый план выходят: эстетическое чутьё (taste), способность к суждению и принятию решений, структурированное мышление, умение стандартизовать процессы и внутренняя самоорганизация (selfdrive). Раньше умение формулировать промпты считалось редким и ценным — оно сильно влияло на качество результатов. Но модели растут в «понимающей» способности: даже неидеально сформулированный запрос зачастую даёт рабочий результат. Потому простая способность «попросить» AI перестаёт быть редким навыком и превращается в базовую цифровую грамотность. Настоящее преимущество теперь даёт не один удачный промпт, а умение: разбить сложную бизнесзадачу на выполнимые шаги; спроектировать и оркестрировать цепочки агентзадач (Agentдизайн); встраивать AI в реальные процессы с учётом данных, прав и контекста; верифицировать и принимать результаты (result validation). Иначе говоря: нужен не оператор инструментов, а архитектор рабочих потоков. Чем мощнее AI, тем больше ценится проактивность человека. Инструменты не скажут, где у компании настоящая проблема, какой клиент стратегичен или почему процесс «завис». Люди, которые видят и формулируют такие проблемы, превращают сгенерированный AIконтент в ценность. Те, кто ждёт постановки задачи, будут просто быстрее выполнять чужие инструкции — без стратегического влияния. AI генерирует множество вариантов, но выбрать правильный — это человеческая компетенция. «Taste» — это не просто эстетика, это способность оценить применимость, риски, соответствие рынку и этапу компании. Люди с богатым практическим опытом, многократными ошибками и интуицией по продукту/рынку гораздо ценнее наборов автоматически сгенерированных идей. Лучшие работники в AIродных командах — «переводчики»: они берут сырые, неструктурированные сигналы (разговор с клиентом, отзыв, неудачная сделка), формируют из них структурированную проблему, проектируют рабочий фрейм и решают, какие шаги отдать AI, а где нужен человекрешение. Это требует и отраслевого опыта, и умения формализовать, и навыка контроля качества. Последствия для работников и бизнеса Роли меняются: рутинные операции автоматизируются, повышается спрос на тех, кто умеет думать на уровень выше процессов. Кадровая политика: при найме важнее автономность, способность к обучению, «taste» и разнообразный практический опыт, чем простая скорость владения инструментами. Образование и развитие: компании обязаны обучать сотрудников навыкам структурирования задач, оркестрации агентов и верификации результатов — иначе выиграют лишь те, кто уже имеет профильный опыт. Короткие практические выводы Для сотрудников: развивайте суждение, системное мышление, проактивность и глубокое доменное знание — это то, что AI не заменит в ближайшее время. Для компаний: нанимайте и цените не только «операторов» AI, но и людейпереводчиков, владельцев процессов и тех, кто делает решения воспроизводимыми и проверяемыми. Для HR: пересмотрите критерии отбора — ставьте в приоритет автономность, taste и способность превращать хаос в выполнимые рабочие потоки.

16Апр

Google DeepMind опубликовал 57страничный доклад «From AGI to ASI», где группа во главе с Шейном Леггом и Маркусом Хаттером прокладывает маршрут от искусственного общего интеллекта (AGI) к искусственному суперинтеллекту (ASI). Главная идея отчёта проста и одновременно тревожна: AGI — не конец пути, а отправная точка; масштабирование экземпляров и вычислительных мощностей способно породить ASI даже без радикальной смены алгоритмической парадигмы. Полный отчёт доступен на arXiv. Краткая суть AGI определяется как система, достигающая человеческого медианного уровня по широкому набору когнитивных задач. ASI — это уровень, при котором система стабильно превосходит «десятки тысяч топэкспертов», согласованно работающих над одной задачей в течение десяти лет. DeepMind утверждает: запуск и масштабирование большого числа AGIэкземпляров (например, от 1 000 до 1 000 000 000 при экспоненциальном росте вычислительных мощностей) и/или ускорение их «скорости мышления» может привести к коллективному эффекту, эквивалентному ASI. Первый раздел доклада называется «Summary Instructions» — документ явно рассчитан не только на людей, но и на AIассистентов, которым предлагается автоматически суммировать отчёт и проверять выводы. Это отражает особую эпоху: авторы ожидают, что ИИ будет непосредственным потребителем научных текстов. Четыре «золотых» пути к ASI Масштабирование (compute, model, data): продолжать экспоненциально наращивать вычисления и тиражировать экземпляры AGI. По мысленному эксперименту — тысяча экземпляров при ежегодном росте в 10× становится миллионом за три года и сотней миллионов за пять, что по коллективной мощности эквивалентно ASI. Парадигмальный скачок: новая архитектура или обучение, отличная от предобучение+микронастройка Transformerпарадигмы. Мультиагентные системы и коллективная эмерджентность: сотни миллионов совместно работающих AGI, синхронно обменивающихся знаниями, могут породить сверхорганизованный «цифровой коллективный разум». Рекурсивное самосовершенствование (RSI): AI, самостоятельно улучшающий архитектуру, код и даже аппаратное обеспечение, что может ускорить экспоненциальный рост возможностей. DeepMind выделяет шесть потенциально критических барьеров, «если они станут абсолютными»: Стена данных — исчерпание высококачественных человеческих текстов и других ценных тренинговых ресурсов. Ресурсная стена — энергетические, вычислительные и чиповые ограничения; рост затрат, который экономика проектов не покроет. Увеличение сложности исследований — «низко висящие плоды» уже собраны; для новых прорывов потребуется всё больше усилий. Парадигмальная стена — нынешняя предобучение→микронастройка может оказаться потолком. Социальнополитическая «тормозная» стена — регулирование, общественное противодействие, отключение мощностей по соображениям безопасности. Абстрактная (философская) стена — критическая мысль отчёта: может ли ИИ, обученный только на человеческих текстах, открыть фундаментальные новые концепты (напр., создать теорию на уровне Ньютона) без человеческой настройки? Если нет, это ограничит автономность мыслительного прогресса отдельного экземпляра; но не исключает прорыв через массовость и коллективность. Доклад подчёркивает не только «числовой» эффект. Однородный пул AGIэкземпляров обладает несколькими уникальными преимуществами: мгновенная бесшовная репликация знаний и состояний; высокая скорость коммуникации и обмена «пониманием» через высокоразмерные представления; способность распараллеливать научные и инженерные задачи на невиданном ранее уровне; возможность ускорять «мыслительный» темп (времясжатие), делая год человеческой работы задачей продолжительностью дни или часы для AGI. Именно эти эффекты доклад называет основой перехода от AGI к ASI без «чудаалгоритма». Технологии развиваются так, что сценарии быстрого развития collectiveAI становятся правдоподобны: даже при отсутствии кардинального алгоритмического рывка социальные и экономические эффекты масштабирования могут породить ASIподобные свойства. В то же время риски массового развертывания огромного числа AGI (без надлежащего контроля, audit, redteaming и регуляторных механизмов) крайне высоки. Политики и исследователи должны учитывать не только «единичный» AGI, но и его коллективные эффекты: лицензирование, пределы по вычислениям, обязательные независимые проверки и стратегии по сдерживанию «рекурсивного самосовершенствования». DeepMind не заявляет, что ASI уже здесь; но они показывают правдоподобную дорожную карту, где ASI — не мистический скачок, а следствие масштабирования, ускорения и координации множества AGIэкземпляров. Одновременно отчёт честно перечисляет барьеры, которые могут всё остановить. Это — предупреждение и руководство: будущее зависит не только от алгоритмов, но и от ресурсов, институций и человеческих решений, которые направят или ограничат этот процесс.

16Апр

Anthropic разослала пользователям уведомления об обновлении политики конфиденциальности — и в письмах прозвучало самое тревожное: уже с 8 июля компания может потребовать от части пользователей верификации личности (загрузить документ с фото и сделать «живую» селфисъёмку). По сообщениям в соцсетях рассылка идёт поэтапно, что выглядит как серый запуск новой процедуры. Что именно меняется Agentфункции и сторонние сервисы. Claude получает всё больше «агентских» возможностей: он может выполнять многошаговые задачи и подключаться к сторонним приложениям (Google Drive, Slack, Notion и др.). В обновлённой политике Anthropic прямо указывает, что при таких связках данные могут передаваться между Anthropic и третьими сторонами. Верификация личности. Для защиты безопасности и ответственности сервис может запрашивать проверку возраста и личности через третью сторону — сервис Persona. Процесс включает загрузку удостоверения (паспорт/водительские права/ID) и съёмку живого фото для сопоставления. Anthropic утверждает, что данные не пойдут в обучение моделей и обрабатываются Persona, а не хранятся на их серверах. Исследовательские данные. Для участников опросов и интервью компания может собирать дополнительные сведения. Ограничение: изменения в первую очередь касаются потребительских планов (Free, Pro, Max); корпоративные (Team, Enterprise) пока не охвачены. Источник обновления политики: Anthropic — Updates to our privacy policy. Появление realworldагента, который может бронировать билеты, редактировать документы или проводить финансовые операции от имени пользователя, создаёт серьезные юридические и операционные риски. После случаев вроде блокировки «Fable 5» компании стремятся ввести механизмы ответственности и трассировки — чтобы иметь возможность понять, кто именно инициировал ту или иную автоматизированную операцию. Что это значит для пользователей Приватность и удобство. Для многих пользователей требование загрузить ID и пройти «брюшной» (facematching) тест — серьёзный удар по приватности и удобству использования. Даже если сторонний сервис будет обрабатывать данные, доверие к процедуре остаётся спорным. Новые барьеры для агентов. Агентные функции перестанут быть «свободной» возможностью: за сложные автоматизации, видимо, придётся подтверждать личность, что увеличит трение при использовании. Разграничение пользователей. Потребительские аккаунты вероятнее всего первыми столкнутся с верификацией; корпоративные клиенты пока не затронуты, но политика может расширяться по мере усложнения сценариев. Это шаг в сторону более строгой регуляции и контроля со стороны платформ: эра «диких» агентов, вероятно, заканчивается, по крайней мере в части, где от имени пользователя можно совершать финансовые и юридические действия. Для разработчиков и провайдеров AIинструментов это означает рост требований к ответственному дизайну, аудиту действий агентов и механизмам ответа на инциденты. Anthropic явно готовится к новой фазе ответственности: с появлением агентфункций платформы стремятся иметь возможность идентифицировать реальных инициаторов действий. Это повышает безопасность и ответственность, но одновременно ставит сложные вопросы приватности, прозрачности обработки биометрии и практической реализуемости таких процедур для миллионов пользователей. Очевидно одно: ближайшие месяцы дадут понять, как индустрия будет балансировать между «удобством агентов» и «правами пользователей».

16Апр

Современные агентные системы на базе больших моделей строятся не из единого «всёводном» ИИ, а из наборов практических приёмов и архитектурных шаблонов. Что стоит знать каждому, кто проектирует продакшнагентов — от промптов до наблюдаемости и взаимодействия человеквпетле. 1. Промпт — фундамент Промпт — точка входа. В продакшне промпт — это не свободный ввод, а структурированный шаблон, часто содержащий роль, инструкции, формат вывода, контекст и ограничители. Есть три стратегии: zeroshot (простые, когда задача очевидна), fewshot (несколько примеров для контроля формата) и цепочка мыслей (chainofthought) для задач, где важна пошаговая логика. 2. Декомпозиция задач и субагенты Надёжная система раскладывает задачу на узкие субзадачи и назначает каждому специализированный субагент. Это позволяет применять лёгкие, дешевые модели для тривиальных шагов и сильные — только там, где действительно нужны. Такой подход повышает предсказуемость и упрощает отладку. 3. Параметры моделей и температура Ключевой параметр — температура: низкая → детерминизм и стабильность (подходит для извлечения данных), высокая → разнообразие и креатив (генерация идей). Правило простое: если нужна согласованность — понижайте температуру; если нужна креативность — повышайте. 4. Архитектуры рабочих потоков Два основных паттерна: Цепочки (chain): линейная обработка, легко отлаживать (LangChain). Оркестровка/графы (orchestrator/graph): централизованный координатор выбирает, какие агенты и в каком порядке вызывать, может ветвиться и циклировать (LangGraph). Chain для предсказуемых задач, orchestrator — для адаптивных/исследовательских. 5. Режимы рассуждения: ReAct vs PlanandExecute ReAct (реактивный цикл): чередование рассуждений, вызов инструментов и наблюдений, хорошо подходит для задач с неопределённостью. PlanandExecute: сначала строится полный план, затем выполняется; эффективен при стабильных, параллелизуемых процессах. 6. Инжекция контекста (context engineering) Контекст нужно подбирать, а не «вкладывать всё». Для структурированных данных — SQLзапросы; для неструктурированных — RAG: секционирование документов в векторы и извлечение релевантных фрагментов. Цель — точность, а не объём. 7. Инженерия способностей (skills) Поведение агентов формализуют в «скиллах» — небольших Markdownправилах, задающих тон, ограничения и шаги. Это облегчает обновление поведения без переписывания промптов целиком. 8. RAG vs дообучение RAG меняет, какие данные доступны модели — быстрый и недорогой способ улучшить фактическую точность. Дообучение (finetuning) меняет поведение модели на уровне весов — дорого, перманентно. Сначала пробуют RAG; если проблема в «мышлении» модели, рассматривают дообучение. 9. Интеграция инструментов и MCP Агенты часто вызывают внешние API/инструменты. MCP (Model Context Protocol) — стандарт для публикации «плагинов» инструментов, позволяющий агенту автоматически обнаруживать доступные сервисы, как в магазине плагинов. 10. Надёжность: судьяагент и LLMшлюз Judge (оценщик) — отдельная модель, проверяющая выход и принимающая pass/fail или расширенное объяснение; может работать синхронно или фоном. LLMgateway — балансировщик и failover между провайдерами (лимиты, простои), чтобы система оставалась доступной. 11. Память и контрольные точки Для длинных диалогов применяют суммаризацию (регулярные «снимки» памяти) и чекпоинты для продолжения рабочих потоков при падениях — снижается нагрузка на контекст и повышается устойчивость. 12. Наблюдаемость (observability) Трассировка каждого запуска (входы, промпты, ответы, тайминги, токены) — обязательна. Это «чёрный ящик» системы: он нужен для отладки и метрик улучшения (инструменты вроде Langfuse). 13. HITL — человек в петле Критические решения должны иметь точки человеческого контроля: как UXориентированные интерфейсы для редактирования, так и механизмы эскалации из подозрительных выводов judgeагента. 14. Структурированные выходы Определяйте строгие схемы (JSONшаблоны) и проверяйте их на ранних этапах: это предотвращает ломку конвейера, когда следующий агент ожидает конкретный формат. 15. Компоновка всех слоёв Итоговая система сочетает промптдизайн, субагентов, контекст и способностьинженерию, RAG/дообучение, инструментальные интеграции, judgeагенты, память, наблюдаемость и HITL. Понимание этих слоёв даёт надёжную карту для оценки новых инструментов и построения масштабируемых, безопасных агентных систем. Короткий вывод: чтобы перевести эксперименты с чатами в промышленные агенты, нужно не волшебная модель, а архитектура: декомпозиция задач, управление контекстом, формализация поведения, гарантии качества и инфраструктура надёжности.

16Апр

Обвал или торжество — 12 июня 2026 года дебют SpaceX на Nasdaq сопровождался внезапной и мощной волной оптимизма: в моменты торгов капитализация компании поднялась к $2 трлн, а Маск стал первым в мире «триллионным» миллиардером. Но что именно покупает рынок за эту цену и насколько оправдана такая оценка? Короткий разбор ключевых аргументов «за» и «против». Аналитически покупка акций SpaceX — это ставка не на текущую выручку, а на три ещё не полностью реализованные истории: Starlink — «денежный двигатель». Уже приносящая прибыль и масштабируемая сеть: более 1200 млн пользователей в 164 странах, высокая маржинальность (EBITDA ~63%). Занятые частоты и орбитальные слоты создают ощутимый барьер входа. Для многих инвесторов это — наиболее «реализованный» и надежный актив в экосистеме. AIинфраструктура и Colossus. За считанные месяцы SpaceX/xAI собрали Colossus из сотен тысяч GPU и подписали крупные контракты (Anthropic, Google), которые дают огромный денежный поток. Вертикальная интеграция (энергия от Tesla, собственная инфраструктура) даёт потенциальное преимущество по себестоимости вычислений. Орбитальные датацентры — «космический» опцион. Идея переместить части облачной инфраструктуры в орбиту обещает преимущества по питанию и площадям, но требует драматического снижения стоимости выведения грузов и подтверждения инженерных решений. Это самая рисковая, но и самая трансформационная ставка. Структура группы Маска выглядит как взаимосвязанная система: энергия (Tesla Energy → хранилища и питание для датацентров), данные (автопарк Tesla → Colossus → улучшение продуктов), и денежный поток (платы за запуски и подписки Starlink → инвестиции в Starship и орбитальные проекты). Такие перекрёстные связи усиливают синергию, но и концентрируют риск. При цене IPO соотношение цена/продажи ~95× (на 2025 г. выручка ≈ $18.7 млрд) формально выглядит детским фантомом. Аналитики расходятся: Morningstar даёт ~ $780 млрд, Damodaran — $1.3 трлн, другие сценарии доходят до ещё больших сумм. Разница объясняется тем, что часть ценника — это не дисконтированная прибыль, а нынешняя стоимость опционов на радикальные изменения в инфраструктуре вычислений и космической логистике. Риски — технологические, рыночные и «человеческие» Технологические: отказ схемы Starship, проблемы с охлаждением/питанием орбитальных датацентров, невыполнение планов по снижению себестоимости вывода килограмма на орбиту. Рыночные: конкуренты, регуляторика, изменения спроса. Персональные: Маск — одновременно движущая сила и «одиночная точка отказа». Его способность принимать рискованные решения — преимущество, но и источник волатильности (политические публичные высказывания, управленческие решения). Цена в $1.7–2 трлн — это не просто ставка на текущие бизнесы SpaceX; это коллективный рыноквердикт о трёх больших опционах и о том, что один человек — Илон Маск — сможет довести их до результата. Для одних это оправданный премиум за потенциально цивилизационные изменения; для других — завышенная вера в технологии и в нереплицируемую личность. Ответ на вопрос «стоит ли это своих денег?» зависит от терпимости к риску: покупая SpaceX сегодня, вы покупаете не только активы и выручку, но и веру в масштабную, высокорисковую трансформацию индустрий.

Если у вас есть инновационная идея, мы будем рады реализовать ее для Вас!

Специалисты нашей кампании и наши разработки для вас!