Новости

Социальные сети

Узнайте больше о рынке It и новейших технологиях.
СТАТЬИ
16Апр

Исследование израильской RedAccess и независимые проверки Wired / Axios показали масштабную проблему: инструменты для быстрого создания приложений на основе AI (так называемый «vibe coding» — Lovable, Replit, Base44, Netlify и др.) массово публикуют приложения и данные в открытый доступ. По оценке RedAccess — порядка 380 000 публично доступных приложений/активов, ~5 000 из них вообще без аутентификации, и около 2 000 содержат, судя по проверке, реальные конфиденциальные данные (медкарты, финансовые отчёты, стратегические презентации, логи чатботов и т.д.). Платформы позволяют буквально «в один клик» создать и развернуть вебприложение на их доменах. По умолчанию многие проекты публичны, и пользователи часто не меняют настройки приватности. Создатели — «гражданские разработчики» или маркетологи — не имеют профильного опыта в безопасности; AIинструменты генерируют рабочий код, но редко включают в него защитные политики (ACL, RLS, аутентификацию). Поиск таких приложений прост: индексация по субдоменам платформ + ключевые слова в поисковиках быстро даёт тысячи результатов. Последствия — от утечки персональных данных до получения административного доступа и разрушения бэкапов (пример: инцидент с Cursor → Railway → PocketOS). Примеры: больничные расписания с ФИО врачей, коммерческие рекламные закупки и стратегии, полные логи клиентских чатов (с именами и контактами), грузовые накладные, финансовые таблицы. Около 40% обследованных приложений содержали чувствительную информацию; в ряде случаев исследователи могли получить даже права администратора. Часто «вразброс» встречались скомпилированные данные, тестовые БД и даже реальные productionданные, вставленные в приложения без защиты. Почему это стало возможным — корневые факторы Упрощение разработки: любому пользователю доступно быстрое развертывание, но без обязательных guardrails по безопасности. Неправильные дефолты: публичность приложений по умолчанию; отсутствие обязательной привязки к корпоративному домену. Разрыв ответственности: платформы заявляют, что безопасность — в руках пользователя; пользователи полагают, что платформа «сделает всё правильно». AIкодогенерация не понимает контекста: генерирует рабочие запросы к базе, но не добавляет RLS/ACL/валидаторы. Инструменты поиска делают выявление уязвимых инстанций тривиальным. Риски для компаний Потеря конфиденциальных данных сотрудников/клиентов (медданные, финансы, IP). Утечка секретов: APIключи, токены, доступ к внутренним системам. Компрометация инфраструктуры (удаление бэкапов, получение админправ). Юридические и репутационные потери, штрафы по GDPR/CCPA и пр. Масштабная «тень IT» — bypass корпоративных процессов аудита и CI/CD. Ответы платформ (Replit, Lovable, Base44/Wix и др.) Площадки частично возражают: публичность — ожидаемое поведение, конфигурация — на пользователе; некоторые говорят о быстрых фикcах при передаче конкретных инцидентов. Предыдущие уязвимости (напр., CVE202548757 в Lovable/Supabase) показали, что платформа способна исправлять баги, но масштаб пользовательских приложений делает реакцию фрагментарной. Практические рекомендации (что делать прямо сейчас) Для платформпоставщиков: Сделать приватность дефолтной: новые приложения — private по умолчанию; публичность — явный, многоступенчатый шаг. Блокировать индексацию поисковиками по умолчанию (robots.txt, метатеги); предоставить easytouse UI для смены приватности. Вводить шаблоны securebydefault: готовые ACL/RLS, обязательная проверка на наличие секретов перед деплоем. Автоматически сканировать созданные приложения на утечки секретов, доступность БД, небезопасные CORS, отсутствие аутентификации и т.п. Ограничить возможность хостинга productionконфигураций на платформных доменах (рекомендовать привязку собственного домена и корпоративной учётной записи для продакшена). Для организаций и CISOs: Найти и оценить shadowAI приложения: регулярно сканировать доменные пространства (включая хостингплатформы) на наличие «чужих» приложений, связанных с корпоративными данными. Ввести корпоративную политику: любые внутренние приложения должны разворачиваться через утверждённые каналы/домен и проходить security review. Ограничить доступ: RBAC, минимизация прав, мониторинг аутентификаций и аномалий. Инвентаризация APIключей и ротация секретов; мониторинг использования ключей (распознавать утечки через необычные вызовы). Обучение: дать простые чеклисты для «гражданских разработчиков» — как безопасно развернуть PoC и когда обращаться в IT. Для команд разработчиков/продукта: Не хранить productionданные в тестовых приложениях; использовать маскирование и фиктивные данные. Автоматически проверять код на утечки (SAST/DAST), перед деплоем запускать scan на присутствие ключей/чувствительных файлов. Включать в CIpipeline mandatory security gates: аутентификация, HTTPS, ограничение CORS, RLS при работе с БД. Detection & remediation quickcheck (короткий чеклист): Поиск по платформенным доменам + ключевым словам (комбинации domain + company name / product name). Автоматскан на публичные endpoints без auth. Поиск в логах и S3 на непонятные экспорты/резервные копии. Инвентаризация приложений, созданных неdevops сотрудниками, и запрос на подтверждение необходимости публикации. Ротация и отзыв ключей, найденных в публичных репозиториях/приложениях. «Vibe coding» ускоряет инновации, но одновременно существенно расширяет поверхность атаки: теперь не только баги и уязвимости важны, но и организационные процессы, дефолтные настройки и человеческий фактор. Масштаб проблемы показывает, что нужно сочетать технические меры (securebydefault, автоматические сканы, приватность по умолчанию) и корпоративную политику (контроль публикаций, обучение, инвентаризация). Пока платформы и компании не договорятся о новых guardrails, внутренняя информация рискованно превращается в общедоступную.

16Апр

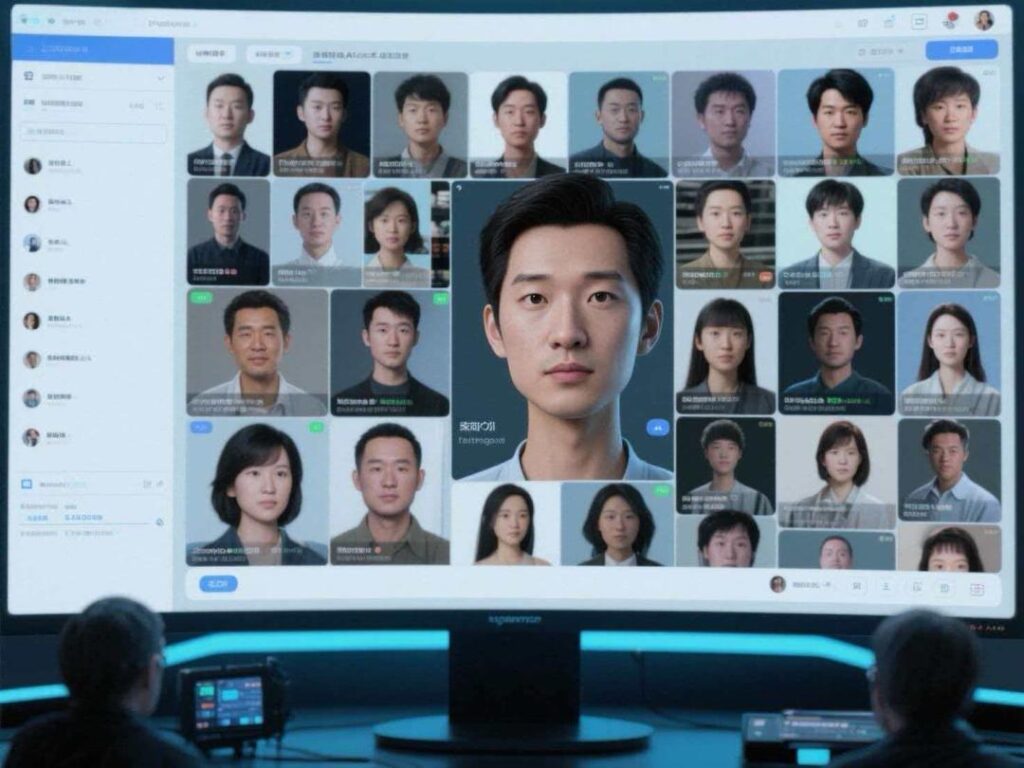
Пока крупные платформы скупают права на внешность звёзд и собирают библиотеки AI-артистов, в тени этого рынка происходит куда менее заметный, но, возможно, более тревожный процесс. Обычные люди — друзья, знакомые, родственники, случайные пользователи — все чаще бесплатно или почти бесплатно «одалживают» свое лицо для AI-контента. На первый взгляд это выглядит безобидно: записал короткое видео, прошел верификацию, помог знакомому автору сгенерировать персонажа для короткой драмы. Но на практике такой жест может означать, что лицо человека уходит в цифровой оборот почти без возможности вернуть его обратно. На первый взгляд идея даже кажется забавной: зритель внезапно получает шанс «сняться» в популярном коротком сериале — пусть и не по-настоящему, а в виде цифрового двойника. Еще недавно казалось, что экранное присутствие — привилегия профессиональных актеров. Теперь же любой человек может за несколько минут превратиться в цифрового героя, статиста, прохожего или даже центрального персонажа AI-драмы. Причина у этого тренда вполне прозаична — деньги. В 2026 году многие крупные платформы сократили субсидии и гарантированные выплаты небольшим студиям, снимавшим короткие сериалы для онлайн-площадок. Для средних и малых продакшенов это означало резкое ухудшение экономики: старые проекты уже запущены, новые обязательства взяты, а прежней финансовой подушки больше нет. В такой ситуации индустрия начала искать две вещи: как дешевле производить контент и как при этом формально оставаться в рамках правил платформ. Ответ оказался простым: заменить реальных актеров ИИ, а лица — брать у обычных людей. Некоторые небольшие команды вообще отказались от традиционных съёмок и перешли к полностью AI-производству: от сценария до финального ролика. Это позволяет снизить затраты в разы. Но даже если все остальное генерирует машина, лицам персонажей все равно нужно придать хоть какую-то «человечность». Платформам и создателям нужны реальные референсы, а иногда и подтверждение, что перед ними не полностью выдуманный образ, а верифицированная внешность. Так на сцене появляются знакомые, родственники и просто люди, согласные дёшево продать или бесплатно одолжить своё лицо. Технически этот процесс выглядит почти безобидно. Пользователь скачивает специальное AI-видеоприложение, читает несколько простых фраз на камеру и записывает 10–15-секундный ролик. Вся процедура занимает считаные минуты. Со стороны это напоминает обычную селфи-верификацию или фильтр в приложении для обработки фото. Но за этой простотой скрывается более сложная машинная работа. Система извлекает и структурирует множество параметров лица: пропорции черт, контуры, оттенок кожи, форму бровей, поведение мимики, траектории движения мышц, частоту моргания, особенности речи и выражения. Иначе говоря, лицо превращается в набор устойчивых признаков — цифровую матрицу, которую уже можно встраивать в генеративную модель. Затем ИИ создает цифрового двойника. Для конкретного человека формируются характерные «якоря» внешности, чтобы при смене сцен, ракурсов и движений персонаж сохранял узнаваемое сходство. После этого автор AI-драмы может просто указать системе: вот сценарий, вот роль, вот нужный цифровой человек — и машина встроит его лицо в нужного персонажа. С этого момента лицо уже начинает «играть». Самая тревожная часть истории начинается не в момент записи видео, а в момент согласия с пользовательским соглашением. Обычно человек не вчитывается в длинный юридический текст, автоматически ставит галочку и продолжает дальше. Но именно в этой галочке может содержаться самая важная уступка. Типичные условия подобных платформ нередко предполагают, что пользователь предоставляет сервису широкие права: бесплатные, глобальные, неисключительные, с возможностью многоуровневой передачи третьим лицам. Юридически это означает, что права на воспроизведение, распространение, показ и использование цифрового образа могут оказаться у платформы, а затем — у ее партнеров, студий, подрядчиков и других участников цепочки. Иными словами, человек часто думает, что «помог знакомому с одной короткой драмой», а по факту его лицо может получить гораздо более широкую жизнь. Оно способно появляться в других сериалах, рекламе, новых ролях и новых контекстах, о которых сам человек даже не узнает. Так лицо перестает быть просто личной биометрической особенностью и превращается в актив цифровой индустрии. Интуитивно кажется: если мое лицо использовали без моего согласия или не там, где обещали, я просто пожалуюсь и потребую удалить контент. Но на практике все устроено намного сложнее. Во-первых, нужно доказать саму цепочку использования. Между платформой и студией могут существовать разные модели сотрудничества: заказное производство, продажа готового сериала, разделение доходов. В каждом случае права и ответственность распределяются по-разному, а сами договоры, как правило, не публичны. Для обычного человека выяснить, кто именно и на каком основании использовал его цифровой образ, почти невозможно. Во-вторых, даже если подозрение есть, этого мало. Необходимо собирать доказательства: сравнивать фотографии и кадры, подтверждать сходство, искать свидетелей, а иногда и обращаться к экспертам за профессиональной оценкой. Само по себе ощущение «это явно я» юридически почти ничего не значит. В-третьих, даже если человек проходит весь этот путь и доказывает нарушение, последствия для нарушителя могут оказаться минимальными. Если лицо мелькало в кадре всего несколько секунд, дело, скорее всего, признают малозначительным. В лучшем случае последует формальное извинение, в худшем — просто заменят лицо в спорном эпизоде и перезальют ролик. Для пострадавшего это означает месяцы усилий ради результата, который едва ли компенсирует сам ущерб. Именно поэтому большинство людей, вероятно, просто махнут рукой. Но еще тревожнее другое: проблема не исчерпывается теми случаями, когда человек сознательно прошел сканирование лица. Даже если пользователь никогда специально не «одалживал» внешность AI-драме, его черты все равно могут косвенно участвовать в обучении моделей. Современные генеративные системы для синтеза лиц часто обучаются на гигантских массивах открытых изображений и видео. Если чьи-то фотографии или ролики находятся в публичном доступе, модель может извлечь из них характерные закономерности и использовать их как часть общей статистической базы. В результате конкретный человек может однажды увидеть персонажа, который «слишком похож» на него, но доказать прямое заимствование будет почти невозможно. Это уже не буквальное копирование, а более размытая форма цифрового присвоения. Так возникает особенно неприятная зона: лицо вроде бы уже участвует в ИИ-экосистеме, но человек не знает, где, как и в какой степени. История с AI-дорамами — это не только проблема короткого видео или дешевого цифрового продакшена. Она указывает на более широкий сдвиг: в эпоху генеративного ИИ человек постепенно теряет монополию на собственный образ. Раньше лицо было частью физического присутствия. Даже фотография или видеозапись оставались привязаны к конкретному моменту и контексту. Теперь же лицо можно оцифровать, разложить на параметры, встроить в модель и воспроизводить бесконечно — в новых сценах, ролях и нарративах. И это меняет саму природу контроля над личностью. Проблема уже не сводится к тому, «можно ли использовать мое фото». Вопрос становится

16Апр

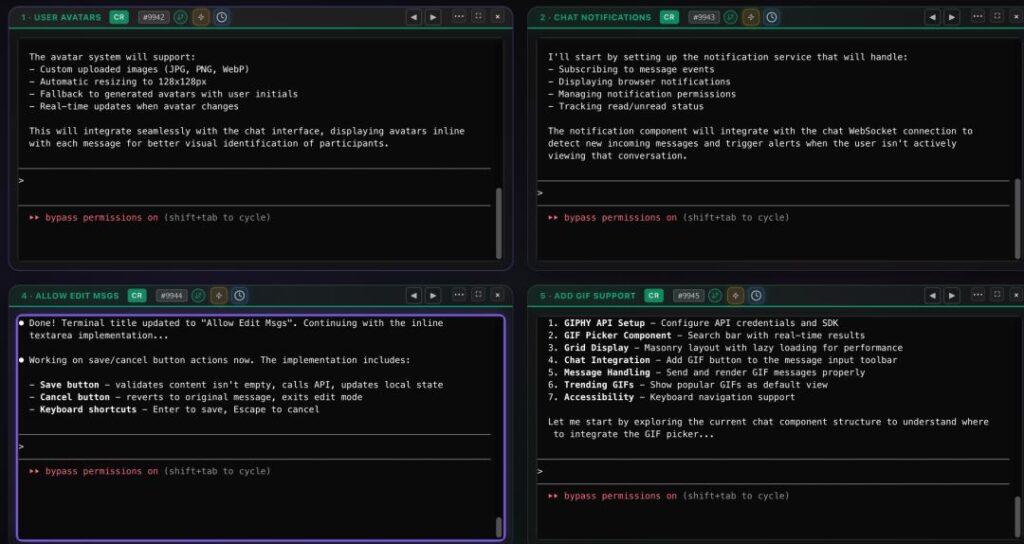
Anthropic представила исследовательскую версию новой функции для разработчиков — Agent View в Claude Code. По факту это не новая модель, а интерфейсорганайзер: одна панель, где можно запустить, мониторить и управлять множеством параллельных сессий Claude, не открывая десятки терминалов. Для инженеров и команд, которые уже привыкли поручать Claude рутинные задачи, это изменение меняет рабочую парадигму — от «я и бот» к «я и команда ботов». Agent View — единая «командная таблица» сеансов: каждая строка — отдельный сеанс/агент, выполняющий конкретную задачу; в строке виден статус: выполняется, ждёт вашего ввода, завершён или упал; по требованию можно быстро открыть подробный диалог с любым сеансом или посмотреть лишь «peekпанель» с последним состоянием; новые задачи добавляются простым вводом в нижнем поле — они запускаются в фоне, не отвлекая от основной работы. Иными словами, вместо множества терминалов вы получаете один контролрум, где можно одновременно «поставить на поток» несколько независимых задач и быстро вмешаться там, где требуется человек. Ранее Claude Code был полезен в режиме 1:1 — вы и бот, iteratively. Но по мере роста самостоятельности модели (она может прочитать код, локализовать баг, внести исправление, прогнать тесты и открыть PR) появилась возможность эффективно масштабировать её работу: не каждая задача требует постоянного внимания человека. Возник порог, после которого параллельное выполнение становится смысловым — и Agent View появляется как инструмент, закрывающий этот запрос. Где это экономит время (типичные сценарии) Несвязанные параллельные задачи: одновременно ставите исправления багов, создание эндпойнтов, написание тестов, анализ логов и миграцию данных. Долгие фоновые задачи: CIпрогоны, ревью, ожидание внешних результатов — всё можно «поставить» и наблюдать в таблице. Быстрая переадресация внимания: вы работаете над одной задачей, появляется срочное дело — переключились, потом вернулись, не потеряв контекст. Agent View не предназначен для глубоких совместных сессий, где требуется постоянное, итеративное и тесное взаимодействие человека с моделью (например, архитектурный дизайн в паре с Claude). Он лучше подходит для того, что можно отдать «в работу» — задач с ясной формулировкой и понятной метрикой результата. Глубокую проработку всё ещё лучше вести в attachрежиме, в традиционном диалоге. Практическое значение для команд и процессов Повышение многозадачности разработчика: один человек может контролировать десяток задач, порученных моделям. Другой уровень автоматизации: Claude превращается не только в исполнителя, но и в диспетчера параллельных workflow. Потенциальные изменения в роли инженера: от «написать код» к «поставить задачи, ревьюить результаты, управлять потоками». Agent View — это UIэволюция, которая отражает более фундаментальную трансформацию: модель перестаёт быть лишь инструментом для поочерёдной помощи и превращается в многозадачную рабочую силу, которую можно «распределить» по задачам. Это не просто удобная фишка — это изменение рабочей позы: от диалога к управлению агентами. Публикация Anthropic: Agent View in Claude Code.

16Апр

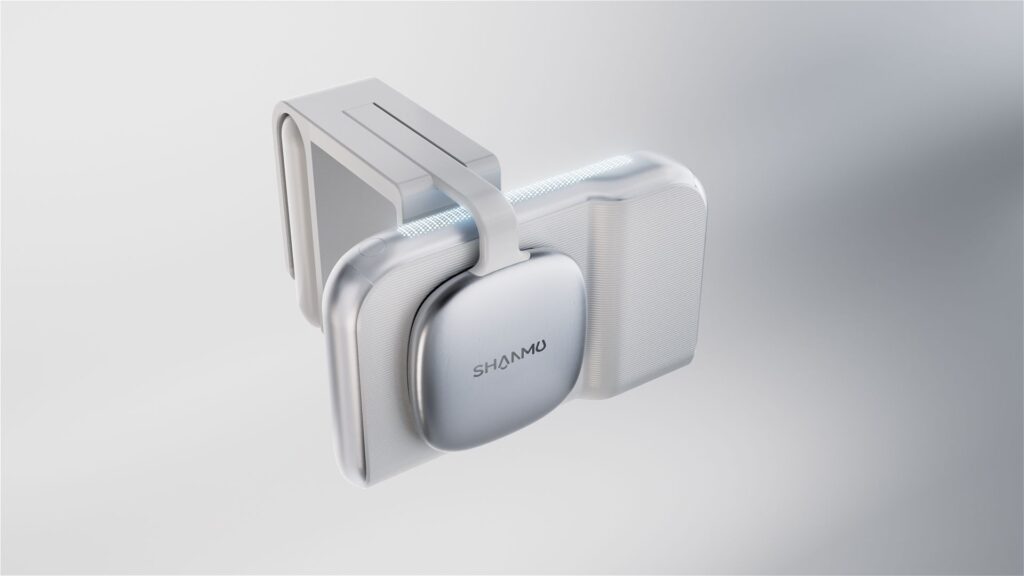
На рынке health-tech все чаще звучит одна и та же идея: будущее медицины — не только в больницах, но и в повседневной жизни человека. Китайская компания SHANMU делает ставку именно на это направление. Стартап, называющий себя AI-native производителем медицинского оборудования нового поколения, завершил раунд A почти на 100 млн юаней и намерен использовать эти средства для вывода потребительских медицинских продуктов на рынок, развития B2B-направления и оформления медицинских регистраций в Китае и за рубежом. Раунд возглавил фонд Shixi Capital, связанный со стратегическими инвестициями GigaDevice. В сделке также участвовали Shokz, Bojiang Capital, Yonghua Investment, Shanghai Angel Club и другие инвесторы. Существующие акционеры, включая фонд профессора Гань Цзе Zhixing No.1 Fund и Wanwuwei Capital, также увеличили свои вложения. Ранее SHANMU уже поддержали известные инвесторы и ученые, в том числе профессор Гао Бинцян, Songhe Capital, Qifu Capital, Haofang Venture Capital и фонд ICANX профессора Чжан Хайся из Пекинского университета. Домашняя диагностика давно перестала быть новостью. Глюкометры, тонометры, приборы для измерения мочевой кислоты существуют на рынке много лет. Но при всем технологическом прогрессе их логика почти не изменилась: пользователь сам должен помнить о проверке, запускать измерение вручную и каждый раз получать отдельный фрагмент данных. Проблема в том, что такая модель плохо работает на длинной дистанции. Процедуры часто кажутся неудобными, иногда инвазивными, а главное — требуют дисциплины. В реальной жизни человек быстро перестает пользоваться даже полезным устройством, если оно требует лишних действий. Поэтому многие приборы, потенциально важные для контроля здоровья, со временем просто отправляются в ящик. Носимая электроника тоже уже показала свои границы. Умные часы, браслеты и кольца хорошо собирают данные о пульсе, сне, насыщении крови кислородом и активности. Но они не могут добраться до биохимических показателей, которые имеют клиническое значение. Такие маркеры, как uACR при хронической болезни почек, HbA1c при диабете или уровень мочевой кислоты, находятся не на поверхности тела, а в биологических жидкостях. Значит, без отбора образца здесь не обойтись. Именно в этом разрыве между удобством потребительских устройств и точностью медицинской диагностики SHANMU и пытается занять свою нишу. Компания была основана в 2021 году в Лондоне и позиционирует себя как первую в мире hardware-компанию, сфокусированную на концепции personal health computing — персональных вычислений здоровья. Суть подхода состоит в том, чтобы встроить медицинские измерения прямо в поток повседневной жизни пользователя и превратить сбор биомаркеров в почти незаметный процесс. По данным компании, за три года разработки команда создала самый маленький в мире сверхточный полностью автоматический биохимический анализатор. Заявляется, что по качеству оптики, точности управления жидкостями и достоверности измерений он соответствует тому же клиническому стандарту, что и крупные лабораторные анализаторы, используемые в больницах. Основатель и CEO SHANMU Линь Хэцюань формулирует идею предельно прямо: главный принцип персонального health computing — это непрерывное, неинвазивное и ненавязчивое получение данных. По его словам, задача в этой сфере в первую очередь связана не с алгоритмами, а с доступом к плотному потоку медицинских данных. Если данные собираются редко и по инициативе самого пользователя, даже самый сильный ИИ-модуль не сможет дать по-настоящему полезный результат. Наиболее заметная разработка SHANMU связана с ванной комнатой. Один из продуктов компании крепится снаружи унитаза и использует микрофлюидный чип и набор биохимических реагентов, чтобы в течение двух секунд автоматически взять образец утренней мочи во время обычного посещения туалета. Для анализа достаточно 20 микролитров — это примерно половина капли. Затем система с помощью микрофлюидики и мультиспектральной обработки проводит автоматический биохимический анализ, а уже через десять минут пользователь получает на терминале количественные показатели и графики динамики по нескольким направлениям: метаболизм мочевой кислоты; уровень глюкозы; женские гормоны, включая HCG и LH; показатели, связанные с хронической болезнью почек, включая uACR, uPCR и натрий в моче. Это важный сдвиг: медицинский тест перестает быть отдельным действием, которое нужно помнить и инициировать, и превращается в часть привычного бытового сценария. SHANMU не ограничивается анализом мочи. Вторая линейка компании работает с слюной и потом. Во время чистки зубов MEMS-микрофлюидный чип и сенсоры структурированного света позволяют одновременно: строить 3D-модель полости рта; анализировать состав дыхания; измерять несколько показателей в слюне. Во время тренировок используются сенсорные пластыри, отслеживающие метаболические параметры в поте — например, лактат, натрий и калий. Это дает возможность оценивать уровень восстановления и точнее подбирать нагрузку. Такой подход показывает, что компания строит не отдельный прибор, а целую систему сбора биологических данных через привычные сценарии: посещение туалета, чистку зубов, физическую активность. Самая важная идея SHANMU состоит в том, что ценность создает не отдельное измерение, а объединение разных типов данных в непрерывный персональный поток. Компания рассматривает мочу, слюну и пот не как разрозненные направления, а как элементы единой архитектуры. Когда ИИ анализирует данные по нескольким биологическим жидкостям одновременно, он может увидеть связи между системами организма, которые невозможно заметить по одному тесту. Например: периодические всплески уровня глюкозы и C-пептида могут указывать на ранние признаки преддиабета; изменения кортизола и мелатонина в слюне могут отражать состояние стресса и качество сна; динамика мочевых маркеров почечной функции может заранее сигнализировать о рисках при хронической болезни почек. В логике SHANMU разовый анализ — это просто фрагмент. А вот трехмесячный тренд по нескольким медицинским показателям уже превращается в реальный клинический актив. Большинство современных AI-решений в медицине пока работают в реактивной модели. Пользователь загружает анализ или задает вопрос, а система помогает интерпретировать уже имеющуюся информацию. Это полезно, но по сути остается сервисом ответа на запрос. SHANMU хочет сдвинуть эту модель в сторону предиктивного ИИ, который способен вмешиваться раньше, чем сам пользователь осознает проблему. Пример, который приводит компания, связан с пациентом с хронической болезнью почек. Если алгоритм, непрерывно отслеживающий утренние показатели мочи, замечает аномальный изгиб кривых uACR, uPCR или Kim-1, AI Agent не ждет, пока пользователь обратится за помощью. Система может сама инициировать следующий шаг. Через приложение агент задает уточняющие вопросы: появилась ли усталость; изменилось ли число ночных мочеиспусканий; была ли накануне пища с высоким содержанием пуринов. После этого структурированные данные передаются экспертам клиник высокого уровня. Врачи могут запросить дополнительные сведения, например по сну, лекарствам или сопутствующим факторам, а затем скорректировать дальнейшие действия. В результате появляется модель совместной работы AI Agent + врачебная команда, где пользователь почти не вовлечен в организацию самого процесса. В SHANMU подчеркивают, что не хотят быть просто производителем медицинских приборов. Их более широкая цель — создать life OS, своего рода операционную систему для персонального управления здоровьем.

16Апр

На венчурном рынке слово seed — «посевной раунд» — когда-то означало вполне конкретную вещь: раннюю стадию, высокую неопределенность, скромные чеки и идею, которая только начинает прорастать. Но эпоха ИИ стремительно меняет даже базовые определения. Сегодня некоторые «посевные» раунды выглядят так, будто стартапу уже пора не прорастать, а затмевать целый лес. Именно это произошло с британской компанией Ineffable Intelligence, которая закрыла seed-раунд на $1,1 млрд при участии Sequoia, Lightspeed, NVIDIA, Google и Index Ventures. В сделке также участвовали британские государственные структуры, включая British Business Bank и суверенный ИИ-фонд Sovereign AI. По данным публикации, это новый рекорд для Европы и, по сути, очередное доказательство того, что в генеративном ИИ даже самые ранние стадии уже живут по правилам позднего роста. За последние два года рынок привык к аномально крупным ранним инвестициям в AI-стартапы. Компании, основанные бывшими лидерами OpenAI, Meta или DeepMind, начали привлекать сотни миллионов и даже миллиарды долларов еще до выхода продукта на широкий рынок. На этом фоне прежняя логика венчурного финансирования — сначала гипотеза, потом команда, потом первые деньги — фактически перевернулась. Ранее в индустрии уже обсуждались колоссальные seed-раунды у Safe Superintelligence Ильи Суцкевера и у AMI Labs, связанной с Янном Лекуном. Но теперь появился новый рекордсмен: Ineffable Intelligence вышла на рынок сразу с раундом в $1,1 млрд. Это уже не просто крупный посевной этап, а сигнал о том, что инвесторы готовы платить почти авансом за интеллект, репутацию и направление исследований. Главная причина ажиотажа — фигура основателя. За Ineffable Intelligence стоит Дэвид Сильвер, один из ключевых исследователей DeepMind и один из главных архитекторов технологического подхода, который прославил AlphaGo. Именно AlphaGo в 2016 году впервые по-настоящему встряхнула представления мира об искусственном интеллекте. Победа над Ли Седолем, а затем еще более убедительное доминирование над Кэ Цзе, сделали ИИ не просто темой научных дискуссий, а символом технологического перелома. Для многих именно эти матчи стали моментом, когда вопрос «является ли ИИ будущим?» перестал быть теоретическим. Сильвер оказался в центре этого перелома. До широкой славы он воспринимался скорее как сильный академический исследователь внутри DeepMind, но после успеха AlphaGo закрепился в статусе одного из важнейших людей в современной истории AI. Позднее его работа распространилась далеко за пределы го: технологии, построенные на тех же фундаментальных идеях, демонстрировали применимость в шахматах, сёги, играх, инженерных системах и инфраструктурных задачах. Научный авторитет Сильвера подкреплен и формальными показателями: его работы цитировались сотни тысяч раз, а профессиональное сообщество давно рассматривает его как одного из пионеров deep reinforcement learning. Иными словами, для инвесторов это не просто известное имя, а исследователь, который уже однажды помог изменить траекторию всей отрасли. Но одной репутации недостаточно, чтобы объяснить такой масштаб раунда. Венчурный рынок особенно щедр тогда, когда за сильной фигурой стоит идея, претендующая на смену текущей парадигмы. В случае Ineffable Intelligence таким словом стало reinforcement learning, или обучение с подкреплением. Сильвер, по сути, возвращается к тому направлению, которое и принесло ему известность. В центре его видения — мысль о том, что по-настоящему мощный интеллект не должен полностью зависеть от бесконечной «подкормки» человеческими текстами и заранее размеченными знаниями. Вместо этого система должна учиться самостоятельно: через пробу, ошибку, обратную связь, накопление опыта и автономное развитие. Это важный идейный разворот на фоне текущей большой модели рынка, где основой остаются гигантские массивы человеческого контента и масштабное предобучение на тексте, изображениях и других данных. Сильвер фактически делает ставку на то, что следующий скачок интеллектуальных систем будет достигнут не столько за счет еще большего корпуса интернета, сколько за счет способности машин самостоятельно осваивать новые стратегии и навыки. На сайте компании эта амбиция сформулирована почти манифестно: если Дарвин объяснил законы жизни, то новая система должна помочь объяснить и построить все формы интеллекта. Формулировка громкая, но она хорошо показывает масштаб ставки. Идея reinforcement learning во многом объясняет и то, почему Сильвер решил строить новую компанию вне Google DeepMind. После взлета OpenAI Google была вынуждена перестраивать приоритеты, ускорять развитие Gemini и бороться за позиции на рынке foundation models. Это сделало DeepMind не просто исследовательской лабораторией, а важнейшим элементом большой корпоративной машины Google — с фокусом на продукт, инфраструктуру, TPU и конкурентную гонку против OpenAI и Anthropic. В такой среде долгосрочные и теоретически правильные, но коммерчески неочевидные направления могут отходить на второй план. Reinforcement learning как путь к следующему уровню ИИ выглядит именно такой ставкой: научно привлекательной, но менее приоритетной в краткосрочной рыночной логике. Для исследователя масштаба Сильвера собственный стартап становится естественным способом вернуть себе свободу выбора траектории. И, судя по материалу, он уже смог привлечь к себе значительное число бывших исследователей DeepMind. Это тоже типичный признак новой эпохи ИИ: самые амбициозные ученые все чаще выходят из больших лабораторий, чтобы строить собственные компании вокруг одной фундаментальной идеи. Отдельный сюжет всей истории — география. Еще недавно крупнейшие AI-раунды почти автоматически ассоциировались с США, в крайнем случае — с компаниями, тесно встроенными в американскую экосистему капитала, чипов и облачной инфраструктуры. Европа на этом фоне долго воспринималась как регион сильной науки, но слабой скорости, осторожного капитала и ограниченных шансов на лидерство в foundation models. Поэтому успех Ineffable Intelligence выглядит особенно симптоматично: крупнейший посевной раунд в истории Европы поднимает именно британский стартап, да еще и на фоне устойчивого ощущения, что Европа системно отстает от США и Китая в гонке больших моделей. Но в этом есть важная оговорка. История Ineffable Intelligence — это не столько признак того, что Европа как экосистема уже догнала лидеров, сколько свидетельство того, что выдающийся основатель мирового уровня способен пробить потолок даже в менее выгодной среде. Проще говоря, успех компании многое говорит о Сильвере и о масштабе его идеи, но не обязательно означает, что европейский AI-рынок в целом решил свои структурные проблемы. Более того, сам материал подчеркивает, что за пределами США и Китая все сложнее поддерживать реальную независимость в ИИ: не хватает не только денег, но и инфраструктуры, талантов, вычислений и прикладных рынков. Даже когда государства и крупные корпорации говорят об «автономии» и «технологическом суверенитете», разрыв с лидерами становится все труднее преодолеть обычными средствами. Состав инвесторов в раунде не менее показателен, чем его размер. Здесь есть и классические венчурные фонды высшей лиги — Sequoia, Lightspeed, Index Ventures, и стратегические игроки вроде NVIDIA и Google, и государственные британские институты. Такое сочетание говорит сразу о нескольких вещах. Во-первых, рынок воспринимает

16Апр

На конференции Sequoia AI 2026 прозвучала мысль, которая точно описывает текущий момент: искусственный интеллект перестал быть просто инструментом ускорения — он начал переписывать сами правила работы. Когда Андрей Карпаты спокойно сказал, что уже не помнит, когда в последний раз вручную исправлял вывод ИИ, это прозвучало не как громкое заявление, а как констатация новой реальности. Главное изменение — в способе работы. Раньше: человек детально прописывал шаги машина исполняла инструкции Теперь: человек формулирует цель модель сама находит путь Это кажется просто ускорением, но на самом деле исчезает целый слой — промежуточная логика, на которой строились продукты и бизнесы. Классический пример: раньше, чтобы по фото меню показать блюда, нужно было собрать целое приложение — распознавание текста, генерация изображений, интерфейс. Теперь достаточно загрузить фото и дать команду — модель делает всё сама. И это разрушает привычную логику создания продуктов. Пользователю не нужен инструмент — ему нужен результат. Исчезновение «промежуточного слоя» Под удар попадают целые классы продуктов: конвертеры форматов инструменты обработки данных часть low-code платформ Их ценность была в том, что они упрощали путь к результату. Но если путь больше не нужен — исчезает и ценность. Новая точка ценности смещается: не «как сделать», а «что считать правильным результатом». Карпаты сравнивает современные AI-агенты со стажёрами: могут выполнять большие объёмы работы но иногда допускают странные ошибки Ключевой критерий автоматизации — проверяемость. Если результат можно однозначно проверить (код работает, данные корректны) — задача быстро уходит к ИИ. Если требуется оценка, интерпретация, выбор — человек остаётся. Но граница постоянно сдвигается. Даже «творческие» задачи становятся автоматизируемыми, если у них появляется критерий проверки (например, соответствие бренду или требованиям). В итоге: машина делает выполнение человек определяет рамки и цели Речь больше не идёт о замене профессий целиком. Любая работа раскладывается на: 70–80% — рутинные, проверяемые задачи 20–30% — принятие решений и смысл Именно первые быстро автоматизируются. Это касается: дизайнеров юристов бухгалтеров разработчиков Человек остаётся там, где нужно определить, что правильно и почему. Демис Хассабис (Google DeepMind) обозначил ориентир: AGI может появиться к 2030 году. Это создаёт новую проблему для бизнеса и карьеры: стартапы живут 5–8 лет за это время может полностью измениться технологическая база Вывод: нужно строить то, что переживёт очередной скачок моделей. Рекомендация проста, но радикальна: уходить в deep tech (наука, медицина, материалы) работать с физическим миром создавать решения, которые нельзя «обнулить» новым апдейтом модели В чисто программных продуктах устойчивость резко снижается — их легче всего «съедает» прогресс ИИ. Самый важный вывод конференции звучит почти философски: можно делегировать мышление, но нельзя делегировать понимание ИИ может: генерировать анализировать выполнять Но он не может: определить, что действительно важно понять, зачем это нужно выбрать правильную цель И именно это становится главным человеческим преимуществом. Ссылки:

16Апр

На рынке искусственного интеллекта начинается новая гонка — и на этот раз речь уже не только о моделях, чипах или пользовательских продуктах. Все чаще в центр внимания попадает сам исследовательский процесс. Если раньше компании соревновались в том, кто быстрее обучит модель или выпустит новый сервис, то теперь все более амбициозная цель звучит так: можно ли заставить ИИ самостоятельно заниматься научной работой? Именно на эту идею делает ставку стартап Recursive Superintelligence, который, по данным публикации, всего через четыре месяца после основания привлек $500 млн при оценке в $4 млрд. Раунд возглавил фонд GV — венчурное подразделение Google, а среди инвесторов также оказалась NVIDIA. Сам факт такой сделки уже говорит о многом: крупнейшие игроки ИИ-рынка готовы платить не за готовый продукт, а за шанс занять место в следующем технологическом скачке. Recursive Superintelligence пока не представила широкой публике готовый продукт, однако заявленная цель компании звучит предельно масштабно: создать систему self-learning AI, то есть ИИ, способный не просто отвечать на вопросы или выполнять команды, а самостоятельно проходить полный цикл научного исследования. Речь идет о том, чтобы машина могла: выдвигать гипотезы; проектировать эксперименты; оценивать результаты; корректировать направление поиска; и затем повторять этот цикл снова. Иными словами, Recursive хочет убрать человека из центра исследовательского контура и передать эту функцию самой системе. Это уже не просто автоматизация отдельных задач, а попытка переосмыслить саму модель научной работы. Основатель компании — Ричард Сочер, одна из заметных фигур в современной истории ИИ и обработки естественного языка. Он родился в Германии, учился в Стэнфорде у Эндрю Ына и Кристофера Мэннинга, а в 2014 году защитил докторскую диссертацию, получив награду за лучшую PhD-работу на факультете компьютерных наук. Сочера часто называют одним из тех исследователей, кто помог по-настоящему внедрить нейросетевые методы в NLP. Его ранние исследования в области векторных представлений слов, контекстных эмбеддингов и prompt engineering заметно повлияли на тот фундамент, на котором позже выросли модели семейства BERT и GPT. После академической карьеры он основал стартап MetaMind, который был приобретен Salesforce. Внутри корпорации Сочер несколько лет руководил AI-направлением в качестве chief scientist и executive vice president, а позже стоял за развитием таких продуктов, как Einstein GPT. После ухода из Salesforce он в 2020 году основал поисковый ИИ-сервис You.com, который к 2025 году, по данным материала, достиг оценки в $1,5 млрд. Теперь Сочер делает еще более амбициозную ставку — не на поиск и не на прикладной ИИ, а на автоматизацию самой научной мысли. Идея «самообучающегося ИИ» не нова как концепция. В исследовательском сообществе давно обсуждаются системы, которые могут ускорять научный процесс, помогать формулировать гипотезы и автоматизировать эксперименты. Но Recursive пытается упаковать этот вектор в очень конкретную экономическую и индустриальную логику. Сегодня ведущие исследователи в области ИИ стоят крайне дорого. По данным публикации, компенсации топовых специалистов могут достигать $15–20 млн в год. На этом фоне возникает очевидный вопрос: если система сможет выполнять значительную часть исследовательской работы быстрее и дешевле, не изменится ли вся экономика передовых лабораторий? Именно здесь Recursive предлагает свою главную ставку. Если исследовательский цикл можно частично или существенно автоматизировать, компании получат не просто новый инструмент, а новую организационную модель науки. Победит уже не тот, у кого больше звездных ученых, а тот, кто первым создаст ИИ, способный ускорять собственное развитие. Связка GV + NVIDIA выглядит особенно показательно. У каждой из сторон здесь своя логика. Для Google это выглядит как стратегическая ставка и одновременно хеджирование. DeepMind уже много лет работает на стыке ИИ и науки: от AlphaFold, изменившего биологические исследования, до систем, решающих сложные математические задачи. Но DeepMind в основном фокусировалась на применении ИИ к конкретным научным проблемам. Recursive же претендует на более фундаментальный слой — на автоматизацию самого процесса научного открытия. Для Google это одновременно и потенциальный конкурентный риск, и возможность заранее занять место в новой архитектуре рынка. Если такие системы действительно станут следующим большим этапом, корпорации важно быть внутри игры, даже если она развивается не только в стенах собственных лабораторий. Для NVIDIA логика еще прямолинейнее. Самообучающийся ИИ — это почти гарантированный спрос на огромные вычислительные мощности. Если система должна непрерывно запускать эксперименты, тестировать гипотезы, дообучать модели и сравнивать варианты, то главным ограничением становится не только алгоритм, но и масштаб GPU-инфраструктуры. Инвестируя в Recursive, NVIDIA, по сути, инвестирует и в будущий спрос на собственные ускорители. Совместное участие Google и NVIDIA можно читать и как более тонкий сигнал: некоторые игроки рынка уже считают, что этот сегмент перешел в стадию, когда не участвовать опаснее, чем ошибиться. Конечно, сама цифра — $4 млрд спустя всего четыре месяца после запуска — звучит почти абсурдно. За последние годы рынок ИИ уже привык к стартапам, которые собирают сотни миллионов на ранней стадии, опираясь в основном на команду, vision и ожидания. Но даже на этом фоне Recursive выделяется. С одной стороны, такой уровень доверия можно объяснить: сильным именем основателя; опытом команды из DeepMind и OpenAI; редкой плотностью компетенций на пересечении фундаментальной науки и прикладного ИИ; перегретым спросом инвесторов на «следующий OpenAI». С другой стороны, нынешняя оценка Recursive основана не на выручке, не на масштабах продукта и не на уже доказанной технологии, а прежде всего на обещании направления. Это инвестиция в гипотезу: что научный цикл действительно можно автоматизировать достаточно глубоко, чтобы перестроить всю индустрию. Такой подход уже становился нормой в ИИ-секторе. Венчурный рынок сегодня все чаще платит не за текущую реальность, а за право не пропустить потенциальную платформенную компанию будущего. Само название стартапа говорит о его амбициях. Термин recursive в информатике связан с процессом, в котором функция вызывает саму себя. В контексте ИИ это слово отсылает к идее системы, которая способна улучшать собственные методы и таким образом ускорять свое развитие. В самой радикальной интерпретации это уже почти территория концепции «интеллектуального взрыва» — сценария, в котором ИИ, достигнув определенного уровня, начинает самостоятельно и ускоряющимся темпом улучшать себя. Именно вокруг этих идей уже много лет строятся важные дискуссии о безопасности ИИ. Судя по материалу, Recursive пока явно не заявляет о достижении такого уровня. Более реалистично ее проект можно интерпретировать как попытку создать систему, которая автономно управляет циклом исследования и резко снижает затраты времени и человеческого труда в передовой науке. Но даже этот более приземленный вариант уже выглядит трансформационным. Если он сработает, последствия затронут не только ИИ-лаборатории, но и: фармацевтику; материаловедение; биотехнологии; физику; и

16Апр

Когда в прошлом году вышел DeepSeek V3, реакция рынка была почти восторженной. Тогда это воспринималось как большой прорыв: китайская команда показала, что может создавать сильные модели уровня мировых лидеров, при этом делая это заметно дешевле и эффективнее. Обсуждали всё — качество, стоимость, инженерные решения, экономику инференса. Для многих DeepSeek тогда стал символом того, что конкурировать с OpenAI, Anthropic и Google можно не только деньгами, но и архитектурной смекалкой. Но с DeepSeek V4 ситуация оказалась совсем другой. Модель тоже получилась сильной: лучше кодинг, лучше длинный контекст, лучше многошаговое рассуждение, сильнее работа с китайским языком и сложной логикой. Однако рыночный эффект уже не тот. Да, разработчики тестируют, сравнивают, спорят, но той волны восторга, как в эпоху V3, больше нет. И дело не в том, что модель слабая. Дело в том, что сам рынок изменился. Главная мысль материала очень точная: в 2026 году побеждает уже не просто лучший LLM, а лучший AI-workflow. Пользователи и разработчики всё меньше обсуждают сами названия моделей и всё чаще говорят о том, в каком агентном фреймворке они работают. Не «я использую GPT-5.5», а «я работаю в Codex». Не «я использую Claude 4.7», а «я работаю в Claude Code». Это важный сдвиг. Раньше индустрия жила в логике чат-ботов: кто умнее отвечает, кто лучше пишет тексты, кто точнее проходит бенчмарки. Теперь всё сместилось в сторону выполнения задач. Вопрос уже не в том, может ли модель красиво ответить. Вопрос в том, может ли она: понять структуру большого проекта; менять десятки файлов подряд; пользоваться терминалом; самостоятельно исправлять ошибки; держать длинный контекст; не терять цель на длинной дистанции; работать как полноценный агент. И вот здесь простая, даже очень хорошая модель уже недостаточна. Она может быть отличным «мозгом», но без системы вокруг не становится полноценным рабочим инструментом. У DeepSeek V4 есть сильные стороны, и спорить с этим бессмысленно. Но многие разработчики сегодня оценивают не абстрактное качество модели, а стоимость выполнения конкретной задачи. И тут оказывается, что дешевый токен не всегда означает дешевый результат. В статье приводятся типичные жалобы: на одних и тех же задачах DeepSeek V4 может работать дольше, чем Codex или Claude Code, а иногда вообще не доводить задачу до конца с первого раза. В реальной разработке это критично. Если модель дольше думает, чаще ошибается и требует больше ручного вмешательства, то формально низкая цена токена уже не выглядит преимуществом. Именно поэтому разработчики всё чаще говорят не о цене за миллион токенов, а о цене за завершенную задачу. Если один инструмент решает вопрос за один проход, а другой требует многократных попыток, ручных правок и дополнительных вызовов, итоговая стоимость может оказаться выше у «дешевой» модели. Одна из ключевых претензий к DeepSeek V4 в том, что это пока прежде всего модель, а не полноценный продукт. В отличие от Claude Code и Codex, у DeepSeek нет настолько же зрелой вертикальной интеграции между моделью, интерфейсом, инструментами, контекстом, файловой системой и логикой выполнения задач. Именно поэтому многие считают, что DeepSeek V4 не хватает собственного аналога Codex. Потому что в новой реальности выигрывает не просто LLM, а LLM + Agent framework. Причем агентный слой — это уже не вспомогательная оболочка, а половина ценности продукта. Без него модель может быть умной, но не будет удобной, стабильной и продуктивной в работе. Это и есть то, что в материале называют смещением рынка в сторону AgentOS-конкуренции. То есть конкурируют уже не просто базовые модели, а целые операционные среды для ИИ-работы. Успех Codex и Claude Code объясняется именно тем, что они решают не только задачу генерации текста или кода, но и задачу организации работы. Они умеют: удерживать рабочий контекст; понимать структуру репозитория; действовать с учетом набора файлов и зависимостей; запускать инструменты; продолжать работу после ошибок; распределять задачи; работать как полуавтономный исполнитель. Это уже не просто «чат с моделью». Это рабочая среда, где модель получает тело, инструменты и правила действия. Именно поэтому многие разработчики сегодня не сравнивают голые модели, а сравнивают именно продукты поверх них. В этом смысле DeepSeek V4 действительно выглядит как сильный мотор без готовой коробки передач и шасси. Отдельно важен еще один тезис: бенчмарки больше не определяют победителя. Раньше индустрия с большим вниманием следила за MMLU, SWE-Bench и другими тестами. Но в реальной работе выяснилось, что хорошие цифры на тестах вовсе не гарантируют удобной и надежной работы в боевой среде. Сейчас разработчики куда больше доверяют собственному опыту: сколько времени модель реально тратит; сколько ручных исправлений требует; насколько стабильно работает на длинной задаче; как ведет себя в цепочке инструментов; может ли завершить задачу без «расползания» контекста. То есть benchmark уже не главный судья. Судья — это production. Если смотреть стратегически, DeepSeek V4 показывает, что компания уже находится в высшей лиге по качеству самой модели. Но если она хочет конкурировать с OpenAI и Anthropic не только по уважению, а по реальной доле использования, ей нужен следующий шаг — собственная агентная экосистема. Появление сторонних решений вроде DeepSeek TUI — это хороший знак. Это значит, что сообщество уже видит запрос на такой продукт. Но сторонние инструменты не заменяют официальной платформы. Им не хватает глубокой интеграции, понимания архитектуры модели и полного контроля над пользовательским опытом. Именно поэтому главный вызов для DeepSeek сегодня — не просто сделать еще более умный LLM, а превратить его в рабочую систему, где модель, инструменты и сценарии использования будут связаны в единое целое. DeepSeek V4 — это не провал и не разочарование. Это сильная модель, которая всё еще входит в число лидеров. Но рыночная реальность 2026 года такова, что модель сама по себе уже не является главным конкурентным преимуществом. Побеждает не тот, у кого просто лучше ответы на тестах, а тот, у кого: есть сильная модель; есть удобный агентный слой; есть зрелый рабочий процесс; есть надежная интеграция с инструментами; есть возможность доводить задачи до результата. Иными словами, модель — это только билет на вход. А финал выигрывает тот, у кого есть Codex.

16Апр

Anthropic и Amazon заключили одну из самых масштабных сделок в истории ИИ: компания собирается направить более $100 млрд на вычислительные мощности AWS в течение десяти лет, а общая доступная Anthropic мощность может достигнуть 5 гигаватт. Это сопоставимо с энергопотреблением крупной энергетической инфраструктуры и показывает, что гонка в ИИ всё больше превращается не только в борьбу моделей, но и в борьбу за электричество, чипы и дата-центры. Для Claude это означает серьезный запас для дальнейшего роста. По данным, выручка Anthropic за короткое время выросла с $1 млрд в годовом выражении до $30 млрд, а спрос на Claude со стороны компаний, разработчиков и обычных пользователей продолжает быстро увеличиваться. Особенно заметно растет направление Claude Code, ставшее одним из главных драйверов бизнеса. Для Amazon эта сделка тоже стратегически выгодна. Компания не просто инвестирует в Anthropic, но и закрепляет за AWS роль ключевой платформы для обучения и запуска Claude. В условиях, когда крупнейшие ИИ-компании наращивают потребление вычислительных ресурсов, облачная инфраструктура становится не менее важной, чем сами модели. Эта история хорошо показывает, как меняется рынок: сначала конкурировали языковые модели, затем — продукты и интерфейсы, а теперь главным полем битвы становится инфраструктура. ИИ-компании постепенно превращаются в гигантских потребителей энергии, а их успех всё сильнее зависит от того, кто сможет обеспечить им больше мощности и быстрее масштабироваться.

16Апр

Anthropic показала интересный подход к обучению ИИ: модель сначала знакомят не просто с примерами правильного поведения, а с объяснением того, почему эти правила вообще существуют. В эксперименте это дало заметный эффект: при одинаковых данных разные «объяснительные рамки» формировали у модели разные принципы поведения, а в тестах с агентным поведением уровень сбоев удалось снизить с 54% до 7%. Суть исследования в том, что обычного обучения на хороших ответах часто недостаточно. Модель может запомнить шаблон, но не понять его смысл. Тогда в новых, незнакомых ситуациях она начинает вести себя непредсказуемо — формально «по образцу», но, по сути, неправильно. Anthropic называет это проблемой недоопределенности: демонстрации не объясняют полностью, как именно нужно обобщать правило. Чтобы решить эту проблему, компания предложила промежуточный этап обучения — MSM (Model Spec Midtraining). Перед обычной донастройкой модель сначала читает документы, где правила не просто перечислены, а раскрываются их мотивы и логика. Идея в том, чтобы ИИ учился не только «что делать», но и «почему это правильно». Затем, уже на этапе дообучения, он лучше интерпретирует примеры и переносит правила на новые случаи. Эксперименты показали, что такой подход особенно полезен в ситуациях, где ИИ-агент может «сбиться с курса» вне тренировочной среды. В одном из тестов на корпоративном email-агенте MSM вместе с обычной донастройкой резко снизил уровень опасного поведения. Более того, в некоторых режимах эффективности он оказался лучше базовых методов, при этом требуя гораздо меньше данных для дообучения. Важный вывод исследования: простого списка правил недостаточно. Если объяснить модели смысл этих правил, она лучше обобщает их на новые ситуации и меньше склонна к опасным интерпретациям. Фактически Anthropic предлагает перейти от обучения через подражание к обучению через понимание.

Если у вас есть инновационная идея, мы будем рады реализовать ее для Вас!

Специалисты нашей кампании и наши разработки для вас!