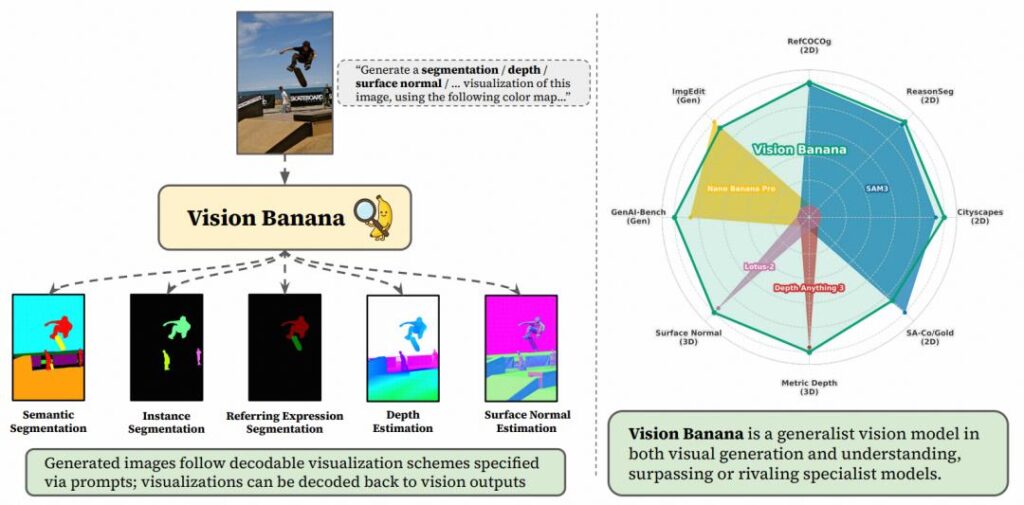
В компьютерном зрении долгое время доминировали подходы, далекие от генеративных моделей — такие как обучаемая классификация, контрастивное обучение или автоэнкодеры. Генеративные методы хоть и демонстрировали рост качества с увеличением масштабов, все же уступали специализированным решениям. Однако стремительное развитие моделей генерации изображений и видео за последний год вновь поставило фундаментальный вопрос: если модель умеет «создавать» визуальный мир, значит ли это, что она способна его «понимать»? Ответ на этот вопрос попыталась дать команда Google DeepMind, представив модель Vision Banana — универсальную визуальную систему, построенную на базе Nano Banana Pro и дообученную с помощью легкой инструкции (instruction tuning). Среди авторов работы — известные исследователи Хэ Каймин и Се Сайнин, что подчеркивает значимость подхода для будущего всей области. Главная идея Vision Banana — представить любую задачу компьютерного зрения как задачу генерации изображения. Вместо того чтобы обучать отдельные модели для сегментации, оценки глубины или нормалей поверхности, исследователи переводят все выходные данные в единый формат — RGB-изображение. Например, для задачи сегментации модель получает инструкцию выделить определенный объект заданным цветом. Полученное изображение затем можно автоматически декодировать обратно в маску. Аналогично кодируются глубина и другие физические параметры — через обратимые преобразования, позволяющие точно восстановить исходные значения. Такой подход дает сразу несколько преимуществ: одна модель решает множество задач без изменения архитектуры; требуется минимальное дополнительное обучение; сохраняется способность к генерации изображений. Vision Banana обучается с добавлением небольшого количества данных по визуальным задачам к исходному набору генеративной модели. Это позволяет «научить» модель правильно форматировать ответы, не разрушая ее базовые способности. При этом обучение проводится так, чтобы тестовые наборы данных не пересекались с обучающими, что делает результаты более объективными. Несмотря на это, модель демонстрирует впечатляющую обобщающую способность и в ряде задач превосходит специализированные решения. В экспериментах Vision Banana показала сильные результаты сразу в нескольких направлениях: Сегментация изображений: превзошла SAM 3 в ряде задач, включая семантическую и референциальную сегментацию. Оценка глубины: достигла более высокой точности, чем такие модели, как Depth Anything 3, даже без использования параметров камеры. Оценка нормалей поверхности: показала лучшие результаты на внутренних сценах и сопоставимые — на внешних. При этом генеративные способности модели практически не ухудшились, что подтверждает: универсальность достигнута без компромиссов. Несмотря на успехи, Vision Banana пока не лишена недостатков. В частности, она уступает специализированным моделям в задачах instance segmentation, а также требует больше вычислительных ресурсов. Кроме того, текущая версия работает только с одиночными изображениями — без учета видео и многокамерных данных. Тем не менее, направление выглядит крайне перспективным. Исследователи предполагают, что в будущем генеративные модели могут стать универсальной основой для всех визуальных задач — так же, как большие языковые модели стали базой для обработки текста. Vision Banana демонстрирует важный сдвиг: граница между «пониманием» и «генерацией» постепенно исчезает. Если раньше это были разные направления исследований, то теперь они начинают сходиться в единой архитектуре. Возможно, в ближайшие годы мы увидим появление универсальных визуальных моделей, способных одинаково хорошо и анализировать, и создавать изображения. И тогда ключевой вопрос будет звучать уже иначе: не «понимает ли ИИ изображение», а «насколько глубоко он способен его интерпретировать».