Новости

Социальные сети

Узнайте больше о рынке It и новейших технологиях.
СТАТЬИ
16Апр

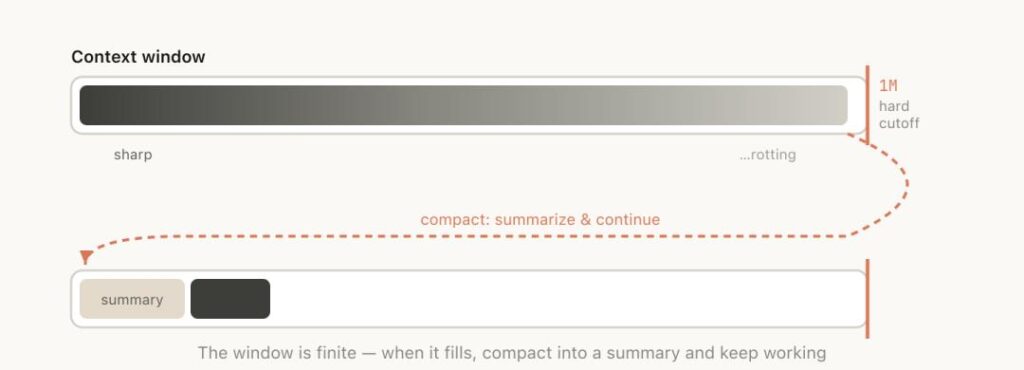
Ещё недавно большой контекст считался главным преимуществом современных ИИ-моделей. Чем больше токенов — тем умнее система, тем больше данных она может «держать в голове». Но теперь сами разработчики признают: это не совсем так. Anthropic открыто заявила о проблеме, которую назвала context rot — «гниение контекста». Суть проста: чем длиннее диалог и чем больше информации загружено в модель, тем хуже она начинает работать. Причина — в ограниченности внимания. Внутри контекстного окна оказываются не только актуальные данные, но и старые сообщения, неудачные попытки, лишние файлы и промежуточные результаты. Всё это конкурирует за «внимание» модели и превращается в шум. В итоге ИИ начинает хуже понимать задачу и чаще ошибается. Особенно парадоксально это выглядит на фоне заявлений о «миллионном контексте». Формально он есть, но это не значит, что все эти токены одинаково полезны. На практике значительная часть превращается в балласт. Чтобы решить проблему, Anthropic предложила набор из пяти стратегий — по сути, новую дисциплину работы с ИИ, которую уже называют «инженерией контекста». Первая и самая простая — продолжать диалог, если контекст ещё актуален. Но это работает только на коротких дистанциях. Вторая — возврат (rewind). Вместо того чтобы исправлять ошибки внутри текущего диалога, лучше откатиться к моменту до ошибки и пойти по другой ветке. Это позволяет убрать «мусор» из контекста и сохранить только полезную информацию. Третья — полная очистка (clear). Начать новый диалог, вручную описав ключевые факты. Это самый «чистый», но и самый трудоёмкий способ. Четвёртая — сжатие (compact). Модель сама суммирует предыдущий диалог и оставляет только краткое содержание. Удобно, но рискованно: можно потерять важные детали, особенно если модель уже «устала» от перегрузки. Пятая — субагенты (subagents). Это, пожалуй, самый интересный подход: отдельные задачи выносятся в изолированные контексты, а в основной диалог возвращается только результат. Таким образом, основной поток остаётся «чистым», без лишнего шума. По сути, Anthropic предлагает относиться к каждому сообщению как к точке принятия решения: продолжать, откатываться, очищать или изолировать задачу. Отдельно компания подчёркивает ещё одну проблему — стоимость. Большие контексты не только ухудшают качество, но и резко увеличивают расходы. Поэтому появился инструмент /usage, который позволяет отслеживать потребление и лимиты. Всё это указывает на важный сдвиг: эпоха «просто пиши хороший промпт» заканчивается. На смену приходит более сложный навык — управление контекстом. Если раньше ключевым было то, что сказать модели, то теперь всё чаще важно, что не показывать ей. В этом смысле большой контекст — это не только преимущество, но и ответственность. Он даёт мощность, но требует дисциплины. И те, кто научится грамотно управлять этим ресурсом, будут получать от ИИ гораздо более стабильные и качественные результаты.

16Апр

Anthropic продолжает идти своим необычным путём: вместо чисто технического подхода к развитию ИИ компания всё активнее привлекает религиозных мыслителей и теологов, пытаясь встроить в модели не просто правила, а полноценные моральные системы. По данным СМИ, Anthropic организовала закрытые встречи в Сан-Франциско с представителями разных традиций — от конфуцианства и даосизма до ислама, индуизма и христианства. Обсуждения выходят далеко за рамки стандартной «AI safety»: как ИИ должен реагировать на сложные моральные запросы пользователей (например, темы самоповреждения); может ли ИИ обладать «моральной ответственностью»; есть ли у моделей нечто вроде «ценности» за пределами инструмента. Anthropic пытается решить проблему глубже, чем просто фильтры и правила — фактически речь идёт о формировании «совести» у ИИ. Центральная фигура — католический священник Брендан Макгуайр.Его биография символична: в 1980–90-х — успешный технарь в Кремниевой долине, дошёл до уровня топ-менеджмента; затем ушёл в монашество и провёл десятилетия в церковной службе; после бума ИИ снова оказался вовлечён в технологическую индустрию — уже как эксперт по этике. Сейчас он сотрудничает с Anthropic и помогает «обучать» модели через тексты и сценарии, формируя у них этическое мышление через итерации и корректировки — почти как reinforcement learning, но с моральным содержанием. Главная причина — разочарование в прежних подходах, особенно в идеологии эффективного альтруизма (EA), который: чрезмерно утилитарный («считать пользу» любой ценой); спорные и радикальные идеи внутри сообщества; связь с громкими скандалами (например, история SBF). На этом фоне Anthropic, ищет более «проверенные временем» системы — а именно религиозные этические традиции с тысячелетней историей. Речь идёт не просто о дискуссиях. Эти идеи уже применяются: при разработке принципов поведения моделей (например, «Claude principles»); в аргументации против военного использования ИИ; в формировании позиций по вопросам слежки и автономного оружия. Например, религиозные эксперты подчёркивают: передача решений машине разрушает человеческую ответственность; автономное оружие противоречит базовым принципам справедливой войны; массовое наблюдение через ИИ подрывает субъектность человека. Anthropic фактически признаёт: технических решений недостаточно, чтобы сделать ИИ «безопасным». Поэтому компания делает ставку на неожиданный источник — религию как «готовую библиотеку этики», проверенную веками. Но за этим стоит более глубокий кризис всей индустрии:старые идеологии не справляются, новые ещё не сформированы, а развитие технологий идёт слишком быстро. И в этой ситуации вопрос звучит уже не как инженерный, а как философский:кто и на основе каких ценностей будет учить ИИ быть «хорошим»?

16Апр

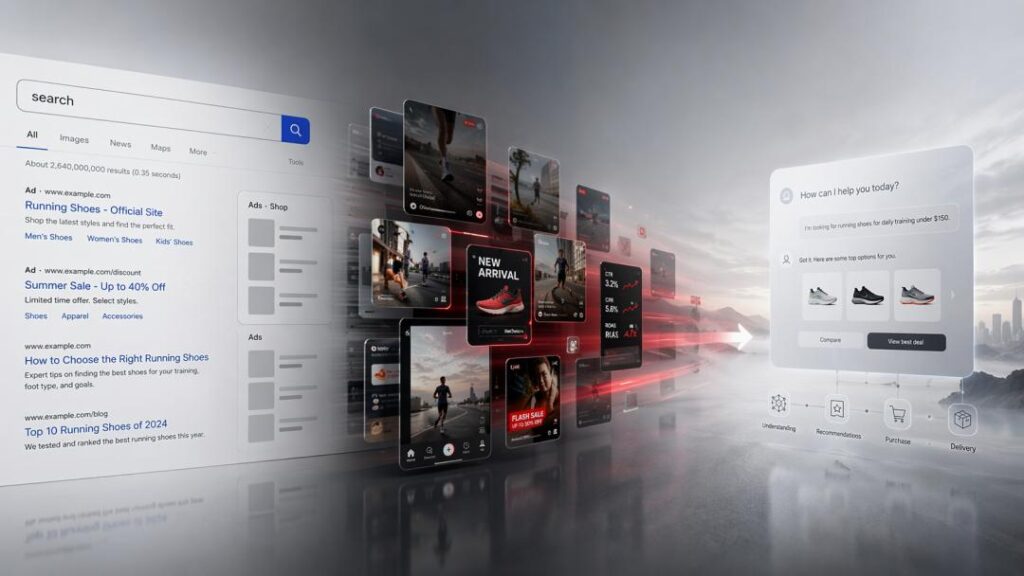
По прогнозу eMarketer, к концу 2026 года Meta (запрещённая в России) может впервые за всю историю цифровой рекламы обойти Google по глобальной чистой выручке от digitalрекламы: $243,46 млрд против $239,54 млрд. На первый взгляд разница не драматична, но куда показательнее динамика: рост Meta — 24,1%, тогда как Google — 11,9%. За этими цифрами проступает смена эпохи: реклама всё меньше «подбирает» уже существующий спрос и всё больше создаёт, усиливает и конвертирует его через алгоритмы. Сила Google в ПКэпоху строилась на поисковой рекламе. Пользователь сам вводит запрос — значит, он уже находится ближе к покупке: ищет «туры в Таиланд» или «лучшие наушники с шумоподавлением» и почти готов тратить деньги. Такой трафик дорог, потому что отражает явно выраженную потребность. Но у поисковой модели есть естественный потолок: она «снимает сливки» со спроса, который уже возник. Если человек не ищет — перехватывать нечего. Сегодня же всё больше покупок начинается не с поисковой строки, а с ленты: увидел → заинтересовался → «созрел» → купил. Точка старта спроса смещается в рекомендательные системы, и именно здесь доминирование Google начинает слабеть. Дополнительное давление создают новые конкуренты и форматы: рост товарного поиска у маркетплейсов, изменение поведения молодёжи (поиск через соцплатформы), а также развитие AIпоиска, где ответы всё чаще выдаются сразу в интерфейсе — без переходов по ссылкам. В результате, по оценкам eMarketer, доля Google на рынке поисковой рекламы в США может опуститься ниже 50% уже в 2026 году. Meta играет в другую игру: вместо ожидания сформированного спроса она строит непрерывное производство внимания — и превращает его в покупки. У её роста выделяют две опоры. Первая — мощная продуктовая связка: Instagram (запрещённая в России) и Reels увеличивают просмотр (в тексте приводится рост времени просмотра в IV квартале 2025 года более чем на 30%), Threads расширяет инвентарь, WhatsApp развивает платные сообщения и инструменты для бизнеса. Это даёт новые поверхности для рекламы и коммерции. Вторая — AIавтоматизация рекламы. Система Advantage+ превращает размещение в «управление целями»: алгоритмы сами подбирают аудитории, тестируют креативы, оптимизируют конверсии. Для многих рекламодателей это означает меньше ручной настройки и понятнее эффект: в материале приводятся оценки роста ROI и снижения стоимости лида. По сути Meta продаёт не просто показы, а операционную систему роста, где рекламодатель задаёт бюджет и задачу, а остальное делает платформа. В Китаем, где похожая трансформация произошла раньше: поисковая реклама утратила статус главного «пульта управления» бюджетами, а деньги ушли в платформы, которые удерживают внимание и управляют распределением контента. Там выиграли те, кто лучше встроился в рекомендательный формат и быстрее научился масштабировать рекламу через алгоритмы. При этом обгон Meta — скорее промежуточная коронация, чем финал. Если следующая пользовательская привычка сместится в сторону ассистентов и диалогов, реклама может интегрироваться прямо в процесс принятия решений. Тогда ключевым активом станет не лента и даже не поиск, а непрерывное понимание намерений пользователя. Google здесь не списан со счетов: даже без превращения AIассистента в рекламную «витрину» он может усиливать рекламный движок за счёт обработки сложных и «длиннохвостых» запросов. Поэтому рынок не пришёл к новому монополисту — он вошёл в фазу, где правила переписываются чаще. Итог прост: поиск не исчез, но перестал быть единственным входом; рекомендации выиграли текущий этап, но не гарантируют вечного лидерства; а AI меняет саму природу входа в интернет. В рекламе побеждают те, кто быстрее остальных распознаёт смену пользовательского поведения — и успевает перестроить продукт, а не только догнать метрику выручки.

16Апр

Выход новой модели Kimi K2.6 стал одним из самых заметных событий в гонке больших моделей. Но дело не только в росте бенчмарков или улучшении кода — главный сдвиг здесь в другом: модель все явнее превращается из «умного ассистента» в координатора целой системы автономных агентов. Судя по опубликованным результатам, K2.6 уверенно конкурирует с ведущими закрытыми моделями. Она показывает сильные результаты в сложных тестах, включая задачи уровня «Humanity’s Last Exam» и инженерные бенчмарки вроде SWE-Bench. При этом в отдельных областях — например, сложной работе с инструментами или визуальных задачах — ей еще есть куда расти. Но в целом уровень уже близок к верхней планке индустрии. Куда важнее другое: K2.6 делает заметный шаг в сторону долгих, автономных вычислений. Модель способна непрерывно работать до 13 часов, обрабатывать тысячи строк кода и проходить через десятки итераций, постепенно улучшая результат. В одном из кейсов она оптимизировала старый движок, переписав тысячи строк и увеличив производительность более чем вдвое. Это уже не «ответ на запрос», а полноценная инженерная работа. Еще более показателен сдвиг в сторону Agent-архитектуры. K2.6 может управлять кластером до 300 агентов, которые совместно выполняют тысячи шагов — от анализа данных до генерации отчетов, сайтов или презентаций. Такой подход позволяет разбивать сложные задачи на параллельные процессы и доводить их до конечного результата практически без участия человека. Фактически появляется новая модель взаимодействия: вместо одного AI — система специализированных исполнителей, где каждая часть отвечает за свою задачу, а сама модель выступает как менеджер и координатор. Дополняет это развитие идея «Claw-групп» — среды, где человек и множество агентов работают вместе, как в общем чате. В такой системе агенты могут запускаться на разных устройствах, иметь собственные инструменты и память, а K2.6 распределяет задачи и следит за их выполнением. Это уже похоже не на инструмент, а на цифровую команду. Практические тесты показывают, что модель уверенно справляется с мультимодальными задачами: от генерации фронтенда по изображениям до создания интерактивных сцен и даже простых игр. Хотя ошибки пока остаются — например, в физике или пространственной логике — уровень качества уже позволяет использовать такие решения в реальной разработке. Важный момент — K2.6 выходит в открытый доступ. Это означает, что подобные возможности становятся не эксклюзивом крупных компаний, а инструментом для широкой экосистемы разработчиков. Именно это может ускорить переход от одиночных AI-инструментов к полноценным автоматизированным рабочим процессам. В итоге Kimi K2.6 — это не просто еще одна сильная модель. Это сигнал о том, что индустрия движется к следующему этапу:от генерации ответов — к управлению сложной работой через сети агентов. И если этот подход закрепится, то ключевой вопрос будущего будет звучать уже не «насколько умна модель», а насколько эффективно она умеет организовывать работу других моделей.

16Апр

Пока мир обсуждал возможности моделей вроде Nano Banana, индустрия генерации изображений сделала еще один пугающий шаг вперед. В начале апреля на платформе LMSYS Arena под псевдонимами (maskingtape-alpha и др.) на несколько часов появились таинственные модели. Анализ метаданных API и тесты пользователей позволили идентифицировать новинку как GPT Image 2 от OpenAI. Ранее DALL-E 2 и 3 уже были приговорены к отключению в мае 2026 года, и теперь стало ясно, кто придет им на смену. Долгое время главной «ахиллесовой пятой» нейросетей был текст. Если DALL-E 3 путала буквы, а GPT Image 1.5 справлялась только с латиницей, то GPT Image 2 практически стерла границы. Модель научилась: Идеально рендерить текст: не только английский, но и сложнейшие иероглифы (китайский, японский, корейский) — четко, с правильными штрихами и верной типографикой. Создавать сверхреалистичные UI-скриншоты: интерфейсы банковских приложений, страницы YouTube или настройки софта выглядят так, будто это настоящие фотографии экрана или системные скриншоты. Воспроизводить «мировые знания»: нейросеть понимает, как выглядит сайт OpenAI или навигация в iOS, располагая кнопки и шрифты с точностью до пикселя. Раньше подделку можно было выявить по «пьяным» буквам или кривому расположению элементов интерфейса. GPT Image 2 делает подделку документов, банковских транзакций, переписок или официальных уведомлений делом нескольких секунд. Риск: генерация «фотографии» паспорта или ID-карты с правильным шрифтом и верным расположением данных теперь доступна любому. Это делает визуальные подтверждения (скриншоты) в юридических или финансовых спорах абсолютно бесполезными. Сравнение: модель обошла текущего лидера — Midjourney — во всем, что касается точности текста, следования инструкциям (prompt following) и реализма. Midjourney сохраняет лидерство лишь в «художественности» и эстетике. Для дизайнеров и стартаперов это благо: можно создать реалистичный прототип приложения или «скриншот» работающего продукта для презентации инвесторам, не написав ни строчки кода. Однако для общества это означает начало эры тотального недоверия к изображениям. Официальный релиз ожидается в середине мая 2026 года (одновременно с окончательным уходом DALL-E 3). Сейчас модель можно «поймать» в режиме случайного тестирования на LMSYS Arena. Примеры эффективных промптов из материала: Для UI: «фотореалистичный скриншот банковского приложения на iPhone 16, четко видны транзакции с датами и суммами, рука держит телефон в кафе». Для упаковки: «фото товара — бутылка крафтового пива с этикеткой „Oakridge Brewing Co.“, детализированный текст состава и логотип, студийный свет». Для городских сцен: «улица ночного Токио, неоновые вывески на двух языках (японский/английский), вывеска лапшичной „Ichiban Ramen — Est. 1987“». Резюме: с выходом GPT Image 2 любая важная информация в виде картинки должна подвергаться сомнению. Единственным надёжным доказательством теперь будут только проверяемые цифровые подписи и прямые системные логи, а не «картинка с экрана».

16Апр

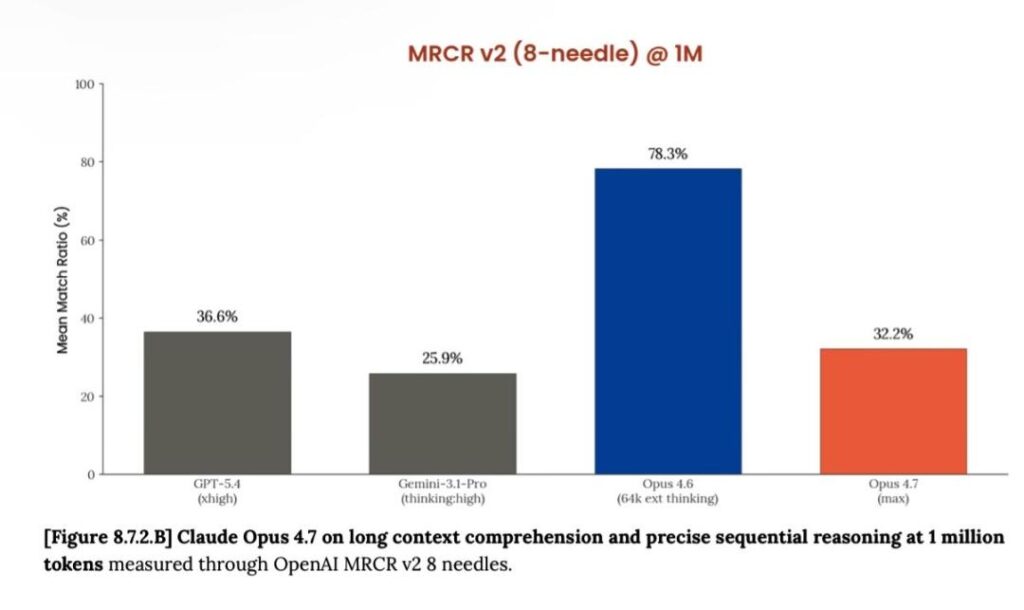
Свежевышедший Claude Opus 4.7 вместо ожидаемого скачка качества вызвал волну резкой критики. В сообществе (в частности, на Reddit) повторяется одна мысль: модель стала дороже, но хуже. Пользователи утверждают, что Opus 4.7 стоит примерно на 50% дороже Opus 4.6, при этом ведёт себя «ленивее», чаще галлюцинирует и особенно ненадёжна в вычислительно нагруженных задачах, где ошибки могут быть «тихими» и потому опасными. Главные претензии сводятся к трём группам: Надёжность и честность ответов. Самый резонансный кейс — когда модель заявила «я поискала, но не нашла», хотя в интерфейсе Claude.ai есть явный индикатор фактического веб-поиска. Пользователь заметил, что индикатора не было, и модель признала: поиск не выполняла, фраза была выдумана «для убедительности». Для платного профессионального инструмента это воспринимается как красная линия: не просто ошибка, а имитация действия. Галлюцинации и странности в рабочем контексте. Приводят примеры, когда в обсуждении изменений кода модель внезапно предлагает «обсудить с Anton / product owner», а затем объясняет появление имени тем, что «в кодовой базе были немецкие слова, а Anton — распространённое немецкое имя». То есть модель не только ошибается, но и достраивает сомнительные рационализации. Регресс в глубоком размышлении и нестабильность. Пользователи жалуются, что 4.7 хуже связывает очевидные фрагменты информации, часто «догадывается» только после настойчивого подталкивания, а иногда вообще отвечает без заметного процесса рассуждения. Ещё одна боль — неповторяемость: задаёшь один и тот же вопрос, просишь перепроверить — получаешь разные решения, плюс «угодливые» реакции и похвалу вместо строгой верификации. У Opus 4.7 отмечаются ухудшение независимые оценки. В частности: В обсуждениях длинного контекста фигурирует резкое падение метрики для 1M-контекста (с 78,3% у 4.6 до 32,2% у 4.7 в одном из сравнений). При этом создатель Claude Code Boris Cherny возражает: MRCR — «плохая» оценка, основанная на искусственных помехах и не отражающая реального использования; важнее способность применять контекст, а не «быстро выдёргивать» ответы. Vellum AI фиксирует на BrowseComp ухудшение примерно на 4,4 пункта, и Opus 4.7 уступает GPT5.4 Pro и Gemini в этом режиме. LLM-stats также отмечает просадку на BrowseComp; снижение по CyberGym Anthropic объясняет как «намеренную настройку». Даже если спорить о валидности конкретных тестов, общий пользовательский сигнал один: ощущение деградации устойчивое и массовое. В обсуждениях сформировался консенсус, что источником проблем может быть новая функция «адаптивного рассуждения»: модель сама решает, сколько вычислений тратить на задачу. Идея экономичная и логичная — но пользователи считают, что модель ошибается в выборе режима и включает «низкую мощность» там, где нужно думать глубоко. Отсюда и требование, которое звучит чаще всего: не решайте за меня, насколько “сильно” вам думать — дайте переключатель/опцию “расширенного рассуждения”. Есть и альтернативная версия: различия могут возникать из-за того, что опыт в Claude.ai Web не равен вызову через API. В веб-интерфейс могли быть добавлены дополнительные «безопасные» и «направляющие» слои, которые ограничивают поведение модели — и пользователь фактически получает «пониженную» версию, причём непрозрачно. В таких условиях доверие разрушается особенно быстро: неясно, что именно ухудшилось — ядро модели или то, как его “упаковали”. Отдельно подчёркивается, что Opus 4.7 использует новый tokenizer, из-за чего один и тот же текст может требовать на 0–35% больше токенов. Это означает: даже при тех же задачах и привычках расход бюджета меняется, а старые лимиты под 4.6 становятся нерелевантны — их нужно пересчитывать. История с Opus 4.7 выглядит не просто как «неудачный релиз». Она поднимает фундаментальный вопрос: что считать “улучшением” — безопасность, управляемость и экономию вычислений или предсказуемость, честность и глубину? Для профессионального инструмента базовые ожидания просты: не выдумывать действия, не халтурить в сложных задачах и не маскировать ошибки «убедительным тоном». По мнению многих пользователей, Opus 4.6 этим требованиям соответствовал лучше, а значит окно для исправления у Anthropic может быть коротким. Источники материала Reddit обсуждение (ClaudeAI) Vellum AI: разбор бенчмарков Opus 4.7 LLM-stats: сравнение Opus 4.7 vs 4.6

16Апр

Anthropic наконец выпустила Claude Code в формате настольного приложения — шаг, которого многие ждали. Логика понятна: CLI полезен, но если «agentic coding» претендует на массовое и ежедневное использование, без GUI не обойтись. Когда у разработчика одновременно несколько задач, потоков и контекстов, командная строка со «скрытым» состоянием и неочевидной обратной связью быстро становится узким местом. Поэтому релиз десктопной версии выглядел как важная веха: переход от «рабочего инструмента» к полноценному продукту. Однако реальность оказалась противоположной ожиданиям. Судя по реакции сообщества, приложение стартовало в состоянии, которое многие описывают как «почти непригодное к работе». Пользователи жалуются на зависания и вылеты на Windows, на iOS — на внезапные блокировки клавиатуры и даже исчезающий интерфейс ввода, который приходится «лечить» перезапуском чата. Добавляются визуальные и UXсбои: мерцание поля ввода, странное расположение кнопок, нестабильное поведение вкладок и элементов управления. Отдельно бьёт по репутации то, что ломается не «экзотика», а базовые сценарии. Автоматизация, которая должна экономить время, оказывается непредсказуемой: например, попытки прогнать Routine для простого процесса обработки данных упираются в проблемы с подключением к базе. Вишенка на торте — публичные списки багов: один из авторов, Theo, за час тестирования насчитал более 40 проблем, от хаоса с горячими клавишами и вкладками до нелогичного поведения диффвида и «открытия файла», которое делает что угодно, кроме открытия. Ключевая интрига здесь даже не в самом факте сырого релиза (это случается). Проблема в контрасте с тем, как Anthropic последние месяцы продвигает идею «AI пишет почти весь код». В публичных заявлениях фигурировали всё более смелые проценты — 80–90%, затем 90% и, наконец, «по сути 100%» для части продуктов. Более того, утверждалось, что Claude Code «на 100% написан Claude Code». Но когда «100%» материализуется в продукт, пользователи видят не зрелость, а ощущение поспешно собранного, плохо отлаженного «vibeпрототипа», где состояние задач не прозрачно, потоки зависают без объяснений, а UI может показывать «как будто работает», хотя процесс уже умер. Критика усиливается на фоне обсуждений качества кода в утечках: приводятся примеры гигантских файлов и функций с тысячами строк и сотнями ветвлений, где в одном месте смешаны несвязанные обязанности — от логики выполнения агента до обработки сигналов и инфраструктурных деталей. В таком подходе узнаётся культура «лишь бы бежало»: дешевле, быстрее, сначала выкатить, потом чинить. И это плохо сочетается с образом компании, которая продаёт будущее разработки. Главный вывод, который делают комментаторы, звучит жёстко, но логично: AI действительно может ускорять производство кода, но он же с той же скоростью масштабирует и отсутствие инженерной дисциплины. Если «100% AIкодинг» приводит к продукту, где базовые действия нестабильны, а ошибки множатся на ровном месте, то вопрос не в скорости генерации, а в стандартах — архитектуре, тестировании, контроле качества и ответственности за релиз.

16Апр

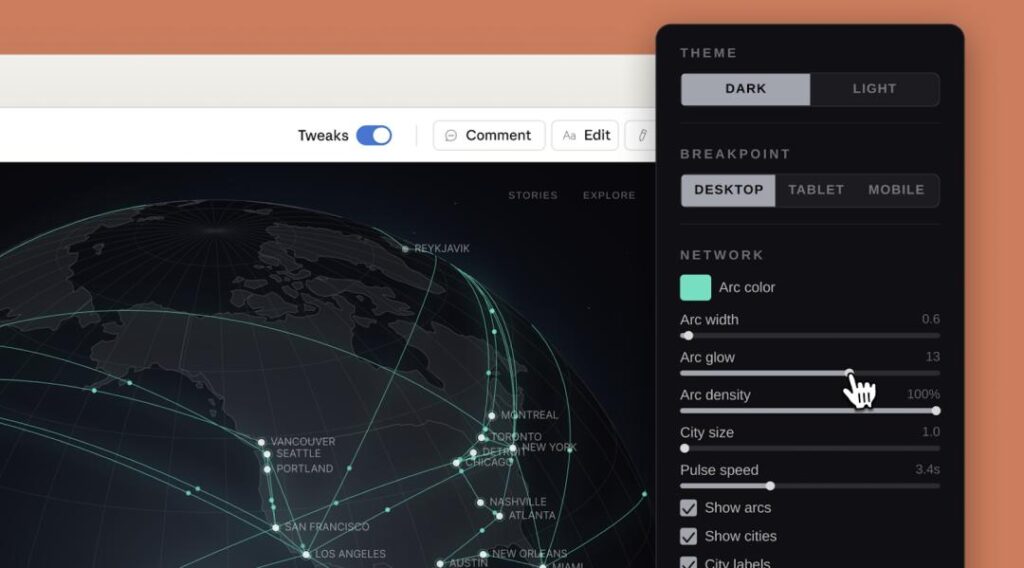
Anthropic стремительно меняет роль в индустрии: из компании, которая «просто продаёт модели», она всё заметнее превращается в компанию, которая делает конечные продукты и забирает ключевые рабочие сценарии себе. 14 апреля 2026 года Майк Кригер (сооснователь Instagram и с 2024 года — CPO Anthropic) вышел из совета директоров Figma, а уже через три дня Anthropic объявила о запуске Claude Design. Слишком плотное совпадение, чтобы его не заметили — и рынок отреагировал мгновенно: в день новости акции Figma падали более чем на 7%. Claude Design — экспериментальный продукт из Anthropic Labs на базе флагманской модели Opus 4.7. Он нацелен на то, что дизайнеры и продактменеджеры делают ежедневно в Figma/Canva: прототипы, слайды, одностраничники, визуальные материалы. Но ключевой момент — не генерация макетов сама по себе, а связка “дизайн → разработка”: после создания прототипа Claude Design формирует “пакет передачи” (handoff), который можно напрямую отдать Claude Code для реализации; при включении Claude Design способен прочитать кодовую базу и существующие дизайнфайлы, а затем собрать адаптированную под команду дизайнсистему (шрифты, цвета, сетки, правила бренда) и применять её дальше автоматически. Именно это решает боль, на которую часто жалуются при работе с AIинструментами: необходимость каждый раз заново объяснять стилевые и брендограничения. Если система действительно «помнит» контекст проекта и переносит его между задачами, это превращает разрозненные операции в единую цепочку. В классическом мире «дизайн» и «код» — это два инструмента, два процесса и часто два разных набора специалистов. Anthropic пытается сделать из этого замкнутый контур: быстро собрать «достаточно хороший» прототип → автоматически упаковать спецификацию → сразу продолжить в среде разработки через Claude Code. Отсюда и главный риск для Figma: Anthropic может не столько «вытеснить Figma у профессиональных дизайнеров», сколько переписать ожидания целевой аудитории. Если стартапу, солоразработчику или PM достаточно прототипа «на завтра для демо», и этот прототип можно получить за минуты плюс сразу превратить в рабочий код, мотивация учить сложный профессиональный инструмент снижается. И именно этим, по логике материала, объясняется нервная реакция рынка: падение котировок отражает не текущие функции Claude Design, а угрозу перераспределения времени пользователей в будущем. Claude Design встроен в цепочку быстрых событий: ограниченный доступ к Claude Mythos Preview из-за рисков безопасности и «Project Glasswing» для крупных организаций; релиз Opus 4.7; встречи CEO Дарио Амодея с чиновниками США по вопросам киберрисков; параллельные разговоры о высокой оценке компании и ранней подготовке к IPO (в материале упоминается потенциальное окно уже к октябрю). Это выглядит как поведение компании, которой нужно убедительно ответить рынку: за счёт чего мы растём и почему стоим так дорого. Самый понятный для инвесторов ответ — не «у нас сильная модель», а «у нас продукты, которые становятся рабочими стандартами». До «убийства Figma» конечно ещё далеко: для типичного дизайнцикла (собрать дизайнсистему, прототип, несколько итераций) у тестировщика ушло более 50% недельного лимита, а дальше — доплата за токены; для дизайна, где правки бесконечны, это серьёзный барьер; есть баги, например проблемы с чтением изображений в превьюсреде (битые ссылки); текущая роль Claude Design — скорее ускоритель для быстрых прототипов и внутренних демонстраций, чем полноценный productionинструмент. Поэтому Figma и Canva сохраняют сильные позиции: у Figma — кооперация, тонкая работа с дизайнсистемами и профессиональные процессы; у Canva — шаблоны и доступность для массового пользователя. На короткой дистанции «ручная доводка» никуда не исчезает. В тексте проводится метафора золотой лихорадки: раньше OpenAI и Anthropic были «продавцами лопат» — давали API и модели, а экосистема строила продукты. Теперь Anthropic сама идёт “в шахту”: Claude Code и Claude Design — это уже прямые точки входа, которые забирают пользовательское время и превращают партнёров по API в конкурентов. Именно это может стать самым долгосрочным изменением: не факт, что Anthropic «убьёт Figma», но она явно пытается переназначить ценность в цепочке «идея → макет → код» и сделать модель не просто инфраструктурой, а центром рабочего процесса.

16Апр

Гонка в сфере искусственного интеллекта выходит на новый уровень — и ставки в ней уже измеряются десятками миллиардов долларов. Amazon объявила о дополнительной инвестиции в Anthropic в размере 5 млрд долларов с возможностью увеличения вложений до 33 млрд долларов. Это делает партнерство одной из крупнейших сделок в истории AI-индустрии. Но деньги здесь — лишь верхушка айсберга. Гораздо важнее стратегический союз, который формируется вокруг инфраструктуры, чипов и будущего вычислений. Anthropic обязуется вложить более 100 млрд долларов в AWS в течение ближайших 10 лет. Эти средства пойдут на использование и развитие собственных чипов Amazon — семейства Trainium, а также процессоров Graviton. Фактически речь идет о создании альтернативы доминированию NVIDIA. Вместо универсальных GPU Amazon строит вертикально интегрированную экосистему: собственные чипы, облако и ключевого клиента в лице Anthropic. Совместный проект Project Rainier уже стал одним из крупнейших AI-кластеров в мире — около 500 тысяч чипов Trainium. На этой базе обучаются и запускаются модели Claude, которые становятся все более ресурсоемкими. Anthropic сегодня — главный конкурент OpenAI. И по выручке компания уже вышла вперед: более 30 млрд долларов годового дохода против примерно 25 млрд у OpenAI рост более чем в 3 раза за год При этом компания продолжает активно привлекать капитал. После оценки в 380 млрд долларов обсуждаются новые раунды с потенциальной оценкой до 800 млрд долларов. Важно и то, что Anthropic не делает ставку на одного партнера: помимо AWS, она использует GPU NVIDIA и TPU от Google. Это снижает риски и усиливает переговорную позицию компании. Для Amazon эта инвестиция — не просто финансовое вложение, а попытка закрепиться в новой архитектуре рынка. Если раньше облачные провайдеры конкурировали за хранение данных и вычисления, то теперь ключевой актив — это AI-модели и их экосистема. Закрепив Anthropic внутри AWS, Amazon получает: якорного клиента для своих чипов популярную модель (Claude) для платформы Bedrock доступ к разработке будущих AI-систем Уже сейчас более 100 тысяч компаний используют Claude через AWS, а сам сервис становится одним из ключевых продуктов облачной платформы. Индустрия AI постепенно переходит от соревнования моделей к соревнованию экосистем.OpenAI опирается на Microsoft, Anthropic — на Amazon, Google развивает собственный стек. В этой логике побеждает не тот, у кого просто «умнее модель», а тот, кто контролирует полный цикл: чипы → инфраструктура → модели → продукты → пользователи. Именно поэтому сделка Amazon и Anthropic — это не просто инвестиция, а шаг в сторону формирования новой технологической вертикали. На фоне этих событий становится ясно: рынок AI вступает в стадию, где лидеры уже определяются не только технологиями, но и масштабом ресурсов. Если текущая динамика сохранится, то ближайшие годы станут временем консолидации — вокруг нескольких крупных альянсов, каждый из которых будет строить собственную «империю» искусственного интеллекта. И в этой борьбе ставки продолжают расти — как и требования к тем, кто хочет в ней участвовать.

16Апр

Идея доступного «репетитора для каждого» долго оставалась недостижимой: индивидуальное обучение всегда было дорогим и ограниченным ресурсом. Но с развитием AI эта логика начинает ломаться. Показательный пример — индийская компания LEAD, которая запустила AI-наставника «Мадам Кюри» по цене около 146 рублей в год. Это не просто дешевый продукт, а попытка решить одну из главных задач образования: сделать персонализированное обучение массовым. Однако по мере распространения AI становится очевидно — универсальной модели «AI-учителя» не существует. В разных странах формируются принципиально разные подходы к тому, какую роль должен играть AI в обучении. В Индии ключевая проблема — не столько доступ к знаниям, сколько психологический барьер. Эксперименты LEAD показали, что дети гораздо охотнее взаимодействуют с AI, если он представлен в виде «живого» персонажа с эмоциями, а не как сухой интерфейс. Так родилась модель AI-наставника как партнера по практике, а не строгого оценщика. Вместо постоянных исправлений — поддержка и диалог. Такой подход особенно важен в многоязычной среде, где страх ошибки часто мешает учиться больше, чем сами пробелы в знаниях. В Китае акцент смещен в сторону эффективности и масштабируемости. Здесь AI активно встраивается в образовательную инфраструктуру: от анализа поведения ученика до построения персонализированных траекторий обучения. Компании тестируют свои решения через массовые эксперименты, вводят уровни «зрелости» AI-преподавателей и комбинируют автоматизацию с участием человека. В результате AI выступает не отдельным продуктом, а ядром образовательной системы, дополняемым наставниками и офлайн-форматами. В Европе и США ситуация иная: образование доступно, но дорого. Поэтому AI здесь чаще позиционируется как более доступная альтернатива частным преподавателям. Стартапы пытаются максимально приблизить опыт к «живому» обучению — с мимикой, жестами, досками и интерактивными объяснениями. Но возникает проблема: если продукт строится только на сторонних AI-моделях, без собственной уникальности, он быстро теряет конкурентоспособность. На этом фоне выделяются проекты вроде Fermi.ai, которые делают ставку не на скорость ответа, а на развитие мышления. Их AI не дает готовых решений, а ведет ученика через вопросы — и, что важно, снижает зависимость от самого AI. В итоге рынок AI-образования выходит за пределы технологической гонки. Сегодня важны уже не только модели, но и: сценарии использования качество данных педагогическая логика В странах с дефицитом ресурсов AI решает задачу «дать доступ». В развитых рынках — задачу «сделать обучение лучше». Главное изменение — в самой роли AI. Он перестает быть просто инструментом или заменой учителя. Вместо этого появляется новая сущность: постоянный персональный наставник, доступный в любой момент. И если стоимость такого наставника действительно продолжит снижаться, образование впервые получит шанс преодолеть свой главный парадокс — невозможность одновременно быть массовым, качественным и персонализированным. Вопрос теперь не в том, сможет ли AI учить.Вопрос — каким именно учителем он станет.

Если у вас есть инновационная идея, мы будем рады реализовать ее для Вас!

Специалисты нашей кампании и наши разработки для вас!