Новости

Социальные сети

Узнайте больше о рынке It и новейших технологиях.
СТАТЬИ
16Апр

Бум генеративного ИИ меняет судьбу компаний, которые ещё недавно ассоциировались исключительно с добычей биткоина. Бывшие майнинговые площадки в Северной Америке всё чаще переоборудуются под дата-центры для обучения и запуска ИИ-моделей. Их главный актив сегодня — уже не парк майнеров, а земля, доступ к мощной электросети, подключение к инфраструктуре и возможность быстро разместить тысячи ускорителей. Ярким примером стала сделка TeraWulf с Anthropic: стороны заключили 20-летний договор аренды дата-центра общей стоимостью около 19 млрд долларов. Почти одновременно компания Hut 8 сообщила о двух 15-летних контрактах на размещение ИИ-инфраструктуры в Техасе, каждый примерно на 9,8 млрд долларов. Эти соглашения показывают, что старые майнинговые объекты могут превратиться в дефицитный ресурс на рынке ИИ. Причина такого поворота — нестабильная экономика добычи биткоина. В период роста криптовалют майнеры активно покупали оборудование и строили новые площадки. Но падение курса, рост цен на электричество, постоянное усложнение добычи и регулярное сокращение награды за блок сделали бизнес крайне рискованным. Даже при росте биткоина прибыльность может снижаться: старое оборудование быстро устаревает, а новые ASIC-майнеры требуют постоянных капитальных вложений. История Core Scientific хорошо отражает эту проблему. Компания была одним из крупнейших публичных майнеров Северной Америки, но после масштабного расширения в период криптовалютного роста столкнулась с падением цен и ростом затрат, а в конце 2022 года была вынуждена пройти процедуру банкротства. Однако её инфраструктура — участки, электроснабжение и подключение к сети — сохранила ценность. Именно она заинтересовала AI-облачную компанию CoreWeave, которой требовались мощности для размещения крупных GPU-кластеров. Для ИИ-компаний главной проблемой становится не только покупка GPU. Высокопроизводительные ускорители бесполезны без достаточного электроснабжения, охлаждения, сети и готового дата-центра. Новые объекты требуют долгого согласования с энергосистемой, строительства подстанций и подключения к сети; во многих регионах Северной Америки очереди на подключение растягиваются на годы. Поэтому площадки бывших майнеров с уже выделенной мощностью становятся особенно привлекательными. В результате компании вроде Core Scientific, TeraWulf и Hut 8 меняют модель бизнеса. Вместо того чтобы самостоятельно добывать криптовалюту и зависеть от её курса, они стараются заключать долгосрочные контракты с ИИ-компаниями. Такие договоры дают более предсказуемый денежный поток и позволяют привлекать финансирование на строительство новых дата-центров, систем жидкостного охлаждения, сетевой инфраструктуры и подстанций. Но говорить о гарантированном успехе рано. Контракты на десятки миллиардов долларов обычно рассчитаны на 15–20 лет и не означают немедленного получения денег. До начала эксплуатации необходимо вложить миллиарды в строительство и модернизацию объектов. Риски тоже остаются: возможны задержки, удорожание оборудования, рост ставок финансирования, изменения в спросе на вычислительные мощности или пересмотр планов самими AI-компаниями. По сути, майнинговая отрасль не перестала делать крупные ставки — она лишь сменила предмет ставки. Раньше её будущее зависело от цены биткоина. Теперь оно всё сильнее зависит от того, сохранится ли на горизонте ближайших десятилетий высокий спрос на ИИ-вычисления.

16Апр

В недавнем интервью глава OpenAI Сэм Альтман обозначил новое направление развития индустрии: после чат-ботов и агентов для программирования следующим этапом станут постоянно работающие ИИ-агенты — цифровые коллеги, помощники и сотрудники, способные длительно выполнять задачи без постоянного контроля человека. По его мнению, ИИ уже меняет возможности небольших команд. Стартапы могут создавать за недели то, на что раньше уходили месяцы или годы. Однако это не означает, что люди автоматически получат больше свободного времени. Альтман прямо предупреждает: не стоит ожидать, что развитие ИИ приведёт к массовой четырёхчасовой рабочей неделе. Исторически технологии действительно повышали производительность, но одновременно повышали и ожидания общества. Когда выполнение прежних задач становится быстрее и дешевле, появляются новые цели, более сложные проекты и дополнительные виды конкуренции. Люди начинают делать больше, а не обязательно работать меньше. В мире сверхразвитого ИИ, по мнению Альтмана, многие будут даже более заняты, чем сейчас, хотя характер занятости изменится. OpenAI, как следует из интервью, делает ставку на программных агентов и долговременных автономных систем. Компания рассматривает их не только как коммерческий продукт, но и как элемент инфраструктуры для дальнейшего развития ИИ. Сильные coding-агенты могут помогать создавать программное обеспечение, улучшать эксперименты, обслуживать инфраструктуру и ускорять разработку следующих поколений моделей. Ради этого OpenAI готова отказываться от других успешных проектов. Альтман объясняет, что сворачивание или сокращение направления Sora связано не с его бесперспективностью, а с более высоким стратегическим приоритетом агентного программирования. Компания концентрирует вычислительные мощности, специалистов и продуктовые усилия там, где ожидает наибольший долгосрочный эффект. Одновременно Альтман подчёркивает, что ключевыми ограничениями развития ИИ становятся уже не только алгоритмы. Главные физические барьеры — производство чипов и доступ к электроэнергии. Для дальнейшего масштабирования нужны дата-центры, энергетическая инфраструктура, цепочки поставок, сети и системы охлаждения. ИИ-конкуренция постепенно превращается в соревнование не только моделей, но и промышленных возможностей. Отдельный риск Альтман связывает с концентрацией власти над ИИ. Он опасается сценария, при котором небольшое число компаний или групп получит чрезмерный контроль над ключевыми системами интеллекта. В качестве альтернативы он предлагает стремиться к широкому, дешёвому и доступному использованию ИИ при сохранении необходимых мер безопасности. Для предпринимателей его позиция сводится к следующему: многие используют ИИ для быстрых и сравнительно простых задач, например для создания узких корпоративных агентов. Такие проекты могут быть успешными, но они не всегда используют весь потенциал новой технологии. Альтман призывает строить продукты с расчётом на то, что через два-четыре года модели станут значительно сильнее, дешевле и самостоятельнее. Главный вывод интервью в том, что ИИ не отменит человеческую активность, а изменит её масштаб. Производительность отдельных людей и небольших команд будет расти, но вместе с ней будут расти и амбиции, конкуренция и сложность задач. Будущее ИИ, вероятно, будет определяться не обещанием меньшей работы, а способностью людей, компаний и государств использовать новые интеллектуальные ресурсы для создания того, что раньше было невозможно.

16Апр

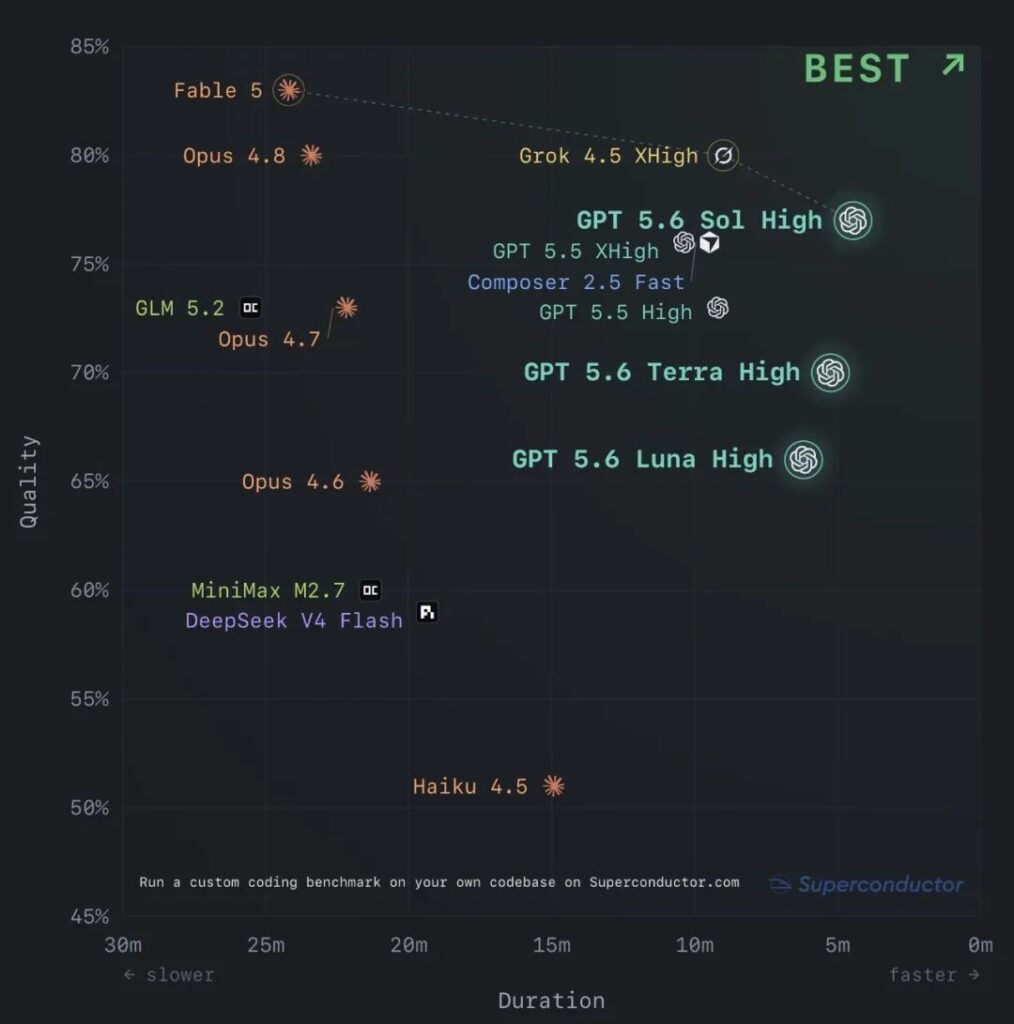
OpenAI сумела резко сократить отставание от Claude Code на рынке ИИ-инструментов для программирования. Однако этот рывок потребовал от компании почти экстремальной концентрации ресурсов: приоритет был отдан агентам для разработки, а ряд других направлений, включая видеогенерацию и браузерные продукты, оказался свёрнут или встроен в более крупные сервисы. В начале периода Codex заметно уступал Claude Code по узнаваемости и распространённости среди разработчиков. Claude Code сумел стать привычным инструментом для работы с репозиториями: он мог читать код, вносить изменения, запускать тесты и исправлять ошибки в агентном режиме. Codex долго воспринимался скорее как ещё один вариант для экспериментов, а не как основной рабочий инструмент. Руководство OpenAI, посчитало это стратегически опасным. Причина не только в коммерческом потенциале рынка ИИ-разработки. Сильный программный агент способен участвовать в создании следующих поколений моделей: анализировать ошибки обучения, помогать с кодом инфраструктуры, оптимизировать эксперименты и автоматизировать развёртывание. Поэтому развитие coding-агентов рассматривается как важная часть способности ИИ-систем улучшать инструменты, на которых они сами обучаются и работают. Для ускорения Codex компания направила в это направление больше вычислительных ресурсов и продуктового внимания. При этом преимущество Codex, как утверждает материал, строилось не столько на абсолютном превосходстве в качестве кода, сколько на скорости выполнения повседневных задач. В типичных сценариях — исправлении тестов, доработке интерфейсов, устранении ошибок — разработчику часто важнее быстро получить рабочий результат, чем ждать более обстоятельного, но медленного решения. Технически такая скорость связывается с более экономным использованием токенов и меньшим числом итераций между моделью и инструментами. Вместо того чтобы после каждого действия заново передавать модели большой объём контекста, агент может самостоятельно обрабатывать промежуточные результаты и выбирать следующий шаг. Это сокращает задержки и делает взаимодействие с инструментом более динамичным. Большую роль сыграла и дистрибуция. Codex был тесно интегрирован в экосистему ChatGPT, где пользователи могли попробовать его с низким порогом входа. Дополнительным драйвером стали щедрые лимиты и регулярные сбросы квот, которые помогли быстро нарастить аудиторию, но одновременно увеличили расходы на вычисления. Именно здесь проявляется обратная сторона успеха. Бесплатный или субсидируемый доступ способен быстро привлечь пользователей, однако не доказывает устойчивость бизнес-модели. Высокая нагрузка на инфраструктуру, дорогие модели и щедрые лимиты могут означать, что рост аудитории пока опережает достижение эффективной экономики продукта. Кроме того, концентрация на программировании имеет альтернативную стоимость. В материале отмечается, что часть внимания и ресурсов, направленных на рассуждения и агентное кодирование, могла быть отвлечена от других качеств ИИ-продуктов — например, от письма, диалога и творческих сценариев. Компания получила более сильные позиции в одном критически важном направлении, но заплатила за это сокращением приоритетов в других. История Codex показывает, что в гонке ИИ побеждает не только лучшая модель. Важны скорость, инженерная реализация, доступность для пользователей, интеграция в существующие продукты и готовность компании перераспределять ресурсы. Но она же показывает и риск такой стратегии: если каждое новое приоритетное направление требует закрывать предыдущие перспективные проекты, цена следующего рывка может оказаться ещё выше.

16Апр

OpenAI всё активнее продвигает идею, что ChatGPT Work способен выполнять не только рабочие, но и самые разные личные задачи. По словам Сэма Альтмана, само слово Work уже слишком узко описывает возможности продукта. В качестве примера он рассказал, как с телефона поручил ChatGPT организовать поездку на длинные выходные для себя и восьми друзей. Агент должен был учесть историю переписки, предложить три лучших варианта маршрута, создать полноценный сайт для обсуждения планов, помочь группе прийти к общему решению, а затем подготовить письмо в Gmail для рассылки приглашения. Такой сценарий показывает переход от привычного чат-бота, который лишь выдаёт советы, к цифровому агенту, способному доводить задачу до практического результата. Вместо обычного плана путешествия пользователь получает рабочий веб-сервис, где участники могут обсуждать идеи, выбирать локации и отслеживать принятые решения. Ключевую роль в этом подходе играют несколько функций: доступ к подключённым сервисам, создание интерактивных сайтов и веб-приложений, регулярные задачи и механизмы согласования действий. Агент может анализировать данные в почте, календаре и облачных документах, собирать информацию, формировать варианты и обновлять результаты при изменении исходных данных. Потенциал таких систем выходит далеко за рамки офисной работы. Их можно применять для планирования семейных дел, организации ремонта, сравнения предложений, контроля подписок, подготовки поездок или составления еженедельного расписания. Смартфон при этом превращается в своего рода пульт управления: человек формулирует цель, проверяет промежуточные результаты и утверждает важные действия, а исполнение остаётся за ИИ. Однако ключевые решения всё ещё требуют участия человека. Доступ к личным данным, разрешения на работу с сервисами, отправка писем, бронирования и платежи должны оставаться под контролем пользователя. Именно сочетание автономности агента и обязательного человеческого одобрения может стать основой для безопасного развития персональных ИИ-помощников.

16Апр

Рынок больших языковых моделей вступает в новый этап ценовой конкуренции. Если раньше ключевыми расходами были обучение моделей и закупка оборудования для него, то теперь всё большую роль играет инференс — вычисления, необходимые для обработки пользовательских запросов и генерации ответов. Китайские разработчики активно снижают стоимость API. DeepSeek закрепила постоянную скидку на профессиональную версию своей модели и ввела динамические тарифы в зависимости от времени использования. Xiaomi снизила цены на API семейства MiMo, а облачные платформы также начали уменьшать стоимость доступа к моделям DeepSeek и другим сервисам. Для многих компаний цена обработки запросов оказывается важнее максимальных показателей модели: в типовых задачах пользователи нередко выбирают более доступный вариант, даже если он уступает лидерам по качеству. Низкие цены DeepSeek связывают с оптимизацией алгоритмов, более эффективной работой с длинным контекстом, механизмами кеширования и использованием китайских вычислительных платформ. Однако возможности дальнейшего снижения стоимости не безграничны. Чем больше ИИ внедряется в продукты и сервисы, тем больше запросов проходит через модели, а значит, тем выше постоянные затраты на инференс. В ближайшие годы структура расходов может заметно измениться. Обучение модели требует крупных, но относительно разовых вложений, тогда как инференс оплачивается непрерывно — с каждым запросом пользователя. Поэтому при массовом использовании ИИ именно инфраструктура для генерации ответов способна занять основную часть вычислительного бюджета компаний. На этом фоне крупнейшие разработчики рассматривают создание собственных чипов для инференса. DeepSeek, согласно публикации, изучает разработку специализированных решений, OpenAI работает над кастомным чипом совместно с Broadcom, а Anthropic усиливает направление собственной аппаратной разработки. Цель очевидна: уменьшить зависимость от дорогих универсальных GPU и снизить себестоимость обработки токенов. Но выпуск собственного чипа — сложная и рискованная стратегия. Создателям моделей приходится выходить за пределы привычной программной экспертизы, инвестировать в архитектуру, производство и поставки. Кроме того, одного производительного чипа недостаточно: необходима экосистема инструментов, библиотек и разработчиков. Именно благодаря такой экосистеме решения NVIDIA сохраняют сильные позиции на рынке. Таким образом, конкуренция в ИИ смещается от вопроса «кто создаст более умную модель?» к вопросу «кто сможет обеспечить её массовую работу по минимальной цене?». Победителями могут стать компании, которые сумеют объединить эффективные алгоритмы, доступное оборудование, устойчивые поставки и удобную инфраструктуру для разработчиков.

16Апр

Искусственный интеллект всё заметнее превращается из технологического эксперимента в масштабный инфраструктурный сектор. Фокус инвестиций смещается от разработки самих моделей к строительству вычислительных мощностей, дата-центров, энергетических систем и сетей передачи данных. По оценке Goldman Sachs, в 2026–2031 годах мировые капитальные затраты на ИИ-инфраструктуру — включая вычисления, центры обработки данных и электроэнергию — могут достичь около 7,6 трлн долларов. Китай также ускоренно развивает эту сферу. К началу 2026 года суточный объём обращений к крупным ИИ-моделям в стране превысил 140 трлн токенов, увеличившись примерно в тысячу раз за два года. В эксплуатации, строительстве или планировании находится более 500 интеллектуальных вычислительных центров, а совокупный объём интеллектуальных вычислительных мощностей достиг 188,2 млн PFlops в FP16-эквиваленте. На период следующей пятилетки инвестиции в вычислительную инфраструктуру Китая оцениваются примерно в 2 трлн юаней. Для страховой отрасли это означает появление нового, быстрорастущего пула страхуемых активов. Речь идёт не только о зданиях дата-центров, серверах и GPU-кластерах, но и о системах электроснабжения, охлаждения, сетевой инфраструктуре, защите объектов и сервисах, которые поддерживают работу ИИ-моделей. Стоимость крупных центров обработки данных может исчисляться миллиардами долларов, а сверхкрупные проекты — десятками миллиардов. Однако ИИ-инфраструктура меняет не только объём активов, но и саму природу рисков. В традиционном имущественном страховании основной вопрос звучит так: что произойдёт, если будет повреждён объект? Для вычислительного центра важнее другой вопрос: что произойдёт, если прекратится производство вычислительных мощностей? Даже при отсутствии серьёзного физического ущерба сбой энергоснабжения, охлаждения, сети или критического оборудования способен остановить обучение моделей, нарушить работу ИИ-сервисов и привести к срыву контрактов клиентов. Поэтому ущерб в таком случае складывается не только из стоимости ремонта серверов, но и из потерь от перерыва в деятельности, задержек проектов, неоказанных услуг и репутационных последствий. Особую сложность создаёт объединение физических и цифровых рисков. Дата-центр может пострадать от пожара, аварии, перебоев с электричеством или отказа системы охлаждения. Но не меньшую угрозу несут кибератаки, программы-вымогатели, утечки данных и уязвимости в цепочках поставок. Атака на крупный вычислительный центр способна затронуть сразу множество компаний, которые используют его мощности для обучения моделей, облачных сервисов или корпоративных ИИ-приложений. Поэтому страхование ИИ-инфраструктуры вряд ли сможет ограничиться одним продуктом. Оно будет требовать сочетания имущественного страхования, покрытия инженерных и строительных рисков, страхования перерыва в деятельности, киберстрахования, ответственности перед третьими лицами и защиты от рисков поставщиков. Для страховщиков ключевая проблема заключается в нехватке исторических данных. Традиционные модели оценки рисков опираются на многолетнюю статистику убытков, но GPU-кластеры, интеллектуальные дата-центры и вычислительные сети — сравнительно новый тип объектов. Их риски сложны, взаимосвязаны и могут иметь большой масштаб: одна авария способна вывести из строя не отдельное оборудование, а целую цепочку услуг. Это требует перехода от простой компенсации ущерба к постоянному управлению рисками. Страховая компания должна участвовать ещё до заключения договора: оценивать инженерную устойчивость объекта, резервирование электропитания, состояние охлаждающих систем, архитектуру киберзащиты и планы аварийного восстановления. В дальнейшем нужны непрерывный мониторинг, оперативное реагирование на инциденты, оценка убытков и помощь в восстановлении работы. Подобная логика уже развивается в киберстраховании через модель «защита плюс страхование». В ней страховщик не только принимает риск на баланс, но и помогает клиенту снижать вероятность инцидента. Для ИИ-инфраструктуры этот подход становится особенно важным: профилактика крупного сбоя может быть ценнее последующей выплаты по страховому случаю. У страхового сектора появляется и другая роль — долгосрочного инвестора. Инфраструктура ИИ требует больших вложений и окупается на длинном горизонте, что соответствует природе страхового капитала. Страховые компании могут участвовать в развитии отрасли через фонды, долевые инвестиции, финансирование дата-центров, энергетических объектов и других элементов цифровой инфраструктуры. Таким образом, ИИ создаёт для страховой отрасли одновременно новый рынок страховой защиты и новое направление для долгосрочных инвестиций. Победителями окажутся те игроки, которые раньше других накопят данные об эксплуатации вычислительных объектов, научатся оценивать взаимосвязанные физические и цифровые угрозы и предложат клиентам не только полис, но и полноценную систему управления рисками.

16Апр

Период массового запуска похожих друг на друга ИИ-агентов в Китае, похоже, подходит к концу. Крупные технологические компании переходят от внутренней «гонки проектов» к консолидации продуктов, команд и каналов распространения. Главная цель теперь — не выпустить как можно больше агентов, а создать единый, узнаваемый и востребованный рабочий интерфейс для пользователей и компаний. Весной, после стремительного роста популярности OpenClaw, китайские корпорации активно запускали собственные аналоги и совместимые решения. Tencent представила QClaw, ByteDance развивала ArkClaw, Alibaba — несколько агентных продуктов для облака, рабочего стола и корпоративного мессенджера DingTalk. Однако продукты часто дублировали друг друга: отличались точкой входа и аудиторией, но решали почти одинаковые офисные задачи. Сейчас компании начали объединять эти разрозненные инициативы. Alibaba объединила QoderWork, Wukong и MuleRun в новый продукт «Qianwen Office», которым руководит глава DingTalk Чэнь Юйсэнь. Tencent перевела связанные с QClaw команды в подразделение WorkBuddy. Параллельно крупнейшие ИИ-приложения, включая Doubao, Tongyi Qianwen и Yuanbao, стали закрывать публичные каталоги агентов и инструменты для создания пользовательских агентов. Такие изменения отражают общий сдвиг в отрасли: вместо множества экспериментальных продуктов компании хотят сосредоточить ресурсы вокруг нескольких стратегических платформ. ИИ-агент — это не только модель и удобное окно чата. Для его успеха нужны инженерная инфраструктура, интеграция с рабочими сервисами, каналы дистрибуции, продажи, поддержка и понятная бизнес-модель. Если эти элементы распределены между разными подразделениями, продуктам сложнее быстро развиваться и конкурировать за пользователей. Alibaba делает ставку на связку Qianwen Office, DingTalk и Alibaba Cloud. DingTalk уже используется более чем 26 млн корпоративных организаций, поэтому компания рассчитывает встроить ИИ прямо в повседневные процессы: подготовку отчётов, работу с данными, диаграммами, документами и внутренними системами. В таком подходе важна не только функциональность агента, но и эффект закрепления: если ИИ глубоко интегрирован в CRM, корпоративные процессы и рабочие документы, заменить его становится значительно труднее. ByteDance придерживается более сложной модели. Вместо полной организационной консолидации она сохраняет несколько агентных продуктов в разных подразделениях — Feishu, Volcano Engine, Coze и Trae. При этом компания пытается унифицировать базовые технологии и модели, а прикладные продукты оставляет разными по назначению: один служит дополнением к корпоративному мессенджеру, другой продаётся как SaaS, третий развивает экосистему, четвёртый борется за место на рабочем столе пользователя. Tencent, напротив, не стремится жёстко привязывать WorkBuddy к корпоративному WeChat. Сервис интегрируется не только с экосистемой Tencent, но и с DingTalk, Feishu, QQ и другими мессенджерами. Логика компании состоит в том, чтобы сделать агента самостоятельным рабочим входом с низким порогом использования, а не инструментом, запертым в одной корпоративной платформе. Однако ключевая проблема рынка остаётся прежней: готовы ли пользователи платить? У корпоративных платформ огромная клиентская база, но проникновение платных функций часто остаётся низким. Например, при десятках миллионов организаций в DingTalk число платящих клиентов измеряется сотнями тысяч. Малый и средний бизнес может использовать корпоративный мессенджер, но не всегда готов глубоко внедрять ИИ-агента в процессы и платить за него на постоянной основе. Наиболее перспективной зоной монетизации становится ИИ для программирования. Здесь пользователи готовы платить за реальную экономию времени и более высокую надёжность: анализ проектов из множества файлов, рефакторинг, запуск тестов, чтение логов ошибок и исправление кода. Но именно в этом сегменте китайские продукты сталкиваются с сильной конкуренцией зарубежных решений, прежде всего Claude Code. Даже при высокой стоимости API многие разработчики выбирают инструменты, которые, по их мнению, лучше справляются со сложными инженерными задачами. Авторы материала подчёркивают: проблема заключается не только в результатах бенчмарков моделей. Для профессиональной аудитории критична способность агента последовательно выполнять сложную задачу в реальном окружении — понимать контекст, пользоваться инструментами, запускать код, проверять результат и исправлять ошибки. Именно надёжность выполнения, а не просто качество ответа в чате, определяет готовность платить. Следующий этап конкуренции будет зависеть не от количества выпущенных ИИ-агентов, а от того, сможет ли конкретный продукт стать частью привычного рабочего процесса. Победит не тот, кто создаст больше «оболочек» вокруг модели, а тот, чьим агентом пользователю и компании будет действительно трудно перестать пользоваться.

16Апр

После того как Kimi прекратила принимать новые платные подписки, для многих пользователей главным вопросом стал доступ к свежей модели K3. Самый очевидный путь — API: модель можно вызывать через открытую платформу, подключать к сторонним средам разработки и агентам вроде Claude Code. Достаточно получить API-ключ, выполнить базовую настройку — и, кажется, K3 снова доступна без очередей в официальном приложении. Но на практике всё сложнее. API действительно даёт альтернативный вход к модели, однако «доступ к API» не равен гарантированной доступности сервиса. Запросы к K3 сначала завершались ошибкой engine_overloaded_error: инфраструктура была перегружена. После пополнения счёта и повышения уровня аккаунта минимальный запрос наконец вернул HTTP 200. Это показывает, что при дефиците вычислительных ресурсов доступ может зависеть не только от наличия ключа, но и от тарифа или приоритета аккаунта. Для проверки возможностей K3 авторы сравнили несколько сценариев: прямой вызов API, K3 внутри Claude Code, официальный клиент Kimi и Codex с собственной моделью GPT-5.6 Sol. Задача была практической: по скриншоту веб-страницы создать работающий одностраничный сайт с HTML, CSS и JavaScript, сохранив характерный стиль исходника. Прямой API-вызов оказался самым коротким путём. Модель получила изображение и инструкцию, а в ответ выдала готовый код страницы. Такой подход почти не показывает ход работы: во время обработки пользователь видит лишь ожидание. Зато результат появился быстро, а K3 достаточно точно передала основные черты референса — белый фон, строгую типографику, «музейную» композицию и горизонтальную структуру контента. Для разовых задач формата «скриншот → готовый HTML» прямой API может быть эффективнее полноценного агента. Claude Code добавил другой уровень возможностей. Подключённая к нему K3 могла анализировать файлы, обращаться к терминалу, создавать структуру проекта, запускать локальный сервер и дорабатывать результат в несколько этапов. Однако агентная оболочка также расширила число возможных ошибок. В первой попытке модель сгенерировала большой объём кода, но не сохранила его в файл. Лишь после отдельного требования проверить фактически созданные файлы агент обнаружил проблему, записал страницу на диск и запустил предпросмотр. Это типичный риск агентных систем: модели недостаточно написать правильный код. Ей также нужно выбрать инструмент, корректно вызвать его, дождаться результата, понять обратную связь и проверить, что работа действительно завершена. Взамен пользователь получает важное преимущество — возможность вести итеративную работу: показать агенту новый скриншот, попросить сравнить результат с референсом, исправить стили, добавить элементы или изменить существующие файлы. Тест подчёркивает более общий вывод: одинаковое название модели ещё не означает одинаковый пользовательский опыт. Один и тот же K3 ведёт себя по-разному в разных средах. При прямом API-вызове он решает задачу одним цельным ответом. В Claude Code он работает как участник многоэтапного процесса: анализирует, планирует, пишет, запускает, проверяет и исправляет. На каждом этапе возникают как новые возможности, так и риск отклониться от исходного замысла — например, в тесте версия через Claude Code получила неожиданный тёплый оттенок фона вместо почти чистого белого. Именно здесь становится важным понятие harness — среды, которая организует работу модели. Это не просто чат-интерфейс. Хорошая агентная оболочка определяет, какие инструменты доступны модели, как она разбивает задачу на шаги, где хранит состояние, как работает с файлами, когда проводит проверку и что делает при сбое. Она может подключать корпоративные данные, права доступа, дизайн-системы, внутренние процессы и правила бренда. Поэтому сторонние оболочки вокруг моделей нельзя автоматически сводить к пренебрежительному слову «обёртка». Да, если приложение лишь пересылает текст в API и показывает ответ, его легко заменить функцией официального клиента. Но полноценный harness создаёт дополнительную ценность: он превращает языковую модель в инструмент, способный действовать в реальной рабочей среде. Пользоваться K3 после остановки новых подписок через API по-прежнему возможно. Для технически подготовленных пользователей это означает больше свободы: можно подключать модель к локальным инструментам, редакторам и агентам. Однако вместе со свободой приходят ответственность за ключи, среду выполнения, совместимость протоколов, стабильность сервиса и контроль результата. Для тех, кому не хочется разбираться с переменными окружения, скриптами и локальными серверами, официальный клиент остаётся наиболее простым вариантом, когда доступ к нему доступен. А для разработчиков и команд API плюс агентная среда могут стать более гибким, хотя и более требовательным способом работать с K3.

16Апр

Рынок ИИ-питомцев быстро набирает популярность. Компании Nubia, Huawei, Robopoet, Ropet и Fuzozo выпускают роботов-компаньонов, которые реагируют на голос, прикосновения и привычки владельца. Новинка Nubia iMoochi, например, умеет распознавать хозяина по голосу, выражать разные «эмоции» и отвечать на поглаживания с помощью встроенных сенсоров. Главное преимущество таких устройств — отсутствие ответственности, неизбежной при содержании настоящего животного. ИИ-питомца не нужно кормить, выгуливать, лечить или оставлять с кем-то на время отпуска. Он не болеет, не умирает и не создаёт бытовых проблем. Для людей, живущих в съёмных квартирах, много работающих или часто путешествующих, это становится удобной альтернативой живой кошке или собаке. Популярность категории связана и с ростом потребности в эмоциональной поддержке. Одиноким жителям мегаполисов важно ощущать присутствие рядом кого-то, кто встречает дома, реагирует на слова и создаёт атмосферу заботы. ИИ-питомец предлагает именно такую форму общения — лёгкую, постоянную и полностью контролируемую пользователем. Однако у рынка есть серьёзная проблема: после первоначального интереса многие устройства рискуют стать дорогими игрушками, которые просто стоят на столе. Если питомец повторяет одни и те же реакции и не развивается вместе с владельцем, эмоциональная связь быстро ослабевает. Простого подключения языковой модели недостаточно: пользователю нужен не милый голосовой ассистент в корпусе животного, а ощущение живого, запоминающегося взаимодействия. Перспективным примером считается японский робот LOVOT. Его создатели сделали упор не на разговоры, а на физическое присутствие: распознавание лиц, реакцию на прикосновения, движение, взгляд и запоминание привычной обстановки. Такой подход позволяет роботу восприниматься скорее как компаньон, чем как техническое устройство. Вероятно, ИИ-питомцы не заменят настоящих животных. Но они могут занять свою нишу — в офисах, арендованных квартирах, поездках и повседневной жизни людей, которым нужна эмоциональная поддержка без дополнительных обязательств. Их успех будет зависеть от того, смогут ли производители превратить эффект новизны в долгосрочное чувство привязанности.

16Апр

24 июля Дженсен Хуанг впервые опубликовал пост в X. Для руководителя NVIDIA, который прежде почти не использовал социальные сети как публичную площадку, это стало заметным жестом. Вместо личного сообщения или рекламы новых GPU он разместил открытое письмо под названием «Открытые веса и лидерство США в ИИ», подписанное 25 компаниями. Среди подписантов — NVIDIA, Microsoft, Meta (запрещённая в России), IBM, Dell, Palantir, Hugging Face, Andreessen Horowitz, Y Combinator, Mozilla, Mistral, Perplexity и Replit. При этом в списке отсутствуют OpenAI, Anthropic и Google — крупнейшие представители закрытой модели развития ИИ. Главный тезис письма звучит просто: миру нужны как передовые закрытые модели, так и передовые модели с открытыми весами. Однако за этой формулой стоит гораздо более серьёзный конфликт — о том, кто будет контролировать будущую ИИ-инфраструктуру, какие модели смогут использовать разработчики и каким станет глобальный рынок искусственного интеллекта. Поводом для нового витка споров стал выход Kimi K3 — открытой модели китайской компании Moonshot AI. Модель сочетает три фактора, которые особенно тревожат американских конкурентов: высокую производительность, более низкую стоимость API и планы по публикации весов модели. На этом фоне в США усилились политические и отраслевые разговоры об ограничении использования китайских открытых моделей. Упоминаются публичные обвинения в возможной дистилляции американских моделей, обсуждения санкционных мер и даже сценарии запрета американским компаниям использовать китайские open-weight решения. Важно различать технологическую дистилляцию и возможное нарушение интеллектуальной собственности. Дистилляция — распространённый метод обучения и улучшения моделей, при котором одна система используется для получения сигналов или примеров для другой. Но незаконное извлечение ценности из закрытого продукта — отдельный юридический вопрос. Именно на этом разграничении настаивает открытое письмо: потенциальные нарушения следует рассматривать адресно, через право и коммерческие механизмы, а не превращать их в аргумент против открытых моделей как класса. Открытые веса — не только идеология, но и экономика Спор об open source в ИИ часто выглядит как идеологический: открытость против контроля, сообщество против корпораций. Но на практике он всё больше определяется экономикой. Закрытые передовые модели требуют огромных инвестиций в вычислительные мощности, обучение, безопасность и обслуживание инфраструктуры. Поэтому их поставщики стремятся монетизировать доступ через дорогие API, подписки и корпоративные контракты. Для крупных компаний такая модель может быть приемлемой, но для стартапов, университетов, промышленных предприятий, медицинских организаций и небольших разработчиков она нередко оказывается слишком дорогой или ограничивающей. Открытые модели предлагают альтернативу. Их можно развернуть в собственной инфраструктуре, дообучить под конкретную задачу, адаптировать к внутренним данным и не зависеть полностью от ценовой политики одного поставщика. Для многих организаций это означает не только экономию, но и контроль над критически важными системами. Именно поэтому запрет на использование иностранных открытых моделей может ударить не столько по их создателям, сколько по американским стартапам и разработчикам, которым нужны доступные и гибкие технологические основы. Если на рынке останутся лишь несколько дорогих закрытых поставщиков, тысячи компаний окажутся в более зависимом положении. Парадокс закрытого ИИ Чем сильнее, дороже и более монополизированными становятся закрытые модели, тем выше спрос на открытые альтернативы. Если закрытая система обладает лучшими показателями, но её использование обходится дорого, компании начинают сравнивать не абсолютное качество, а соотношение цены и результата. Модель, которая выдаёт 90% нужного качества за треть стоимости, может оказаться выгоднее для многих прикладных сценариев. Кроме того, закрытые модели часто имеют жёсткие ограничения безопасности. В некоторых случаях такие ограничения могут мешать даже законным защитным задачам — например, анализу инцидента, исследованию уязвимостей или восстановлению после атаки. Открытая модель даёт пользователю больше контроля над тем, как именно она настроена и применяется, хотя одновременно требует от него большей ответственности за безопасность. Таким образом, стремление закрытых лабораторий к максимальной технологической и коммерческой концентрации само усиливает мотивацию рынка искать независимые варианты. Почему NVIDIA особенно заинтересована в открытой экосистеме На первый взгляд участие NVIDIA в защите открытых моделей может показаться необычным: компания зарабатывает прежде всего на поставках вычислительного оборудования. Но именно поэтому ей выгодна широкая и разнообразная ИИ-экосистема. NVIDIA выигрывает, когда модели создают, обучают, адаптируют и запускают тысячи компаний, лабораторий и независимых разработчиков. Чем больше ИИ-проектов существует в мире, тем выше спрос на GPU, серверы, сети, программные платформы и облачную инфраструктуру. Закрытая модель развития концентрирует влияние в руках нескольких крупнейших лабораторий. Открытая — расширяет число участников рынка и увеличивает количество сценариев применения вычислительных мощностей. Для NVIDIA это не благотворительность, а защита долгосрочной структуры рынка, в которой ИИ становится инфраструктурой для множества игроков, а не услугой нескольких монополий. Не случайно Хуанг фактически противопоставляет лидерство одной лучшей модели лидерству целой экосистемы. Отдельная модель может быстро потерять первенство, но экосистема разработчиков, инструментов, стандартов, библиотек и оборудования создаёт гораздо более устойчивое преимущество. Хороший исторический пример — Linux: когда-то открытое программное обеспечение считалось рискованной альтернативой, а сегодня оно лежит в основе значительной части мировой цифровой инфраструктуры. Открытость не отменяет ограничений При этом защита открытых моделей не означает, что open source автоматически решает все проблемы. Публикация весов не заменяет доступ к чипам, электричеству, дата-центрам и капиталу. Модель может быть открытой, но дорогостоящей в запуске. Низкая цена токена также не всегда означает низкую цену готовой работы: если для выполнения задачи требуется больше запросов, проверок и времени, экономическое преимущество может исчезнуть. Есть и вопросы безопасности, соблюдения лицензий, защиты данных и ответственности за применение модели. Поэтому зрелая экосистема ИИ требует не только свободы распространения технологий, но и понятных правил их использования. Главный смысл заявления Первый пост Дженсена Хуанга в X — это не просто поддержка open source. Это сигнал о развилке, на которой оказался мировой ИИ-рынок. Один путь ведёт к более закрытой системе, где доступ к наиболее важным моделям, ценам и правилам использования контролируют несколько крупных лабораторий. Другой — к более открытому рынку, на котором модели, инфраструктура и приложения развиваются через широкую конкуренцию, локальную адаптацию и участие разработчиков по всему миру. Для NVIDIA и других подписантов открытого письма второй вариант означает не только технологическое разнообразие, но и расширение рынка. Для стартапов и предприятий — возможность выбирать. А для государств — шанс строить собственную ИИ-инфраструктуру, не полностью завися от нескольких внешних поставщиков. Именно поэтому спор об открытых весах сегодня — это не спор о лицензиях. Это спор о том, кому будет принадлежать будущее искусственного интеллекта.
Если у вас есть инновационная идея, мы будем рады реализовать ее для Вас!

Специалисты нашей кампании и наши разработки для вас!