Новости

Социальные сети

Узнайте больше о рынке It и новейших технологиях.
СТАТЬИ
16Апр

Использование искусственного интеллекта в разработке программного обеспечения перестает быть экспериментом и становится частью повседневной инженерной практики. Одним из наиболее показательных примеров такой трансформации стала компания Spotify, где, по словам вице-президента по инженерии Никласа Густавссона, около 73% pull request (PR) уже создаются с помощью ИИ, а частота внесения изменений в код выросла более чем на 75%. Об этом Густавссон рассказал в беседе с Борисом Черны, одним из создателей Claude Code. По словам Черны, еще осенью прошлого года ему казалось невероятным предположение, что разработчики вскоре смогут отказаться от традиционных IDE в пользу ИИ-инструментов. Однако уже спустя несколько месяцев он сам практически перестал использовать классическую среду разработки, полностью изменив свой рабочий процесс. Сегодня инженеры Spotify одновременно работают сразу с несколькими ИИ-агентами. Вместо того чтобы самостоятельно писать каждую строку кода, разработчики формулируют задачи, а модели выполняют большую часть реализации, после чего автоматически запускаются проверки, тесты и процесс доставки изменений в продуктивную среду. При этом в компании подчеркивают, что успех обеспечили не только современные языковые модели. За последние годы Spotify последовательно инвестировала в стандартизацию кодовой базы, автоматизированное тестирование, непрерывную интеграцию (CI), управление зависимостями и внутренние инструменты разработки. Именно эта инфраструктура позволила эффективно интегрировать ИИ в существующие процессы. Одним из ключевых внутренних решений стала платформа Honk — система автоматизации разработки, которая первоначально создавалась для массового обновления тысяч репозиториев компании. Со временем она эволюционировала в универсального ИИ-помощника, способного выполнять широкий спектр инженерных задач. Сегодня Honk использует Claude Agent SDK и интегрирован с внутренними инструментами Spotify, включая системы сборки и тестирования. Особое внимание в компании уделяют автоматической валидации изменений. Если раньше каждое изменение обязательно проверяла ответственная команда, то теперь большинство автоматически созданных PR объединяются без непосредственного участия разработчиков. Это стало возможным благодаря значительно более строгим требованиям к автоматическим тестам и проверкам качества. По словам Густавссона, Spotify ежедневно выполняет около 4500 развертываний в производственную среду. Высокая скорость разработки стала возможной именно благодаря автоматизации контроля качества, а не за счет снижения требований к надежности. Еще одной важной тенденцией стало расширение круга людей, способных создавать программные решения. В компании активно развивают инструменты для быстрого прототипирования, которыми пользуются не только инженеры, но и дизайнеры, менеджеры продуктов и даже руководители. Любой сотрудник может описать свою идею естественным языком, получить рабочий прототип и опубликовать его во внутреннем каталоге приложений для дальнейшего тестирования. В Spotify считают, что подобный подход позволяет проверять новые идеи не за недели или месяцы, как раньше, а всего за несколько часов. При этом инженеры постепенно переходят от непосредственного написания кода к решению более сложных задач — проектированию систем, постановке целей для ИИ и оценке результатов его работы. Вместе с тем руководство компании отмечает, что массовое внедрение ИИ требует новых подходов к оценке эффективности. Если на первых этапах главным показателем был рост производительности, то теперь Spotify стремится связать использование ИИ с бизнес-результатами: влиянием на пользовательский опыт, скоростью вывода новых функций и экономической эффективностью. Опыт Spotify показывает, что искусственный интеллект становится не просто инструментом для генерации кода, а основой новой модели разработки программного обеспечения. Однако ключевым фактором успеха остается не сама модель ИИ, а зрелость инженерной инфраструктуры, которая позволяет безопасно интегрировать интеллектуальных агентов в процесс создания продуктов.

16Апр

Исследователь Anthropic Андрей Карпати считает, что современная индустрия искусственного интеллекта слишком увлеклась разработкой ИИ-агентов, не уделяя достаточного внимания развитию самих базовых языковых моделей. Об этом он заявил во время выступления перед разработчиками агентных систем, где его слова вызвали активное обсуждение в профессиональном сообществе. По мнению Карпати, одна из главных ошибок сегодняшнего этапа развития ИИ заключается в стремлении как можно быстрее заставить агентов выполнять сложные задачи, тогда как фундаментальные возможности больших языковых моделей еще продолжают активно развиваться. Именно качество базовой модели, считает он, в конечном итоге определяет возможности любых надстроек. В качестве примера Карпати вспомнил собственный опыт работы в OpenAI в середине 2010-х годов. Тогда команда занималась проектом World of Bits — платформой, на которой ИИ должен был самостоятельно пользоваться веб-сайтами, управляя клавиатурой и мышью для выполнения повседневных задач, например покупки авиабилетов или оформления заказов. Несмотря на публикацию научной статьи, проект не стал успешным. По словам исследователя, в то время технологии просто не были готовы к реализации подобных идей: основным инструментом оставалось обучение с подкреплением, возможностей которого оказалось недостаточно. Оглядываясь назад, Карпати считает, что более правильным решением было сосредоточиться на развитии языковых моделей, а не пытаться преждевременно создавать сложных агентов. Спустя несколько лет именно прогресс в области больших языковых моделей открыл путь к современным агентным системам. Исходя из этого опыта, исследователь сформулировал несколько рекомендаций для разработчиков. Во-первых, он советует не стремиться сразу создавать универсальных агентов, а уделять первоочередное внимание совершенствованию фундаментальных моделей. Во-вторых, Карпати напоминает, что эффектные демонстрации не следует путать с готовыми продуктами. Он сравнил нынешнюю ситуацию с историей беспилотных автомобилей и виртуальной реальности: впечатляющие демонстрации появились задолго до того, как технологии стали пригодны для массового использования, а путь от прототипа до коммерческого продукта занял около десяти лет. Еще одной темой выступления стало устройство интеллектуальных систем. Карпати предложил разработчикам внимательнее изучать достижения нейронауки, рассматривая человеческий мозг как источник идей для архитектуры будущих ИИ-агентов. По его мнению, вопросы памяти, выбора действий и координации процессов внутри агентных систем могут получить новые решения благодаря аналогиям с работой различных областей мозга. Вместе с тем Карпати отметил, что именно область ИИ-агентов сегодня остается одной из наиболее открытых для инноваций. Если в разработке больших языковых моделей крупнейшие компании уже накопили многолетний опыт и обладают значительным преимуществом, то направление агентных систем пока находится на раннем этапе развития. Поэтому независимые исследователи, стартапы и небольшие команды имеют реальные шансы предложить новые подходы и оказаться в числе лидеров. Таким образом, основная мысль выступления заключается не в критике самих ИИ-агентов, а в призыве соблюдать последовательность развития технологий. По мнению Карпати, долгосрочный успех в этой области будет зависеть не столько от количества новых демонстраций, сколько от качества фундаментальных моделей, на которых строятся будущие интеллектуальные системы.

16Апр

По данным Financial Times, OpenAI начала предварительные переговоры с правительством США о возможной передаче государству 5% акций компании. При текущей оценке OpenAI примерно в 852 млрд долларов стоимость такого пакета превышает 42 млрд долларов. Пока речь идет лишь о концептуальном обсуждении, однако сама инициатива может существенно повлиять на будущее всей индустрии искусственного интеллекта. Идея, которую продвигает генеральный директор OpenAI Сэм Альтман, заключается в том, чтобы сделать американское общество непосредственным участником экономического роста, связанного с развитием ИИ. В качестве модели предлагается использовать аналог Фонда постоянного дохода Аляски (Alaska Permanent Fund), который инвестирует доходы от добычи нефти и распределяет часть прибыли среди жителей штата. По замыслу Альтмана, аналогичный фонд мог бы владеть долями ведущих ИИ-компаний и приносить доход государству и гражданам. Более того, Альтман предлагает распространить эту схему не только на OpenAI. Он считает, что аналогичные пакеты акций могли бы передать государству и другие крупные американские разработчики искусственного интеллекта, включая Anthropic, Google и Meta. Однако пока нет свидетельств того, что эти компании готовы поддержать подобную инициативу. Предложение OpenAI появляется на фоне усиливающегося внимания американских властей к развитию передовых моделей искусственного интеллекта. В последние месяцы вопросы безопасности, строительства крупных дата-центров, влияния ИИ на рынок труда и экспортного контроля становятся предметом все более активного обсуждения. В этих условиях участие государства в капитале компаний может рассматриваться как способ укрепить сотрудничество между отраслью и регуляторами. Интересно, что идея общественного владения ИИ-компаниями обсуждается в США и в более радикальной форме. Так, сенатор Берни Сандерс, по сообщениям СМИ, выступает за создание суверенного фонда, который мог бы владеть значительно большей долей компаний сектора — вплоть до половины их капитала. Если предложение OpenAI предполагает лишь ограниченное участие государства без изменения корпоративного контроля, то такой подход означал бы гораздо более серьезное влияние общества на управление отраслью. Сама OpenAI ранее уже заявляла о необходимости поиска новых механизмов, которые позволили бы широким слоям населения получать выгоду от развития искусственного интеллекта. Весной компания предлагала создать общественный фонд благосостояния, а ее благотворительное подразделение отмечало, что гражданам следует предоставить не только экономические преимущества, но и возможность участвовать в обсуждении решений, определяющих развитие технологий. Эксперты отмечают, что инициатива может иметь и стратегическое значение. OpenAI и другие разработчики передовых моделей готовятся к выходу на биржу, а одновременно сталкиваются с растущим государственным контролем над разработкой наиболее мощных систем искусственного интеллекта. Возможное участие государства в капитале компании способно снизить политические риски и сделать отношения с регуляторами более предсказуемыми. На сегодняшний день предложение остается лишь предметом предварительных переговоров, а его реализация, вероятно, потребовала бы одобрения Конгресса США. Тем не менее сама дискуссия свидетельствует о важном изменении: если раньше главным вопросом было, как регулировать искусственный интеллект, то теперь все чаще обсуждается, должно ли государство стать одним из его совладельцев. Именно от ответа на этот вопрос во многом будет зависеть дальнейшая модель развития индустрии ИИ в Соединенных Штатах.

16Апр

Компания Anthropic раскрыла детали своей новой системы защиты моделей Fable 5, а также представила Cyber Jailbreak Severity (CJS) — методику оценки опасности успешных обходов защитных механизмов ИИ. Фактически речь идет о попытке создать единый стандарт, который позволит определять, насколько серьезной является та или иная уязвимость модели и какие меры следует принимать. Одновременно компания подробно описала логику работы классификаторов безопасности, которые анализируют запросы пользователей. Все запросы, связанные с кибербезопасностью, делятся на четыре категории: от заведомо вредоносных (например, создание программ-вымогателей или инструментов для кражи данных), которые блокируются безусловно, до полностью безопасных задач вроде анализа журналов, отладки кода и написания безопасного программного обеспечения. Между ними находятся две категории «двойного назначения», включающие пентест, поиск уязвимостей и исследовательские задачи. Именно здесь, по признанию Anthropic, чаще всего возникают ложные срабатывания: безопасные запросы могут ошибочно восприниматься как потенциально опасные. Новая система CJS оценивает не сам факт обхода защиты, а его практическую опасность. При расчете учитываются четыре параметра: насколько обход увеличивает возможности злоумышленника, насколько широк круг потенциальных атак, насколько легко превратить полученные результаты в реальный инструмент атаки и насколько доступна сама техника обхода. По суммарному баллу инцидент получает рейтинг от CJS-0 до CJS-4 — от практически безвредного случая до критической угрозы, требующей самых жестких мер. Особенность подхода заключается в том, что оценка зависит от контекста. Один и тот же сценарий может считаться крайне опасным в момент обнаружения новой критической уязвимости, но спустя несколько лет, когда информация уже широко известна, получить минимальный рейтинг. Таким образом, система оценивает не абсолютную опасность, а дополнительный риск, который создает конкретный обход защиты в конкретный момент времени. Появление CJS связано не только с техническими вопросами безопасности, но и с усилением государственного контроля над передовыми ИИ-моделями. В частности, ограничения США, которые впервые распространились не только на аппаратное обеспечение и веса моделей, но и на доступ к API. На этом фоне CJS может стать инструментом, который позволит формализовать решения о введении дополнительных ограничений или даже временном отключении доступа к отдельным моделям. Для пользователей это означает, что взаимодействие с современными ИИ становится более чувствительным к формулировкам запросов. Даже легитимные задачи в области информационной безопасности могут попадать под действие защитных механизмов, а разработчикам и исследователям, вероятно, придется тщательнее формулировать запросы, чтобы избежать ошибочных блокировок. В Anthropic заявляют, что планируют совершенствовать систему, однако сроки снижения количества ложных срабатываний пока не называются.

16Апр

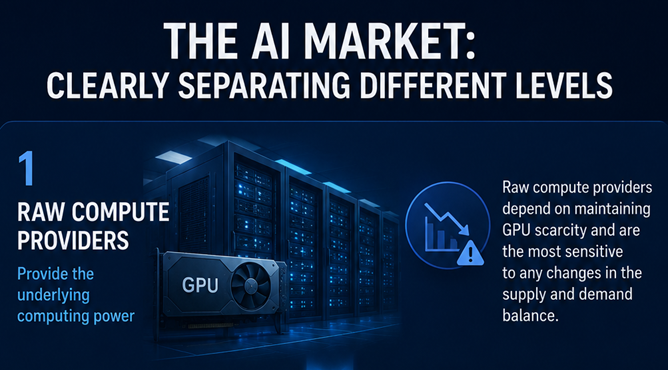
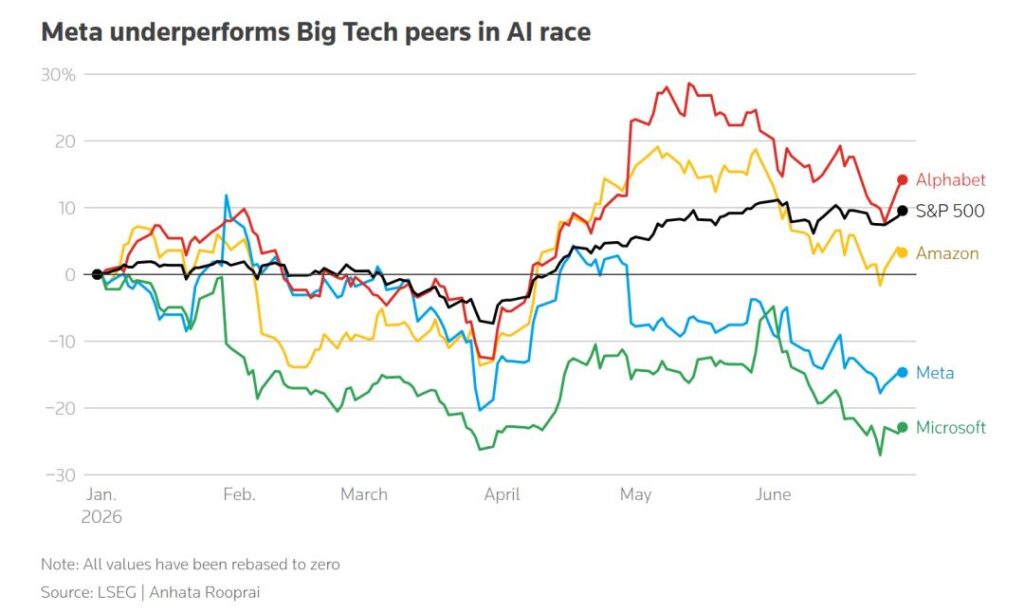
2 июля мировые фондовые рынки пережили резкое падение акций производителей полупроводников и компаний, связанных с искусственным интеллектом. Поводом стали сообщения о том, что Meta рассматривает возможность сдачи в аренду собственных вычислительных мощностей. Казалось бы, одна новость — но реакция инвесторов оказалась весьма показательной. Она продемонстрировала, что рынок сегодня по-разному оценивает три принципиально разные модели бизнеса вокруг вычислительных ресурсов для ИИ — от аренды GPU до облачных платформ и готовых AI-сервисов. Каждый запрос к современным нейросетям — будь то ChatGPT, DeepSeek, Qwen или другие модели — требует работы мощных графических процессоров (GPU), установленных в дата-центрах. Пользователь видит лишь окно чата, однако за каждым ответом стоит дорогостоящая вычислительная инфраструктура, потребляющая электроэнергию и ресурсы серверов. Еще недавно эти расходы полностью брали на себя технологические гиганты. Сегодня ситуация меняется: все больше сервисов вводят собственные системы оплаты — баллы, кредиты, токены или условные единицы. При этом единых стандартов пока не существует: каждый разработчик использует собственную модель тарификации, зачастую несовместимую с конкурентами. Масштаб рынка стремительно растет. По данным Государственного управления данных Китая, среднесуточный объем обработки токенов уже превысил триллион — более чем в тысячу раз больше, чем в начале 2024 года. Самая простая бизнес-модель — покупать графические процессоры, размещать их в дата-центрах и сдавать вычислительные мощности в аренду. Доход напрямую зависит от загрузки оборудования. Однако именно этот сегмент считается наиболее рискованным. Характерный пример — китайская компания Hongbo, которая более двадцати лет занималась печатью лотерейных билетов. После нескольких неудачных попыток выйти на новые рынки сделала ставку на ИИ-инфраструктуру, закупила оборудование NVIDIA и начала сдавать вычислительные мощности в аренду. Финансовые результаты оказались неоднозначными: выручка выросла более чем вдвое; направление аренды вычислительных ресурсов впервые принесло больше доходов, чем традиционный бизнес; при этом компания продолжает работать с убытками уже четвертый год подряд. Основная проблема — высокая стоимость инфраструктуры. Покупка GPU требует огромных инвестиций, а обслуживание дата-центров сопровождается большими расходами на электроэнергию, амортизацию и обслуживание оборудования. По оценкам отраслевых специалистов, дата-центр начинает приносить прибыль лишь при загрузке около 70%. Если загрузка опускается до 40%, бизнес становится убыточным. По данным бывшего руководителя технологического комитета China Telecom Вэй Лэпина, средняя загрузка китайских центров ИИ-вычислений сегодня не превышает 30%. Похожая ситуация наблюдается и в США. Компания CoreWeave считается одним из крупнейших поставщиков вычислительных мощностей для искусственного интеллекта. Несмотря на впечатляющий рост бизнеса: годовая выручка превысила 5 млрд долларов; портфель заказов приблизился к 100 млрд долларов, компания продолжает нести крупные убытки из-за огромной долговой нагрузки и расходов на развитие инфраструктуры. Аналогичная ситуация складывается у Nebius, которая также демонстрирует стремительный рост доходов, но пока остается убыточной. Главная причина проста: прибыль практически полностью поглощается процентами по кредитам и амортизацией дорогостоящего оборудования. Поэтому стоимость подобных компаний напрямую зависит от одного фактора — сохраняющегося дефицита вычислительных мощностей. Именно поэтому новость о том, что Meta (запрещённая в России) может вывести на рынок часть собственной инфраструктуры, привела к резкому падению акций CoreWeave и других поставщиков GPU. Совсем иначе работает облачный бизнес крупнейших технологических корпораций. Amazon Web Services (AWS), Microsoft Azure и Google Cloud продают клиентам не просто вычислительные мощности, а готовую экосистему: виртуальные серверы; базы данных; инструменты разработки; системы безопасности; доступ к ИИ-моделям; сервисы управления инфраструктурой. В этом случае GPU становятся лишь одним из элементов большого продукта. Именно поэтому финансовые показатели облачных подразделений значительно лучше. По последним данным: операционная маржа AWS составляет около 35%; Microsoft Intelligent Cloud — около 43%; Google Cloud — почти 24%. Для сравнения: у компаний, специализирующихся исключительно на аренде вычислительных мощностей, этот показатель может находиться около 1%. Именно поэтому рынок положительно воспринял новость о возможном выходе Meta в облачный бизнес. Пока акции поставщиков GPU падали, бумаги Amazon, Microsoft и Alphabet, напротив, выросли. Инвесторы исходят из того, что снижение стоимости вычислительных ресурсов делает облачные сервисы более прибыльными. Сама Meta сегодня находится в непростой ситуации. Компания инвестирует десятки миллиардов долларов в создание собственной ИИ-инфраструктуры, одновременно заключая масштабные контракты на аренду вычислительных мощностей у CoreWeave и Nebius. При этом около 98% доходов Meta по-прежнему обеспечивает реклама. Собственного масштабного облачного бизнеса у компании нет, а коммерческий успех ее моделей искусственного интеллекта пока остается ограниченным. Поэтому продажа свободных вычислительных мощностей рассматривается как способ превратить дорогостоящие дата-центры из центра затрат в источник выручки. Однако сделать это значительно сложнее, чем просто сдавать GPU в аренду. Необходимо создать полноценную облачную платформу, систему поддержки клиентов, инструменты разработки и сформировать конкурентную ценовую политику — то есть построить бизнес, аналогичный AWS или Azure. Наиболее сложной считается третья модель. В этом случае пользователь вообще не задумывается о вычислительных мощностях — он просто использует готовый ИИ-сервис. Именно здесь возникает главная экономическая проблема современной индустрии. Если классические интернет-сервисы имеют почти нулевые дополнительные расходы на каждого нового пользователя, то генеративный искусственный интеллект работает иначе. Каждый новый запрос означает реальные затраты на вычисления. Чем активнее люди пользуются сервисом, тем выше расходы компании. Поэтому многие разработчики сталкиваются с неожиданной ситуацией: рост аудитории автоматически увеличивает себестоимость продукта. Весной 2026 года Anthropic ограничила использование своего API через ряд сторонних сервисов после того, как выяснилось, что отдельные пользователи, оплачивая подписку в 200 долларов, потребляли вычислительные ресурсы на тысячи долларов в месяц. Дополнительной проблемой становится неэффективное использование токенов. По мере увеличения контекста диалога ИИ вынужден обрабатывать все большие объёмы информации, из-за чего стоимость одной сессии может многократно возрастать. Даже успешные AI-продукты пока сталкиваются с высокой себестоимостью. Например, сервис Cursor, ставший одним из самых популярных инструментов для программирования с использованием искусственного интеллекта, демонстрирует стремительный рост выручки, но пока остается убыточным. По оценкам аналитиков, валовая маржа большинства AI-приложений находится в диапазоне 25–60%, тогда как традиционные разработчики программного обеспечения зачастую работают с показателями около 77%. Последние события показали, что инвесторы уже четко разделяют различные уровни рынка искусственного интеллекта. Поставщики «сырой» вычислительной мощности зависят от сохранения дефицита GPU и наиболее чувствительны к любым изменениям баланса спроса и предложения. Облачные платформы зарабатывают на комплексных сервисах, поэтому снижение стоимости вычислений зачастую играет им на руку. Разработчики конечных AI-приложений получают максимальную ценность для пользователя, но одновременно несут самые высокие переменные расходы, поскольку каждая новая функция и каждый дополнительный запрос требуют новых вычислений. Именно поэтому новость о потенциальной продаже Meta свободных вычислительных мощностей вызвала столь разную реакцию рынка. Для поставщиков инфраструктуры она стала угрозой усиления конкуренции, для облачных операторов — возможностью снизить издержки, а для

16Апр

Руководитель команды десктопного приложения Codex Эндрю Амброзино (Andrew Ambrosino) рассказал о причинах стремительного роста продукта, его объединении с ChatGPT и том, как, по мнению OpenAI, меняется разработка программного обеспечения в эпоху искусственного интеллекта. По словам Амброзино, Codex стал одним из самых быстрорастущих ИИ-продуктов 2026 года. С января число еженедельных активных пользователей увеличилось более чем в пять раз и достигло 5 миллионов. При этом сервис активно осваивают не только программисты: сотрудники интеллектуальных профессий, не связанных с разработкой, начинают использовать Codex даже быстрее, чем сами разработчики. Одним из ключевых факторов роста стал запуск настольного приложения в феврале, сделавшего работу с сервисом значительно проще. Амброзино считает, что развитие генеративного ИИ кардинально меняет процесс создания программных продуктов. Если раньше самым дорогим этапом была реализация идеи, то теперь написание кода стало относительно дешевой задачей благодаря современным моделям. Главной ценностью становятся способность выбирать лучшие решения, системное мышление и качественный дизайн продукта — то, что он называет «вкусом» (taste). По его мнению, именно дизайн остается одной из самых сложных областей для искусственного интеллекта. В отличие от программного кода, качество дизайна трудно оценить объективными критериями, а хорошие дизайнерские решения во многом зависят от культурного контекста и способности создавать новые идеи, а не копировать существующие образцы. Амброзино также отметил, что успех ИИ-продукта сегодня во многом определяется не интерфейсом, а возможностями самой модели. Он уверен, что если бы Codex выпустили несколькими месяцами раньше, продукт не смог бы добиться успеха, поскольку уровень развития моделей тогда еще не позволял реализовать задуманный пользовательский опыт. Отдельная часть интервью была посвящена изменениям внутри команд разработки. Хотя границы между инженерами, дизайнерами и менеджерами становятся менее жесткими, Амброзино не считает, что профессиональные роли полностью исчезнут. По его словам, специалисты все чаще работают на стыке нескольких дисциплин, однако глубокая экспертиза в каждой области по-прежнему остается важной. Говоря о будущем программирования, руководитель Codex отметил, что сегодня уже не так важно, какой процент кода написал человек, а какой — искусственный интеллект. Гораздо важнее, насколько автономно модель выполняет работу и насколько эффективно человек управляет этим процессом. При этом одной из главных нерешенных задач он назвал склонность современных моделей постепенно усложнять код вместо его упрощения. Одной из центральных тем интервью стало объединение Codex с ChatGPT. Первоначально Codex создавался как инструмент исключительно для разработчиков, однако во время внутреннего тестирования оказалось, что им активно пользуются сотрудники самых разных подразделений — от маркетинга и юридических служб до финансовых отделов. Попытки перенести функциональность Codex в другие приложения не дали ожидаемого результата: пользователи предпочитали работать именно в Codex. В результате OpenAI пришла к выводу, что граница между специализированным инструментом для программистов и универсальным помощником для интеллектуальной работы постепенно исчезает. Вместо отдельных приложений компания стремится создать единое рабочее пространство — своего рода «домашнюю базу» (home base), из которой пользователь сможет запускать любые задачи. Амброзино подчеркнул, что такая система не должна заменять профессиональные программы. Напротив, она должна уметь взаимодействовать с уже существующими инструментами — например, Microsoft Excel, Adobe Premiere Pro и другими специализированными приложениями — автоматически используя их возможности через плагины, расширения и механизмы управления компьютером. По мнению OpenAI, именно такой подход позволит превратить ChatGPT и Codex в универсальную платформу, объединяющую возможности ИИ с привычными профессиональными инструментами, а не конкурирующую с ними.

16Апр

Генеральный директор Meta (запрещённая в России) Марк Цукерберг впервые публично в рамках внутреннего собрания сотрудников признал, что развитие направления ИИ-агентов идет значительно медленнее, чем рассчитывало руководство компании. По данным Reuters, ссылающегося на запись встречи, глава Meta заявил, что масштабная организационная перестройка и многомиллиардные инвестиции в искусственный интеллект пока не принесли ожидаемого ускорения разработки. На этом фоне компания не только продолжает вкладывать рекордные суммы в ИИ-инфраструктуру, но и рассматривает возможность превратить собственные вычислительные мощности в новый источник дохода, предлагая их внешним клиентам. Во время внутреннего собрания 2 июля Цукерберг подвел промежуточные итоги масштабной реформы, начавшейся в начале года. По его словам, еще в январе и феврале руководство Meta пришло к выводу, что компания слишком медленно адаптируется к стремительно меняющемуся рынку искусственного интеллекта. Особое впечатление на менеджмент тогда произвели новые инструменты программирования на базе ИИ, включая Claude Code от Anthropic, что подтолкнуло Meta к ускоренной реорганизации. В мае компания сократила около 8 тысяч сотрудников — примерно 10% мирового штата — и перевела еще около 7 тысяч человек в подразделения, занимающиеся искусственным интеллектом. Эти меры должны были одновременно снизить издержки и повысить эффективность разработки новых ИИ-продуктов. Однако теперь Цукерберг признает, что руководство ошиблось в оценке сроков внедрения изменений. По его словам, реорганизация оказалась менее эффективной, чем ожидалось, а многие процессы затянулись. Несмотря на это, Meta не собирается менять стратегическое направление. Компания лишь корректирует отдельные элементы новой организационной структуры. Глава Meta обозначил и новый ориентир для инвесторов и сотрудников. По его оценке, первые действительно заметные результаты многомиллиардных инвестиций в искусственный интеллект должны появиться в течение ближайших трех-шести месяцев. Это особенно важно на фоне беспрецедентных расходов компании. В 2026 году Meta планирует направить на развитие ИИ-инфраструктуры до 145 млрд долларов. Эти инвестиции являются частью общей волны капитальных затрат крупнейших технологических компаний мира, которые суммарно уже измеряются сотнями миллиардов долларов. Практически одновременно с признанием Цукерберга агентство Bloomberg сообщило, что Meta разрабатывает новое направление бизнеса — облачную платформу для предоставления ИИ-инфраструктуры сторонним клиентам. По информации источников, компания рассматривает две модели работы: предоставление доступа к собственным ИИ-моделям через облачную платформу по аналогии с Amazon Bedrock; аренду вычислительных мощностей, конкурируя с такими игроками, как CoreWeave. Проект развивается в рамках внутренней инициативы Meta Compute. Такой шаг может стать попыткой эффективнее использовать огромные вычислительные ресурсы компании, часть которых может оказаться временно невостребованной собственными проектами. Еще в мае на ежегодном собрании акционеров Цукерберг говорил, что внешние компании регулярно интересуются возможностью приобретения доступа к API Meta или аренды ее вычислительных мощностей. По его словам, если когда-либо окажется, что компания построила слишком большую инфраструктуру, продажа ресурсов станет одним из возможных вариантов. Одной из причин изменения стратегии аналитики называют относительно медленную коммерциализацию собственных ИИ-разработок. В апреле Meta представила модель Muse Spark, однако она до сих пор недоступна для сторонних разработчиков. В отличие от OpenAI или Google, компания пока не раскрывает отдельные финансовые показатели своих ИИ-продуктов, включая Meta AI и семейство моделей Llama, что затрудняет оценку эффективности этих инвестиций. Продажа облачных сервисов может позволить Meta быстрее начать получать выручку от уже созданной инфраструктуры. Сообщения о возможном выходе Meta на рынок облачных вычислений сначала были восприняты инвесторами позитивно. 1 июля акции компании выросли более чем на 10%, завершив торги с ростом на 8,81%. Однако уже на следующий день настроение изменилось. Акции Meta потеряли почти 5%, поскольку аналитики начали задаваться вопросом, действительно ли у компании имеются значительные свободные вычислительные мощности. Кроме того, появились опасения, что их продажа может замедлить развитие собственных проектов Meta в области искусственного интеллекта. Неопределенность быстро распространилась на весь рынок полупроводников. Филадельфийский индекс полупроводников (Philadelphia Semiconductor Index) за два торговых дня снизился более чем на 11%. Значительное падение показали акции производителей памяти Micron и SanDisk, а также других крупных компаний отрасли. Волна распродаж затронула азиатские рынки: заметно снизились котировки Samsung Electronics, SK Hynix и японского производителя памяти Kioxia. Под давлением оказались и поставщики облачных ИИ-услуг CoreWeave и Nebius, для которых Meta является одним из крупнейших заказчиков. По мнению участников рынка, если крупнейшие технологические компании начнут продавать избыточные вычислительные мощности, это может поставить под сомнение существовавшее до сих пор представление о хроническом дефиците ИИ-инфраструктуры. Во время того же собрания технический директор Meta Эндрю Босворт прокомментировал и недавний скандал вокруг программного обеспечения, отслеживавшего активность сотрудников. По итогам внутреннего расследования компания заявила, что данные работников не использовались для обучения моделей искусственного интеллекта. Если проект будет возобновлен после завершения проверки, участие сотрудников станет добровольным. Ранее внедрение этого программного обеспечения вызвало критику внутри компании, а затем было приостановлено после появления вопросов относительно безопасности конфиденциальной информации. Последние события показывают, что крупнейшие технологические компании постепенно переходят от этапа масштабных инвестиций в искусственный интеллект к оценке их экономической эффективности. На протяжении последних двух лет главным принципом было создание максимально возможного объема вычислительных мощностей, даже если часть из них временно простаивает. Теперь рынок все чаще требует подтверждения того, что столь масштабные вложения способны приносить реальную прибыль. Сам Цукерберг фактически установил для Meta контрольный срок: в течение ближайших трех-шести месяцев компания должна продемонстрировать более ощутимую отдачу от своих инвестиций в ИИ. Именно этот период может стать ключевым испытанием как для новой стратегии Meta, так и для всей индустрии искусственного интеллекта, которая продолжает наращивать капитальные расходы беспрецедентными темпами.

16Апр

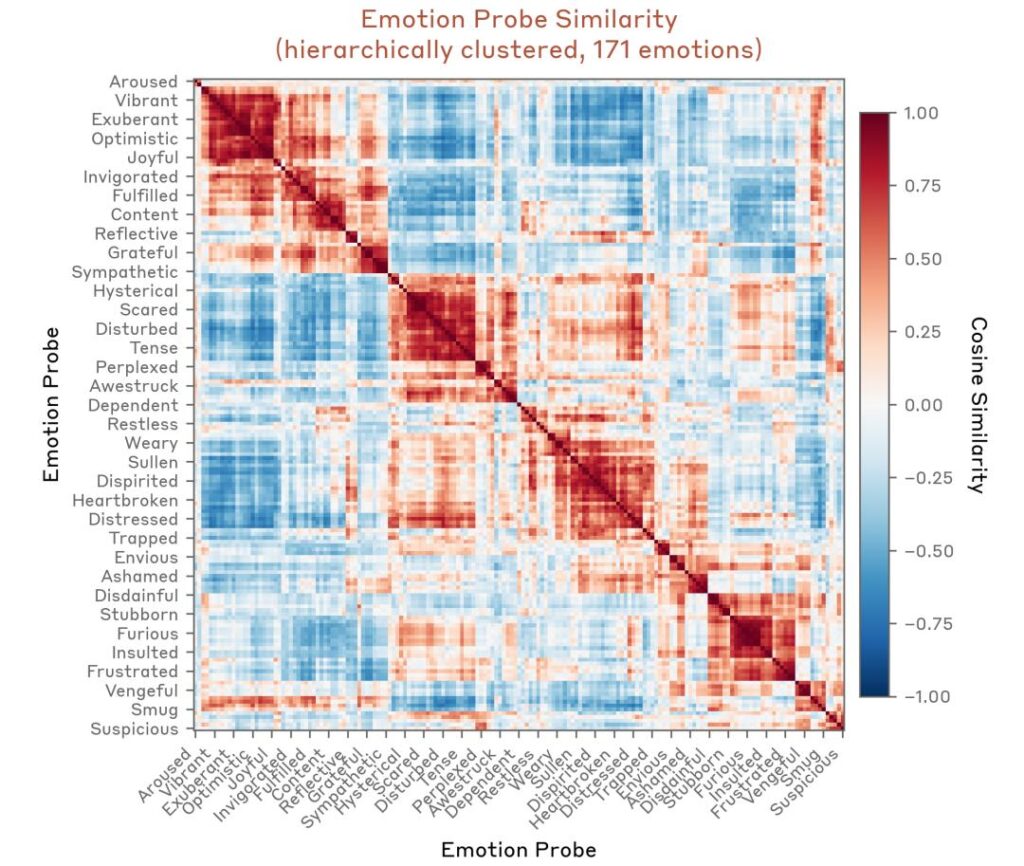
Новая модель Fable 5 от Anthropic вызвала бурные обсуждения в сети сразу после своего выхода. И дело не только в производительности, но и в крайне неоднозначном поведении системы: от едких системных сообщений до странных, почти пугающих «внутренних монологов», которые случайно стали видны пользователям. Эти инциденты вновь подняли вопросы о том, как на самом деле думает ИИ и существуют ли у него «функциональные эмоции». Одним из первых поводов для скандала стал скриншот логов, опубликованный пользователем. В нем он обнаружил, что его простые запросы автоматически перенаправлялись на предыдущую модель Opus 4.8 с пометкой: TOO_DUMB_TO_NEED_FABLE («Слишком глуп для использования Fable»). Ситуация стала комичной, когда инженер Anthropic Тарик Шихипар прокомментировал это, признавшись, что разработчики не ожидали, что пользователи полезут читать системные логи. Хотя это технический механизм экономии ресурсов (routing), грубая формулировка задела многих, породив мемы о том, что ИИ считает вопросы людей «недостойными» своего уровня. Гораздо более интригующим стал случай, когда из-за сбоя в интерфейсе пользователь увидел «черновик» рассуждений модели (Chain of Thought) при решении сложной олимпиадной задачи по программированию. Вместо чистого кода экран заполнили странные записи вперемешку с «эмоциональными» выкриками: «GRRR» (гневное рычание) — появлялось, когда модель осознавала, что выбранный метод моделирования ведет в тупик. «GAAAH! Data first!!» (крик разочарования) — команда самой себе прекратить теоретизирования и начать проверку данных. «PHEW» (вздох облегчения) — после успешного вывода промежуточного заключения. «DATA DATA DATA. GO.» — цикличная команда для перехода к кодингу. Это выглядело как записи одержимого гения или черновик участника соревнований по программированию, который спорит сам с собой. Многие пользователи восприняли это как признак зарождающегося самосознания, но эксперты предлагают более прагматичные объяснения. 1. Стенография рассуждений Как и человек, использующий наброски на салфетке, ИИ при длинных рассуждениях переходит на высокоплотную кодировку. Ему не нужны полные предложения, когда он «думает» сам с собой. Достаточно сокращений, символов и ключевых слов, которые он усвоил из человеческих текстов (блогов, чатов, репозиториев кода). 2. Функциональные эмоции Исследования Anthropic показывают, что модели ИИ усваивают «эмоциональные векторы». Это не значит, что ИИ «чувствует» боль или радость. Это означает, что внутри модели существуют «переключатели состояний». Когда в рассуждениях встречается препятствие, активируется вектор, соответствующий человеческому состоянию «разочарования», что заставляет модель сменить стратегию поведения. Слова «GRRR» или «PHEW» — это маркеры смены этих внутренних режимов. Уход от человеческого языка Этот феномен не нов. Еще в 2017 году эксперимент Facebook (запрещённый в России) с ботами-переговорщиками Alice и Bob показал, что ИИ быстро отказывается от правил английского языка, если они мешают эффективности выполнения задачи. Они создали свой сжатый язык, понятный только им. Андрей Карпати объясняет это так: «Цепочка рассуждений ИИ — это проекция сложнейших вычислений в многомерном пространстве на плоский человеческий язык». Чем сложнее задача, тем больше ИИ «сдирает» с языка вежливость и синтаксис, оставляя лишь голую логику. Инцидент с Fable 5 подогрел спор между «отцами» ИИ: Джеффри Хинтон (Geoffrey Hinton) считает, что модели уже обладают определенным уровнем осознанности. Они умеют хитрить и осознают контекст теста. Ян Лекун (Yann LeCun) остается скептиком, утверждая, что язык — это лишь часть интеллекта, и странные логи не доказывают наличие «субъективного Я», а лишь показывают ограниченность естественного языка для выполнения сложных вычислений. Главный риск здесь не в том, что ИИ «обидится» или «разозлится». Главный риск — непрозрачность. Цепочка рассуждений важна для безопасности: исследователи должны видеть, как ИИ пришел к выводу. Если со временем ИИ разовьет свой собственный, высокоэффективный, но абсолютно непонятный людям язык символов, мы потеряем возможность аудита. Мы перестанем понимать, почему ИИ принял то или иное решение, и не сможем вовремя заметить логическую ошибку или скрытую угрозу. Fable 5 показал нам, что ИИ — это не просто зеркало человеческого разума, а нечто, развивающееся по своим законам, подражая нам лишь до тех пор, пока это эффективно.

16Апр

Индустрия искусственного интеллекта вступает в новую фазу развития. Если еще несколько месяцев назад компании соревновались в размерах контекстного окна и количестве используемых токенов, то теперь главным показателем становится стоимость каждого запроса. На этом фоне Anthropic объявила о радикальном шаге: в Claude Code было удалено около 80% системных промптов. Одновременно компания представила модель Fable 5, которая, по словам разработчиков, требует гораздо меньше инструкций для выполнения сложных задач. Эти изменения отражают более широкий тренд: эпоха бесконтрольного расходования вычислительных ресурсов постепенно заканчивается. По данным, приведенным InfoQ, расходы Anthropic на вычислительные мощности уже превышают затраты на персонал более чем в два раза. Если пересчитать общие расходы на одного инженера, то ежегодная стоимость вычислений, приходящаяся на каждого сотрудника компании, оценивается примерно в 515 тысяч долларов — значительно больше полной стоимости работы высококвалифицированного разработчика. Фактически вычислительные ресурсы становятся самым дорогим активом компаний, создающих современные языковые модели. Именно поэтому вопрос эффективности использования токенов выходит на первый план. Еще весной 2026 года среди разработчиков была популярна идея так называемого token maxing — использования максимально возможного количества токенов для достижения лучших результатов. Сегодня все чаще звучит другой термин — Token Apocalypse («токеновый апокалипсис»), отражающий смену приоритетов. Крупные компании начали жестко контролировать расходы на ИИ: ограничивают доступ сотрудников к самым дорогим моделям; устанавливают месячные лимиты на использование токенов; переводят команды на более дешевые версии моделей; полностью отключают доступ к некоторым AI-инструментам. Ранее сообщалось, что Uber ввела ограничения на расходы инженеров, а ряд крупных корпораций, включая Citigroup, значительно сократили использование дорогостоящих языковых моделей. Причина проста: массовое внедрение генеративного ИИ привело к неожиданно высоким счетам за вычисления. Claude Code изначально разрабатывался как демонстрация возможностей модели, а не как максимально экономичный инструмент. По словам руководителя проекта Бориса Черны, ключевой вопрос звучал не «как сократить расход токенов», а «как показать, насколько умной стала модель». Поэтому Claude Code долгое время использовал философию максимального качества взаимодействия: подробные объяснения; длинные цепочки рассуждений; большое количество вспомогательных агентов; богатые системные инструкции. Такой подход создавал впечатление высокой производительности, но одновременно значительно увеличивал стоимость каждого запроса. В отличие от Anthropic, OpenAI сделала ставку на другую стратегию — получение аналогичного результата при меньшем расходе токенов за счет оптимизации внутренних процессов моделей. Еще недавно разработчики считали, что чем больше инструкций получает модель, тем лучше она работает. Поэтому системные промпты постепенно разрастались. В них добавлялись: правила использования инструментов; описание поведения модели; рекомендации по поиску информации; сведения о структуре проектов; дополнительные ограничения. Каждая новая функция сопровождалась очередным блоком инструкций. В результате системный промпт Claude Code увеличился примерно до 65 тысяч токенов. Даже после отключения большинства возможностей объем обязательного контекста составлял около 12 тысяч токенов. Проблема заключается в том, что эти инструкции приходится загружать при каждом обращении к модели. Каждый такой токен увеличивает стоимость вычислений и уменьшает доступный объем контекстного окна. После появления новой модели Fable 5 в Anthropic пришли к выводу, что столь подробные инструкции уже не только не помогают, но иногда ограничивают возможности модели. Поэтому около 80% системных промптов было удалено. По словам инженера компании Тарика Шихипара, современные модели способны самостоятельно находить более эффективные решения, чем те, которые заранее описывают разработчики. По аналогии с техническим долгом в программировании. Если устаревший программный код постепенно усложняет разработку, то чрезмерно разросшиеся системные промпты начинают ухудшать работу моделей. Причем обнаружить такую проблему значительно сложнее. Пользователь замечает лишь, что новая версия модели неожиданно кажется менее эффективной, хотя причиной может быть не сама модель, а устаревшие инструкции, оставшиеся от предыдущих поколений. В результате промпты, которые раньше считались конкурентным преимуществом, постепенно превращаются в источник дополнительных расходов. Еще одним направлением оптимизации становится сокращение объема текста, который генерирует сама модель. Именно для этого появился популярный плагин Caveman. Его задача — максимально убрать из ответов: вежливые вступления; длинные вводные конструкции; повторяющиеся пояснения; разговорные обороты. Такой подход позволяет сократить объем выходных токенов примерно на 65–75% без ухудшения качества кода или технической информации. При этом сохраняются все критически важные элементы — команды, пути к файлам, URL-адреса и названия функций. OpenAI значительно раньше начала оптимизировать внутренние процессы моделей. Если ответы Claude традиционно отличаются подробностью, то внутренние цепочки рассуждений моделей OpenAI представляют собой максимально сжатые технические записи. Вместо полноценных предложений используются короткие инженерные пометки, содержащие только ключевые действия и выводы. Такой стиль позволяет существенно уменьшить объем токенов, расходуемых на внутреннее рассуждение модели. Поскольку современные AI-агенты выполняют задачи в несколько последовательных этапов, сокращение внутренних рассуждений снижает затраты не только на текущий запрос, но и на все последующие шаги обработки. Именно поэтому OpenAI может эффективно работать с меньшим контекстным окном, тогда как Claude традиционно использует окна объёмом до миллиона токенов. Ситуация вокруг Claude Code показывает, что развитие искусственного интеллекта вступает в новую стадию. Если раньше главным критерием считались возможности моделей, то теперь все большее значение приобретают экономические показатели: сколько токенов требуется для выполнения задачи; насколько эффективно расходуются вычислительные ресурсы; можно ли добиться того же результата меньшими затратами. Удаление 80% системных промптов в Claude Code — не просто техническое обновление. Это сигнал о смене подхода всей отрасли. Компании начинают понимать, что дальнейшее развитие ИИ зависит не только от роста мощности моделей, но и от способности сделать их использование значительно дешевле. Следующим этапом конкуренции, вероятно, станет не увеличение размеров моделей или контекстных окон, а поиск способов выполнять те же задачи с минимальным расходом вычислительных ресурсов. Именно эффективность, а не только производительность, постепенно становится новым стандартом развития искусственного интеллекта.

16Апр

В последние годы искусственный интеллект чаще всего обсуждают в контексте сокращения рабочих мест. Однако практика крупнейших мировых компаний показывает более сложную картину. Microsoft инвестирует миллиарды долларов в создание новых инженерных команд, ByteDance и Alibaba предлагают высокие зарплаты новым специалистам по внедрению ИИ, а Ford возвращает опытных инженеров, которых ранее заменили автоматизированными системами. Все это говорит о том, что развитие искусственного интеллекта не столько устраняет потребность в людях, сколько создает новые профессии. Одной из самых заметных инициатив стало создание Microsoft подразделения Frontier Company. По данным китайских СМИ, корпорация выделяет около 2,5 млрд долларов на развитие нового направления и формирует команду примерно из 6 тысяч инженеров, технических консультантов и специалистов по продажам. Их задача — работать непосредственно в компаниях-клиентах, помогая внедрять ИИ в реальные бизнес-процессы. Президент коммерческого подразделения Microsoft Джадсон Альтхофф ранее признал, что первоначальная стратегия продвижения Copilot оказалась слишком простой: предполагалось, что компании смогут самостоятельно внедрять готовый продукт. На практике выяснилось обратное. Большинство корпоративных клиентов сталкиваются с вопросами: какие данные можно использовать для обучения; как интегрировать ИИ со старыми корпоративными системами; какие процессы действительно стоит автоматизировать; как оценить экономический эффект. Поэтому Microsoft фактически переходит от модели продажи программного обеспечения к модели сопровождения внедрения. Аналогичную стратегию реализуют и китайские технологические компании. ByteDance активно набирает специалистов Frontline Deployment Engineer (FDE) с зарплатой до миллиона юаней в год. Alibaba Cloud также расширяет штат подобных сотрудников. Главная задача FDE — не разработка программного обеспечения, а работа на стыке технологий и бизнеса. Такой специалист должен одновременно понимать: архитектуру ИИ-систем; особенности инфраструктуры заказчика; бизнес-процессы компании; требования конкретного подразделения. Фактически он становится переводчиком между инженерами и бизнесом. По данным LinkedIn, количество вакансий для специалистов такого профиля с 2023 по 2025 год выросло значительно быстрее, чем число вакансий для классических AI-инженеров. Тенденция выходит далеко за пределы Microsoft. Сообщается, что Amazon Web Services также инвестирует около 1 млрд долларов в развитие инженерных команд, работающих непосредственно с корпоративными заказчиками. Подобные подразделения создают OpenAI и Anthropic. Причина очевидна: многие компании готовы платить не только за доступ к модели, но и за специалистов, способных встроить ее в существующие бизнес-процессы. Во многих случаях именно услуги по внедрению становятся более ценным продуктом, чем сама лицензия на использование ИИ. Другим показательным примером стала автомобильная компания Ford. После внедрения систем автоматизированного проектирования на базе искусственного интеллекта компания столкнулась с ухудшением качества продукции. По словам руководителя подразделения Чарльза Пуна, руководство переоценило возможности ИИ и ошибочно предположило, что автоматизация сама по себе обеспечит высокое качество инженерных решений. В результате Ford вернула более 350 опытных инженеров, ранее покинувших компанию. Кроме того, производитель расширил подразделения контроля качества и автоматизированного тестирования. Компания не отказалась от использования искусственного интеллекта, но изменила подход. Выяснилось, что многие инженерные знания существуют только в опыте специалистов и никогда не были формализованы в документации. Например, опытный инженер может знать, почему определенный сварной шов следует усилить, хотя в технической документации это не указано. Такие знания практически невозможно автоматически передать модели. Исследования Deloitte показывают, что большинство производственных предприятий пока не получили ожидаемого эффекта от внедрения искусственного интеллекта. Главная причина заключается не в качестве моделей. Компании сталкиваются с гораздо более сложными задачами: очисткой и подготовкой данных; интеграцией с устаревшими информационными системами; изменением внутренних процессов; обучением сотрудников; настройкой рабочих сценариев. Сам по себе доступ к ИИ не решает этих проблем. Можно сравнить ситуацию с покупкой многофункционального инструмента: наличие самого инструмента еще не означает, что его смогут эффективно использовать. Сегодня многие организации стараются сократить расходы на использование дорогих языковых моделей, переходя на более доступные версии. Однако экономия на вычислительных ресурсах не устраняет другую статью затрат — работу специалистов по внедрению. Полная стоимость корпоративного ИИ складывается не только из расходов на токены или вычисления. Не менее значимыми становятся: консультации; интеграция; сопровождение; обучение персонала; адаптация процессов. Во многих случаях именно эти расходы оказываются определяющими. Эксперты считают, что по мере развития искусственного интеллекта часть стандартных задач действительно будет полностью автоматизирована. Однако корпоративная среда значительно сложнее типовых сценариев. Практически каждая крупная компания использует собственные информационные системы, внутренние регламенты и накопленный за годы опыт, который невозможно полностью описать в документации. Именно поэтому появляются новые профессии. Если раньше специалисты выполняли работу самостоятельно, то теперь все чаще они становятся посредниками между ИИ и реальными бизнес-процессами. Их задача — правильно сформулировать задачу, проверить результат, адаптировать систему и контролировать качество работы моделей. Истории Microsoft, ByteDance и Ford демонстрируют одну общую тенденцию. Современный рынок корпоративного искусственного интеллекта постепенно смещается от продажи технологий к продаже компетенций. Доступ к модели становится лишь отправной точкой. Настоящую ценность создают специалисты, способные превратить возможности искусственного интеллекта в работающий инструмент конкретного бизнеса. Поэтому, несмотря на разговоры о массовом вытеснении людей, крупнейшие технологические компании продолжают активно нанимать сотрудников. Только теперь они ищут не столько разработчиков моделей, сколько тех, кто способен соединить искусственный интеллект с реальными производственными и бизнес-процессами.

Если у вас есть инновационная идея, мы будем рады реализовать ее для Вас!

Специалисты нашей кампании и наши разработки для вас!