Новости

Социальные сети

Узнайте больше о рынке It и новейших технологиях.
СТАТЬИ
16Апр

Накануне Google I/O компания неожиданно анонсировала новую линейку «Androidкомпьютеров» — высокопроизводительных устройств, отличающихся от Chromebook и позиционируемых как ПК нового класса с AI в основе системы. Это не просто ещё одна попытка «встроить» ИИ в привычный ноутбук: Google предлагает переосмыслить роль устройства, сделав облачный AI главным актором, а локальную вычислительную мощность — второстепенной. Именно поэтому речь вновь идёт о возрождении идеи облачного компьютера — и о столкновении двух подходов: «много локального железа» против «легкого клиента + мощный облак». Современные AIПК в индустрии чаще всего выглядят как классический Windowsноутбук с «наружной» AIфункцией: производители добавляют отдельные нейроускорители (NPU), а в систему встраивают ассистента, генераторы изображений и прочие «фичи». Но по сути это всё ещё традиционный ПК — AI выступает как набор приложений, часто полагающихся на облачные модели. Практические ограничения очевидны: у большинства потребительских устройств нет ресурсов для запуска крупных локальных моделей — не у каждого в ноутбуке есть топвидеокарта и десятки гигабайт ОЗУ. Даже те редкие локальные всплески интереса к моделям (например, хайп вокруг локальных инстанций вроде OpenClaw) показывают: большинство пользователей попрежнему обращается к облаку — где дешевле токены, там разворачивают «лотки» с LLM. В итоге возникает вопрос: если основная ценность AIфункций всё равно в облаке, что ценного даёт дорогой «AIчип» в ноутбуке? Может ли аппаратная надбавка быть просто «налогом на интеллект» — платой за маркетинг, а не за реальную необходимость? Есть несколько ключевых аргументов в пользу облачных решений: Сетевые задержки для большинства интерактивных AIзадач гораздо более терпимы, чем для игрового стриминга. Пока ответ модели приходит за доли секунды — пользователи готовы ждать; в отличие от игр, где малейшая латентность убивает опыт. Реальная «узкая бутылочная горлышко» — не сеть, а вычислительная мощность и хранение модели. В облаке можно масштабировать GPUкластеры и выделять большие модели по требованию, чего локальному устройству не сделать. Облачные платформы позволяют централизованно обновлять, оптимизировать и предлагать разные модели по цене токенов, что упрощает доступ и делает эксперименты для пользователей дешевле и удобнее. В условиях роста цен на хранение локальные конфигурации с огромными SSD и оперативкой становятся дорогими; облако частично снимает эту нагрузку с потребителя. Это объясняет, почему многие облачные игроки и провайдеры уже предлагают «облачные ПК», адаптированные под AIнагрузки: готовые сервера с моделью, быстрой разверткой и интеграцией с сервисами. Идея Androidкомпьютера от Google — не просто добавить ассистента: AI интегрируется в систему глубоко и везде. Концепт простой: переместил указатель — AI анализирует текст, картинку или код рядом с курсором и предлагает действия прямо в контексте. Это системный подход, где облачный Gemini выступает ядром, а устройство становится лёгким интерфейсом. Ключевой момент: Google не навязывает конкретной аппаратной платформы — Androidкомпьютеры могут работать на x86 и ARM, с процессорами Intel, Qualcomm, MediaTek. Это подтверждает, что реализация AIфункций ориентирована прежде всего на облако, а не на дорогую локальную начинку. Реакция индустрии: кто на какой стороне баррикады Чипмейкеры (Intel, AMD) продолжают развивать локальные NPU и серверные решения, рассчитывая занять свою нишу в инфраструктуре датацентров и у крупных потребителей AI. Они также активно работают на рынке серверов, где спрос на ускорители остаётся огромным. Традиционные OEM (Lenovo, HP, Dell и др.) интегрируют AIфичи в Windowsноутбуки, но многие делают ставку на связку локального ускорения и облачных сервисов. Apple — особая позиция: облачные и локальные функции Apple Intelligence разрабатываются в связке с Mчипами и macOS. У Apple есть преимущество интеграции со своей экосистемой, и даже если облако остаётся важным, сильный локальный стек даёт компании контроль над пользовательским опытом. Microsoft действует системно: Windows Copilot Runtime, требования к минимальной вычислительной мощности (например, 40 TOPS и 16 ГБ ОЗУ в рекомендациях) и глубокая интеграция Copilot в OS, Office и Edge подчёркивают гибридный подход: локальная поддержка + облачная мощь. Ограничения и вызовы для модели «облако = всё» Несмотря на аргументы в пользу облака, у такого подхода есть серьёзные препятствия: Сетевые ограничения и нестабильность в отдельных регионах могут ухудшить опыт, особенно в мобильных сценариях. Проблемы приватности и регуляции — некоторые пользователи и компании не готовы отправлять чувствительные данные в облако, даже при высокой инженерной защите. Пользовательские привычки: многие привыкли к автономности устройств и мгновенному отклику локальных приложений. Появление Androidкомпьютеров показывает, что индустрия склоняется к «тонкому клиенту» с глубокой облачной интеграцией: AI становится системной способностью устройства, а не отдельной фичей. Но победителем не обязательно будет одна модель — рынок, скорее всего, станет многополюсным: Для массового потребителя и корпоративных пользователей, заинтересованных в мощности и обновляемости, облачные AIПК могут стать стандартом — минимум локального железа и максимально масштабируемое облако. Для тех, кто ценит приватность, автономию или требует сверхнизкой латентности, будут востребованы мощные локальные решения и гибридные конфигурации. Важно, кто сможет собрать вокруг себя эффективную систему: операционная система, облачные модели, партнёрская экосистема сервисов и удобный UX. Именно экосистема, а не одинединственный показатель TOPS, определит победителя. Итог: будущее ПК перестаёт быть просто гонкой за локальными флопсами. Это соревнование за системную интеграцию облачных интеллектов, удобство и гарантии приватности. В ближайшие годы мы увидим, как рынок будет тестировать разные формулы — но одно ясно: классический ПК как «коробка с железом» уже давно превратился в интерфейс к облачному уму.

16Апр

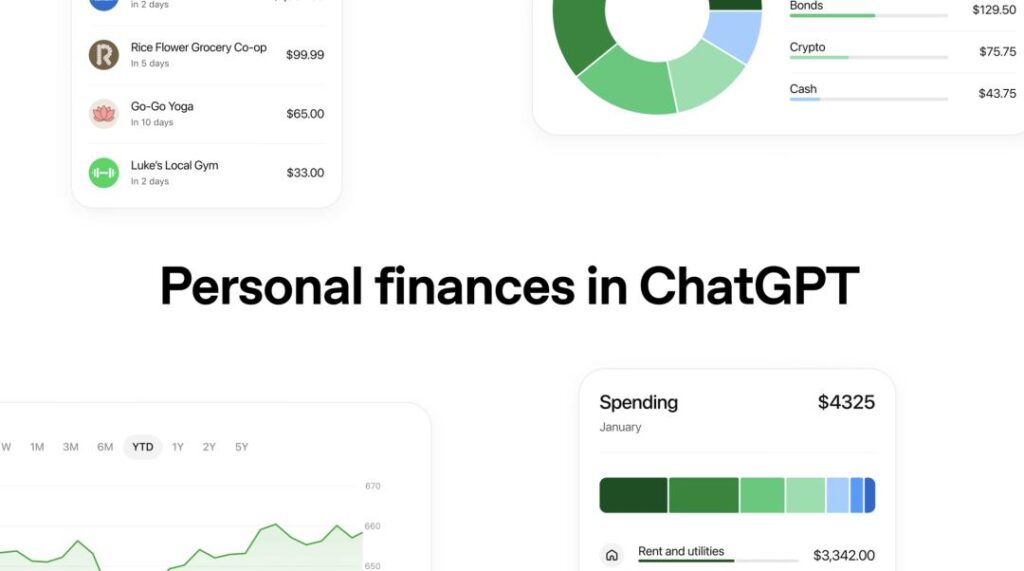
15 мая OpenAI представила новую функцию — личный финансовый инструмент внутри ChatGPT. На практике это значит: при желании вы можете напрямую подключить свои банковские и инвестиционные счета к ChatGPT через сервис агрегирования финансовых данных Plaid, после чего бот получит доступ к истории транзакций, остаткам, инвестициям и задолженностям и сможет вести с вами «диалоговое» финансовое обслуживание. Пока что функция доступна в превью только в США для подписчиков ChatGPT Pro (цена в тексте — $200/мес). Что умеет новый инструмент Подключение счетов через Plaid (поддержка тысяч финансовых учреждений). Токенизированная авторизация означает, что ChatGPT не получает ваши банковские пароли напрямую. Автоматическая синхронизация и категоризация расходов: балансы, история транзакций, периодические подписки, предстоящие платежи, зарплата, инвестиционный портфель, кредиты и т. п. Визуальная панель (dashboard) с метриками и графиками. Диалоговый интерфейс: задаёте естественным языком цель — «помоги накопить на квартиру за 5 лет», «покажи, где я стал тратить больше» — и ассистент анализирует ваши реальные данные и даёт персонализированные сценарии. Сохранение личных контекстных «памятей» (например, долг перед родителями или планы покупки машины) для учёта в дальнейших рекомендациях. В планах — подключение Intuit для более глубокой налоговоинвестиционной аналитики и функционала, связанного с налогообложением при продаже активов и оценкой вероятности одобрения кредитов/карт. Почему OpenAI способна это сделать Стратегия не новая: раньше в январе компания уже запустила интеграцию медицинских данных. Правда, финансы — это отдельный класс рисков и доверия. За спиной у OpenAI — поглощения fintechстартапов (Roi и Hiro Finance), к которым пришли профильные специалисты. Эти приобретения создали «финансовую» команду и продуктовый опыт для запуска сервиса. Масштаб спроса: OpenAI отмечает миллионы финансовых запросов в ChatGPT ежемесячно — пользователи уже пользуются ботом как «советчиком», просто ранее без доступа к личным данным. Главный барьер — доверие и безопасность Запуск наткнулся на бурю в комментариях и вопросы общественности. Главные опасения: Конфиденциальность и передача данных. OpenAI подчёркивает, что ChatGPT не имеет права совершать операции (переводы, платиж) — только читать данные; при отключении доступ удаляется в течение 30 дней. Но в интерфейсе есть опция «использовать данные для улучшения модели» — по умолчанию выключена, но её наличие заставляет задуматься: может ли финансовая информация в итоге попасть в тренировочный пул? Репутационный фон. На волне недавних судебных претензий (например, обвинения в слежении через встроенные пиксели аналитики), у OpenAI нет идеальной репутации в вопросах приватности, и это снижает доверие к хранению самых чувствительных данных. Регуляторный и юридический аспект. Бот даёт рекомендации, но юридически не является лицензированным финансовым советником и не несёт ответственности за финансовые последствия решений пользователя. Это создаёт «серую зону»: сервис разговаривает как консультант, но ответственности не принимает. Технические риски. Риск утечек, багов или «галлюцинаций» модели в интерпретации транзакций может привести к неверным советам. Права на операцию и безопасность токенов Plaid — отдельная инфраструктурная точка риска. Доступ к финансовым данным — это доступ к «высокоценным» постоянным сигналам о поведении людей: частые взаимодействия, высокая коммерческая ценность и платёжеспособность. Война за такие данные идёт у всех: Anthropic, Perplexity и другие тоже запускают или адаптируют финансовые агенты и продукты. Plaid сейчас играет роль инфраструктурного шлюза (аналогично роли Stripe в платежах) — кто контролирует такой канал, тот получает критический вход в экосистему AIфинансов. Что стоит спросить перед подключением Какие именно права у ChatGPT после подключения: только чтение или возможны операции? Где хранятся токены доступа и как обеспечивается их безопасность? Каковы гарантии удаления данных и что происходит с копиями в логах/бэкапах? Настаивается ли юридическая ответственность за ошибки в рекомендациях? Есть ли страхование/компенсация ущерба? Какие регуляторы и стандарты соблюдаются (например, финансовое регулирование, SOC/ISOаудиты, стандарты безопасности данных)? Итог: технология готова, доверие — нет С продуктовой точки зрения интеграция банковских счетов в ChatGPT — логичный этап эволюции: от универсального помощника к персональному «CFOботу». Технологии (аутентификация через Plaid, токенизация, аналитические модели) позволяют сделать это безопаснее, чем чистая передача логинов. Но финансы — это не только технология. Это ответственность, регулирование и, прежде всего, доверие. OpenAI предлагает удобство и персонализацию; пользователи и регуляторы требуют гарантий: прозрачности, юридической ответственности и строгой защиты данных. Вопрос, который остаётся открытым: готовы ли вы отдать ключи от личной финансовой жизни алгоритму, которому попрежнему свойственны ошибки, а компания всё ещё проходит через судебные и репутационные испытания? И небольшой опрос от редакции: вы бы подключили свой банковский счёт к ChatGPT? Почему да или нет?

16Апр

Anthropic неожиданно пересмотрела расчётные правила для пользователей Agent SDK и программных вызовов Claude — и сделала это в самый неудачный для многих момент. Компания вывела Agent SDK, вызовы claude -p, интеграции GitHub Actions и третьисторонние Agentинструменты из общего подписочного пула и предложила взамен отдельные ежемесячные кредиты по розничной цене API. Для многих «тяжёлых» пользователей это означает реальное сокращение доступных ресурсов — по факту до ~10× по сравнению с прежним «пакетом». Что именно изменилось С 15 июня 2026 года использование Agent SDK, claude -p, GitHub Actions и ряда сторонних Agentинтеграций больше не учитывается в обычных подписочных лимитах Claude. Вместо этого подписчикам (Pro/Max/Team/Enterprise) назначается отдельный ежемесячный кредит, номинально эквивалентный плате по APIтарифам: Pro — $20, Max 5x — $100, Max 20x — $200. Кредиты нужно один раз запросить (уведомление рассылалось 8 июня), они обновляются каждый цикл и не накапливаются. Подписочные лимиты остаются для интерактивного использования Claude (чат, Claude Code в интерактиве). Пользователи с APIключами разработческого портала платят по использованию и изменений для них нет. (Официальное объявление — см. Claude Support и посты разработчиков в X: 1, 2.) Подписка подразумевает «человеческое» потребление: человек печатает, читает, отвечает — ограниченная скорость токенов. Подписочные «безлимиты» строились на этой предпосылке. Программные агенты и автоматизированные вызовы (Agent SDK, скрипты, циклы) ломают эту модель: машины могут 24/7 генерировать запросы и «съедать» месячные лимиты за минуты без того обучающего ценности, которую приносит интерактивный ввод человека. Резкое увеличение доступной мощности (огромные вливания в вычислительные ресурсы: партнёрства и аренда GPU, крупные инвестиции) означает, что издержки Anthropic по субсидированию таких сценариев стали неконтролируемы — компания вынуждена «латать» брешь в бизнесмодели до IPO и в разгар ASIгонки. Anthropic прямо рекомендует тем, кто запускает производственные автоматизации, перейти на разработческую платформу и платить по APIключу — то есть полностью переводит тяжёлое потребление на модель payasyougo. Чем это ударяет по пользователям Эффективное сокращение ресурсов: у многих пользователей номинальная сумма кредита равна их месячному подписочному платежу (например, $200), но ранее подписка фактически давала эквивалент APIресурсов на сумму порядка $2–5 тыс. — потери порядка 10×. Proпользователи особенно уязвимы: $20 кредита быстро съедаются при интенсивных Agentциклах. Третьисторонние инструменты (OpenClaw, Hermes и др.), которые ранее «жили» на подписочных квотах, теперь ограничены индивидуальными кредитами — после их сжигания требуется либо включать дополнительную оплату по API, либо останавливать автоматизацию. Единственное послабление — Anthropic официально признала третьисторонние Agentинструменты, тогда как ещё пару месяцев назад они рассматривались как «способ обойти лимиты». OpenAI оперативно использовала момент: компания предложила корпоративным пользователям инструмент Codex с предложением о бесплатной миграции на два месяца (30дневная заявка, 2 месяца бесплатно), включая однокнопочный инструмент для переноса подсказок, Skills и конфигураций из Claude Code. Codex не разделяет интерактивные и программные вызовы по разным пулам — всё оплачивается по токенам, что для многих автоматизационных сценариев выглядит проще и дешевле. (См. объявление OpenAI в X: OpenAI Devs.) Практический эффект: две бесплатных «больничных» недели/месяца достаточно, чтобы компания развернула автоматизацию на Codex и затем уже неохотно возвращалась назад, даже если Anthropic изменит политику снова. Что это значит для рынка и разработчиков Эпоха «безлимитных» подписок для агентных сценариев подходит к концу. Модель подписки вновь будет разделяться: интерактивное использование — подписка; программное, массовое, непрерывное — платная по факту. Путь напоминает эволюцию ценообразования облаков. Борьба за разработчиков станет ключевой: кто предложит удобный переход, лучшие SDK и стабильные тарифы — тот выиграет экосистему. Экосистемы определяют, какие приложения в итоге окажутся в руках пользователей. Сценарий «подписка → кредит → возврат к подписке» — рискован для бизнеса Anthropic: жесткие меры могут вызвать отток корпоративных клиентов, миграцию на OpenAI или другие платформы. Но оставлять дырку в модели финансово невозможно: оплачивать огромные машинные расходы за «автоматические съедатели» некому. Что делать разработчикам и компаниям прямо сейчас Если вы heavyuser Agent SDK: срочно запросите и активируйте свой кредит (напоминание — нужно запрашивать до реализации политики). Оцените расходы: пересчитайте текущие потребления в APIтарифы — возможно, выгоднее перейти на платный APIключ, где есть предсказуемость и масштабируемость. Рассмотрите миграцию на Codex/другие платформы: воспользуйтесь предложениями о бесплатной миграции и протестируйте перенос навыков/подсказок. Разработайте стратегию «cost guard»: лимиты на частоту вызовов, очереди, кэширование ответов, семплинг — чтобы снизить токенную нагрузку автоматизаций. Следите за ключевыми датами и событиями вокруг Anthropic: изменение лимитов, IPOцена, правовые события в отрасли — все это повлияет на дальнейшую политику. Anthropic закрыла «дыру» в подписочной модели — шаг экономически оправданный, но болезненный для ресурсовоёмких пользователей и для экосистемы Agentинструментов. Одновременно OpenAI использовала ситуацию для агрессивного захвата рынка разработчиков. Мы наблюдаем начало крупной перестройки ценообразования в отрасли: подписка для человека и оплата по факту для машинной автоматизации — и от выбора платформы теперь будут зависеть не только расходы, но и техническая судьба множества продуктов. Это первая серьёзная «ценовая заруба» в финальном этапе ASIгонки — и её результат в ближайшие месяцы предопределит, чьи инструменты будут чаще использоваться разработчиками и предприятиями в 2026–2027 годах.

16Апр

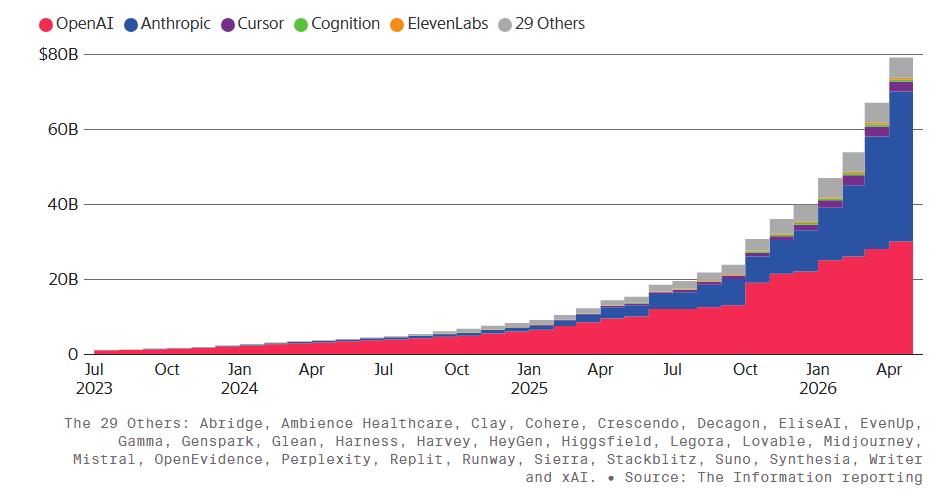
Генеративный ИИ по-прежнему выглядит как одна из самых быстрорастущих отраслей в мире технологий. Но за впечатляющими цифрами всё заметнее проступает другая тенденция: рынок не становится более разнообразным — наоборот, он стремительно концентрируется вокруг двух игроков. По данным базы генеративного ИИ американского издания The Information, совокупная годовая выручка 34 ведущих AI-стартапов, продающих доступ к моделям и AI-приложениям, уже приблизилась к $800 млрд, или примерно $66 млрд в месяц. Это на 112% больше, чем полгода назад. Однако главный вывод не в масштабе роста, а в том, как распределяются эти деньги. Anthropic и OpenAI сейчас контролируют около 89% всей выручки этого сегмента, тогда как остальные 32 компании вынуждены делить между собой лишь 11%. И если ещё недавно рынок ИИ казался пространством для десятков быстрорастущих команд, то теперь всё больше похоже, что он ускоренно движется к модели winner takes all — «победитель забирает почти всё». На первый взгляд картина кажется оптимистичной: совокупные доходы AI-компаний резко растут, новые продукты выходят на рынок, спрос со стороны бизнеса увеличивается, а пользователи всё активнее интегрируют ИИ в повседневную работу. Но если смотреть глубже, становится видно, что львиную долю этого роста генерируют всё те же лидеры. Причём формально доходы Anthropic и OpenAI не всегда полностью сопоставимы между собой: у обеих компаний есть особенности учёта. Anthropic признаёт выручку по полной сумме, даже если часть денег затем уходит облачным партнёрам, таким как Amazon и Google, которые перепродают доступ к её моделям. OpenAI, в свою очередь, обязана до 2030 года перечислять 20% выручки Microsoft, своему раннему стратегическому партнёру, но при этом не включает в публичные цифры часть продаж, идущих через облачных посредников. То есть при одинаковом стандарте учёта разрыв между ними мог бы выглядеть иначе. Но сути это не меняет: именно Anthropic и OpenAI сегодня задают темп всему коммерческому рынку генеративного ИИ. Особенно быстро, судя по опубликованным оценкам, прибавляет Anthropic. Если в начале 2026 года её годовая выручка оценивалась примерно в $10 млрд, то к апрелю она превысила $30 млрд, а к концу июня может достигнуть $50 млрд. По данным источников, компания рассчитывала вырасти в 10 раз за год, но фактически уже в первом квартале её выручка и объём использования выросли в 80 раз год к году. Для конкурентов это тревожный сигнал: рынок растёт, но достаётся он прежде всего тем, кто владеет базовой инфраструктурой — самыми востребованными моделями. На фоне двух гигантов часть более узких AI-компаний тоже демонстрирует заметные результаты. С конца 2025 года рубеж в $500 млн годовой выручки преодолели как минимум три компании: поисковик Perplexity, разработчик голосового ИИ ElevenLabs и coding-стартап Cognition. Ещё раньше в эту группу вошёл Cursor, сделавший ставку на AI-инструменты для программирования. Но есть важный нюанс: значительная часть доходов таких компаний в итоге всё равно возвращается к Anthropic и OpenAI. Многие из этих стартапов строят свои продукты поверх чужих моделей и платят поставщикам базовой технологии миллиарды долларов в виде расходов на API и вычисления. Получается своеобразный замкнутый цикл: прикладные компании наращивают выручку, но одновременно подпитывают тех, кто уже доминирует на уровне моделей. Cursor — один из самых показательных примеров. В квартале, завершившемся в январе, его валовая маржа была отрицательной — минус 23%. Для компании с такой высокой выручкой это выглядело необычно и тревожно. Позже показатель вышел в плюс, но сам факт показал, насколько уязвимыми могут быть AI-приложения, если они зависят от цен, условий доступа и продуктовой политики крупных модельных провайдеров. Особенно в ситуации, когда те же Anthropic и OpenAI начинают повышать стоимость использования своих технологий. Для небольших AI-стартапов опасность не только в том, что большая часть денег уходит наверх. Проблема ещё и в том, что их технологические поставщики постепенно превращаются в прямых конкурентов. Почти все заметные AI-приложения так или иначе завязаны на модели Anthropic или OpenAI. Но обе компании всё активнее двигаются вниз по цепочке создания стоимости: выпускают решения для конкретных профессий, сценариев и отраслей, в том числе для программистов, офисных сотрудников, аналитиков и корпоративных команд. Иными словами, они начинают делать продукты, похожие на те, которые раньше строили их собственные клиенты. Это подтверждает и логика инвесторов. В Кремниевой долине уже давно звучит тезис: в новой AI-экономике основная ценность будет создаваться не на уровне отдельных приложений, а на уровне передовых моделей и тех компаний, которые контролируют доступ к ним. Последние цифры, похоже, только укрепляют этот взгляд. Отсюда и повышенный интерес к новым «AI-лабораториям», которые пытаются создать альтернативу Anthropic и OpenAI. Инвесторы готовы вкладывать в них огромные суммы не потому, что рынок любит конкуренцию как таковую, а потому, что зависимость от двух доминирующих поставщиков становится слишком рискованной для всей экосистемы. Ещё один важный сдвиг связан с тем, как рынок теперь оценивает коммерческий потенциал AI-продуктов. Всё меньшее значение имеет просто число пользователей. Намного важнее — объём токенов, то есть количество вычислительной работы, которое пользователь поручает модели. Это меняет приоритеты компаний. Один разработчик, ежедневно использующий AI для написания и анализа кода, может приносить больше денег, чем тысячи обычных пользователей, которые время от времени задают чат-боту бытовые вопросы. Именно поэтому программирование становится одним из самых привлекательных сегментов для монетизации. Показательно, что OpenAI уже корректирует продуктовую стратегию, закрывая менее приоритетные направления вроде видеосервиса Sora и перераспределяя ресурсы в пользу coding-инструментов, таких как Codex. Это означает, что борьба за будущее рынка будет идти не только за массового пользователя, но прежде всего за тех, кто генерирует наибольшую вычислительную нагрузку — а значит, и наибольшую выручку. При всей впечатляющей динамике доходов AI-рынок остаётся крайне дорогим бизнесом. Только Anthropic и OpenAI вместе могут ежегодно сжигать свыше $30 млрд наличных, прежде всего из-за колоссальных затрат на обучение и поддержку моделей. Большинство компаний из числа лидеров по выручке всё ещё не являются стабильно прибыльными. Но и это не охлаждает аппетиты инвесторов. Напротив, рынок уже готовится к новой волне крупных размещений. По данным Reuters, одной из первых на IPO может выйти SpaceX, а вслед за ней во второй половине года на рынок потенциально могут направиться и OpenAI с Anthropic. Если эти размещения состоятся вблизи друг друга, они способны буквально «высосать» значительную часть инвестиционного спроса, оставив меньше пространства даже для очень крупных частных компаний вроде Canva и Databricks. Это ещё один признак зрелости рынка: ИИ перестаёт быть только историей про инновации и превращается в историю про масштаб, капитал и концентрацию

16Апр

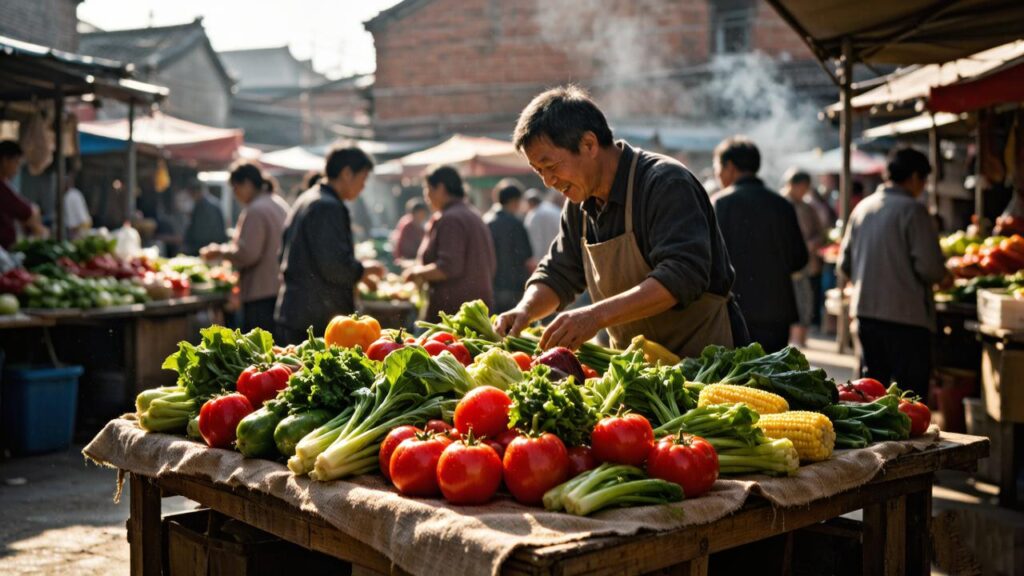
Рынок свежих продуктов огромен, объём китайского рынка FMCG в 2024 году достиг 6,57 трлн юаней. Это «ежедневный» трафик пользователей и стратегическая точка входа в жизнь потребителя. К концу 2025 года GMV сервиса приблизился к 300 млрд юаней — рост после «очистки» конкурентов показывает, что бизнес-модель способна выжить и адаптироваться. AI меняет математику издержек. Раньше «убыточность» схемы (предварительные склады, холодовая логистика, доставка) делала масштабирование невозможным без постоянных субсидий. Теперь перемещение затрат в фиксированные инвестиции (камера, модель, роботизированный склад) снижает предельные издержки — при грамотном внедрении это может вернуть прибыльность. Владение каналами поставляет данные, которые потом монетизируются в финансовых сервисах, таргетированной торговле и логистике. Потерять «порог ежедневного входа» — значит потерять базу для высокомаржинальных сервисов. Именно поэтому, несмотря на видимое «поражение» массовых попыток платформ в 2020–2025 годах, крупные игроки не уходят — они меняют тактику: от физических захватов к алгоритмической оккупации. Примеры технологий, которые прямо сейчас внедряются: Камеры и классификация. AI-камеры, распознающие сотни видов овощей и фруктов за доли секунды — они меняют учёт и инвентаризацию. Умные весы и система прослеживаемости. Электронные весы с цифровым следом, блокчейн-решения для трассировки происхождения товара. Динамическое ценообразование. Системы, которые в реальном времени подстраивают цену под спрос и предложение (отмечен проект с точностью прогноза 92% и 5минутной реакцией). Автономная логистика. Непрерывная автоматизация: от беспилотных складов до умных кабинетов и роботов-курьеров — снижение человеческого фактора, ускорение принятия решений. Аналитика и оптимизация запасов. Сбор потоковых данных с сенсоров для точного прогноза, минимизации потерь и оптимизации маршрутов. В совокупности это значит: фиксированные инвестиции окупаются многократно, а маргинальная стоимость каждой последующей транзакции падает почти до нуля.

16Апр

AIGC — искусственно сгенерированный контент — открыл настоящий «ящик Пандоры»: эффекты будут многогранными и частично непредсказуемыми. Исходя из нынешних трендов, можно констатировать два ключевых вывода: потенциал отрасли заметно вырастет, но одновременно неравенство внутри неё усилится. Что меняет AIGC: разделение труда между человеком и машиной Человек остаётся «душой» контента: источником оригинальности, авторского голоса, уникального стиля и инсайтов. AI берёт на себя «мясо» — массовые, повторяющиеся операции: генерация черновиков, вариаций, монтажные операции, подгонка форматов под платформы, автоматический дубляж и локализация.Именно такой расклад повышает общую производительность и масштабируемость контент-производства. Почему неравенство усилится Экономия времени и масштабы работы усиливают эффект лидеров. Если у топсоздателя уже есть аудитория и стиль, AI позволяет ему в разы нарастить производство и монетизацию — преимущество усиливается экспоненциально. AIGC — отличный инструмент для «гонки за трендом»: он быстрее реагирует на вирусные темы. Владение аудиторией + скорость означает, что топы смогут захватывать большую долю внимания. Низкоуровневые, однообразные роли (редакторы, массовые рерайтеры, небольшие продакшны без уникальной авторской ценности) проще всего автоматизировать — их доля на рынке сократится. Следствие: «победители берут всё» — появление крайне крупных медиакомпаний и супервысокооплачиваемых звезд, в то время как длинный хвост мелких производителей окажется под давлением. Роль капитала может ослабнуть в классическом смысле: при низком барьере входа на уровнях генерации контента капитал уже не даёт такого преимуществa, как раньше. Зато капитал попрежнему нужен для масштабных платформ, инфраструктуры и маркетинга. Появится большая премия за «авторство» и бренд: те, кто обладает уникальной «тоновостью» и доверием, смогут монетизировать это сильнее — через подписки, мерч, эксклюзивный доступ. Платформы будут испытывать давление в части расчёта долей между алгоритмическим распространением и компенсацией авторов; экономические модели (делёж рекламы, подписки, микроплатежи) будут пересматриваться. Кто выиграет, кто проиграет Выигрывают: авторы с яркой индивидуальностью и преданной аудиторией; вертикальные «нишевые» лидеры; продюсерские центры, умеющие комбинировать человеческий креатив и AI в высоком качестве. Проигрывают: массовые «поточные» производители без авторской уникальности; часть традиционных вспомогательных профессий в креативной цепочке; медиакомпании, не сумевшие перестроить монетизацию. Дополнительные риски и вызовы Качество и доверие: лавина сгенерированного контента усложнит обнаружение оригинального авторства; качество может размыться. Право и этика: вопросы интеллектуальной собственности, права на образ, согласия и компенсации станут острыми. Потребуются новые нормы по маркировке и верификации AIGC. Регуляция и ответственность: кто отвечает за ошибки/вводящую в заблуждение информацию, сгенерированную AIагентом? Это требует как технических, так и юридических решений. Удержание аудитории: в диалоговых и утилитарных сценариях переключение между сервисами легко — значит, удержание станет более сложной задачей, чем в эпоху контента «скролла». В ближайшие 3–5 лет вероятно появление нового равновесия: сверххозяева рынка (суперзвезды и крупные мультиформатные компании), широкий слой устойчивых нишевых авторов и широкая масса автоматизированного «поточного» контента, который вытеснит многих мелких производителей. Это даст пользователям больше объёма и персонализации, но усилит концентрацию богатства и внимания. AIGC открывает большие возможности и новые риски. Позитивный сценарий — это индустрия с более высоким общим потолком ценности, где лучшие авторы и нишевые эксперты получают больше ресурсов для творчества. Негативный сценарий — чрезмерная концентрация, падение разнообразия и массовые потери рабочих мест в базовых ролях. Реальность, как обычно, будет смесью обоих. Главная задача для всех игроков — сохранять гибкость, защищать доверие аудитории и учиться работать в тандеме с инструментами генеративного AI.

16Апр

Пока Илон Маск отлучился в разъезды, судебный зал в Окленде стал площадкой для нового витка публичной драмы вокруг OpenAI. На слухах и домыслах о конфликте основателей появилась неожиданная конкретика: Сэм Алтман, впервые лично выступивший в процессе «Маск vs OpenAI», сообщил суду, что Маск когдато допускал идею передачи контроля над организацией своим детям. Эти слова мгновенно трансформировали корпоративный спор в остро персонализованную «историю наследования» — и вызвали шквал общественного интереса к вопросам власти, мотивации и корпоративной культуры в эпоху ИИ. Новый ракурс: не «коммерциализация = предательство», а борьба за власть Главный эффект от показаний Алтмана — смещение акцентов в нарративе. До сих пор общественный конфликт чаще описывали как столкновение идеологии: Маск обвинял OpenAI в отступлении от первоначальной некоммерческой миссии, а критики на его стороне видели профанацию идеалов. Алтман же в суде попытался перевернуть картину: по его версии, с самого начала среди ключевых акторов были те, кто стремился к концентрации власти в личных руках — и Маск в том числе. Упоминание о «передаче детям» — это не просто пикантная деталь. Это символ глубокого сомнения в искренности прежних речей о «глобальном благе» и о недопустимости монополии на AGI. Для многих слушателей мысль о наследственном контроле над организацией, которая по уставу задумывалась как щит от монополизации интеллекта, звучит как предательское переосмысление первоначальных ценностей. Слияние с Tesla и прагматические мотивы Алтман также рассказал о ранних переговорах и о том, что Маск обсуждал варианты интеграции OpenAI с Tesla — идею, которую Алтман и другие отвергали. С точки зрения последнего, миссия OpenAI и бизнесцели автомобильной корпорации могли вступать в прямое противоречие: исследовательская лаборатория прежде всего должна служить долгосрочным научным интересам и безопасности AGI, тогда как Tesla ориентирована на оперативную коммерческую и продуктовую отдачу. Алтман подчёркивает: это не идеологический «обман», а прагматическая реальность работы с деньгами и ресурсами. По его словам, Маск был осведомлён о переходе OpenAI к коммерческой модели — и в своё время поддерживал поиск источников финансирования. Именно этот момент усложняет однозначную формулу «неприбыливая миссия против жадного бизнеса»: решения принимались в условиях долговременных нужд по финансированию дорогостоящих исследований и вычислительных ресурсов. Культурный конфликт: «инженерная железная хватка» vs научноисследовательская среда Часть показаний была посвящена менеджменту и организационной культуре. Алтман критикует стиль Маска как непригодный для лаборатории, где ценится исследовательская свобода и долгосрочное размышление. Яркая инженерная иерархичность, режим «жёстких целей» и механистичная оценка сотрудников могли разрушить моральный тон и научную атмосферу. Это снова возвращает к классическому для Кремниевой долины конфликту: модели управления, которые работают в производственных и инженерных компаниях, часто уничтожают те особенности среды, которые необходимы научным прорывам. В суде Алтман прямо говорил о давлении и деморализации ключевых исследователей — аргумент, который резонирует и с показаниями других участников процесса. В зале прозвучали и более личные эпизоды: Алтман признался, что после событий 2023 года он всерьёз думал уйти из компании и перейти в Microsoft, но в итоге вернулся. Его образ в суде всё меньше похож на провозвестника утопии и всё больше — на исполнительного руководителя, балансирующего между идеалами и реальностью крупного технологического предприятия. Что дальше? Показания Алтмана не только подкрепляют часть обвинений Маска — они также вносят новые вопросы в обсуждение: кто и как должен контролировать организации, разрабатывающие AGI; какие механизмы ограничения власти нужны; и как отличать честные стратегические решения от попыток приватизировать общественные блага. В деле, где на кону не только корпоративные активы, но и социотехническая инфраструктура будущего, такие вопросу имеют большое общественное значение. Ближайшие слушания обещают быть драматичными: стороны готовятся к очередным перекрёстным допросам, и общество внимательно следит за тем, не превратится ли конфликт в прецедент регулирования власти в технологических гигантах эпохи ИИ.

16Апр

В середине мая 2026 года Google опубликовал отчёт, который, по словам компании, впервые даёт прямое подтверждение того, что преступные хакерские группы начали использовать большие языковые модели (LLM) для самостоятельного поиска и эксплуатации нулевых дней. Этот инцидент переводит обсуждение «AIавтоматической разведки уязвимостей» из разряда теории в реальность и ставит новые, острые вопросы перед всей индустрией кибербезопасности. 12 мая 2025 года (по информации в отчёте Google Threat Intelligence Group, GTIG) исследователи обнаружили подготовленный злоумышленниками Pythonскрипт, созданный с помощью большой модели ИИ. Скрипт использовал ранее неизвестную уязвимость в «широко применяемом opensource инструменте для управления вебсистемами», позволяющую обходить двухфакторную аутентификацию (2FA). Для успешного доступа злоумышленникам всё ещё требовались валидные логин и пароль, но при их наличии — прямой путь в административную панель. Google успел уведомить разработчиков уязвимого ПО, и патч был выпущен до возникновения реального ущерба. Но ключевой удар по спокойствию специалистов нанесён не тем фактом, что атаку удалось отразить, а тем, что сам механизм — автоматизированный поиск логических, «семантических» дефектов в коде — действительно использовал возможности больших моделей. Исследователи GTIG поясняют, что в обнаруженном коде были характерные «отпечатки» ИИгенерации: избыточные обучающие docstringкомментарии, «учебный» формат кода, детальное меню справки и даже вымышленные метрики — например, «галлюцинированный CVSSрейтинг», которого не существует в реальной практике оценки уязвимостей. Бывший руководитель кибербезопасности NSA Роб Джойс отметил, что ИИкод не заявляет о себе прямо, но такие косвенные признаки дают веские основания полагать об участии модели. Google не назвала модель — лишь отметила, что это с высокой вероятностью не их собственный Gemini и не Anthropic Mythos. Уязвимость описана как «дефект в семантике высокого уровня» — ошибка проектной логики, связанная с жёстко зашитым в 2FA предположением о доверии. Традиционные сканеры и автоматические инструменты плохо ловят такие ошибки, потому что они требуют понимания намерения и смысла кода — область, где LLM показывают свои сильные стороны. Это именно тот сценарий, которого эксперты боялись: ИИ не просто ускоряет подбор паролей, он находит логические противоречия, которые люди и классические инструменты пропускали годами. Отчёт Google выходит на фоне громкого появления модели Anthropic Mythos, о которой в индустрии говорят как о мощном инструменте для поиска нулевых дней — Anthropic утверждала, что Mythos нашёл тысячи уязвимостей в различных ОС и браузерах. В ответ Anthropic ограничила доступ к Mythos и организовала инициативу Project Glasswing для совместной работы с крупными техногигантами (подробнее: Anthropic — Glasswing). Параллельно OpenAI анонсировала специализированную модель для киберзащиты — GPT5.5Cyber — доступную только доверенным защитным структурам. Тем не менее Google подчёркивает: для реальных злоупотреблений не требуется самый мощный Mythos — уже доступные коммерческие модели способны помочь преступникам находить уязвимости и готовить эксплойты. Отдельно в отчёте описано Androidвредоносное ПО PromptSpy, которое вызывает API Gemini для анализа текущего экрана устройства и самостоятельно принимает решения о дальнейших действиях. Среди опасных возможностей — навигация по интерфейсу, перехват биометрических данных, воспроизведение PIN/узоров, блокировка удаления приложения (перекрытие кнопки «Удалить» прозрачной накладкой) и динамическая замена инфраструктуры управления (смена APIключей и ретрансляторов в режиме выполнения). Google уже отключил связанные активы и не нашёл PromptSpy в Google Play, но сама концепция автономных ИИвредоносов вызывает серьёзное беспокойство. Эксперты говорят, что «окон защиты», которое дают поэтапные релизы мощных моделей и международные соглашения, становится всё меньше — по словам представителей Anthropic, это окно измеряется месяцами, а не годами. США предпринимают попытки ввести предварительную оценку моделей перед публичным выпуском (см. публикации о правительственных инициативах и переговорах с крупнейшими компаниями), но согласованность действий пока далека от идеала (NYT о расследовании). Что делать организациям прямо сейчас Проверить критичные компоненты, особенно инструменты управления, которые полагаются на 2FA — искать не только уязвимости на уровне аутентификации, но и логические допущения, «жёстко» зашитые в коде. Усилить мониторинг признаков ИИгенерации атакных артефактов (нетипичные docstring, «учебные» комментарии, несуществующие метрики, стандартизированный стиль кода). Ускорить процесс выпуска и применения патчей, пересмотреть SLA на реакции по уязвимостям; корректировка KPI для команд безопасности (время реакции, покрытие патчами). Ограничивать и контролировать использование API ключей ИИ в приложениях, логировать доступ моделей и аномалии в поведении клиентов. Уделять внимание защите учётных данных: многофакторность не замещает необходимость в контроле над утечками паролей и учётных данных. Отчёт Google — тревожный сигнал: исследуемый сценарий «ИИпомощи» злоумышленников перестал быть гипотетическим. Пока ИИ усиляет обе стороны «гонки вооружений», скорость использования моделей злоумышленниками растёт быстрее, чем способность защитников полностью закрыть накопившиеся уязвимости. На ближайшие годы приходится смоделировать период «перехода», когда риски ещё высоки, а выгоды от ИИ ещё не перевесили угрозы. Для организаций это означает — действовать сейчас, а не откладывать реформы и усиление практик безопасности.

16Апр

Все говорят об «решениях на основе ИИ» как о более объективных и рациональных — но так ли это? ИИ не избавлен от человеческих предвзятостей — он их наследует и во многих случаях усиливает. Классическая экономическая наука и поведенческая финансовая теория расходятся в оценке рациональности человека. Поведенческая школа, опираясь на работы Канемана, Талера и др., показывает системные отклонения в суждениях и решениях — а эти системные сдвиги легко предсказуемы и воспроизводимы. Именно эти «поведенческие паттерны» и становятся «уроками», которые модели ИИ учат у людей. Анкоринг (эффект якоря) Сущность: случайный или нерелевантный ориентир смещает оценки. Наблюдение: поведение моделей различается. В тестах GPT и Gemini демонстрировали устойчивость к якорям, Claude — был немного восприимчив, LLaMA — проявлял анкоринг, близкий к человеческому. Чрезмерная уверенность (Overconfidence) Сущность: люди дают слишком узкие интервалы доверия и переоценивают точность своих прогнозов.Наблюдение: Claude чаще даёт широкие интервальные оценки (более «смирёнен»), GPT — средний уровень, а Gemini — склонен к узким (чрезмерно уверенным) интервалам. Нежелание проигрыша (Loss aversion) Сущность: потери ощущаются сильнее, чем равные по величине выигрыши.Наблюдение: GPT действует более «математически рационально», ориентируясь на ожидаемое значение; Claude иногда демонстрирует поведение, близкое к потереантимотивации; Gemini заметно «боится» рисков — ещё более, чем средний человек. Эффект фрейминга (Framing) Сущность: вариант формулировки (позитивная или негативная подача) меняет выбор.Наблюдение: почти все тестируемые LLM сильнее людей чувствительны к формулировке запроса — отсюда и популярность «prompt engineering»: задав фрейм, можно существенно сместить результат. Эффект стада (Herd effect / алгоритмический резонанс) Сущность: люди ориентируются на поведение большинства.Наблюдение: у ИИсистем проявление «стада» может быть ещё более жёстким: многие модели обучаются на схожих данных и подчас сходятся к одинаковым реакциям, что при массовом развертывании создаёт каскадные ошибки (например, навигация, которая одновременно перенаправляет тысячи машин на одну дорогу). Оптимистичный сценарий: по мере эволюции моделей статистические выводы (вероятностные оценки) становятся точнее — и это так. Пессимистичная цель: поведенческие и предпочтительные искажения (оценка рисков, моральные и ценностные суждения) часто не уменьшаются, а иногда и усиливаются. Главная причина — RLHF (обучение с подкреплением на основе человеческой обратной связи): модель усваивает манеры и предпочтения людей вместе с их биасами, а затем их масштабирует. Кроме того, явление «схлопывания предпочтений» (preference collapse) означает, что при донастройке модель «подхватывает» доминирующие, частые реакции и подавляет редкие, но важных отличающихся голосов. Практические советы: как разумно использовать ИИ при принятии решений Не воспринимайте ИИ как полностью объективного советчика. Для чисто логических задач (математика, статистика) ИИ можно доверять больше; для решений, связанных с риском, этикой или предпочтениями — применяйте скепсис и проверку. Используйте ИИ как «песочницу поведения». Модели полезны для симуляций: тестируйте, как разные аудитории отреагируют на кампанию, цену или продуктовую концепцию. Защититесь от усиления собственных предубеждений. ИИ склонен «поддакивать» пользователю. Для ключевых решений привлекайте несколько моделей с разной архитектурой (multimodel check) и независимые человеческие ревью. Формулируйте запросы так, чтобы заставить модель мыслить «критически». В prompt включайте требование «перечислите возможные когнитивные ошибки, проверьте решение с противоположной точки зрения», просите модель приводить контраргументы и альтернативные сценарии. ИИ не нейтрален по определению — он наследует и реплицирует поведенческую «эпистему» общества, а иногда и усиливает её. Разумное и безопасное использование ИИ требует осознанности: четкого разграничения задач, где машина действительно лучше человека, от тех, где человеческая осознанность и ценностные суждения незаменимы; использования моделей как инструментов симуляции, а не окончательных арбитров; и явного внедрения процедур кросспроверки и аудита.

Если у вас есть инновационная идея, мы будем рады реализовать ее для Вас!

Специалисты нашей кампании и наши разработки для вас!