Новости

Социальные сети

Узнайте больше о рынке It и новейших технологиях.
СТАТЬИ
16Апр

Пик туристического сезона — серьёзный стресс для многих работающих людей: как спланировать маршрут, как избежать толп и при этом получить максимум впечатлений при ограниченном времени. В последние годы на этот запрос ответ дал не человекгид, а набор AIсервисов — от больших моделей для планирования поездок до «умных» очков с дополненной реальностью. За пару лет AI превратился из экспериментального помощника в повседневный туристический инструмент — и именно экскурсоводы оказались самыми уязвимыми. Появление крупных туристических AIпродуктов уже заметно изменило поведение пользователей. В отчёте платформы Tongcheng отмечается: пользователи их модели DeepTrip выросли более чем на 60% по числу, а брони через неё — почти на 80% в годовом выражении. Это означает, что всё больше людей доверяют моделям не только совет по отелю, но и полноценную систему планирования поездки. AI теперь сопровождает путешествие во всех трёх фазах: до поездки — быстрый генератор маршрута с подбора билетов и гостиниц; в дороге — навигация, распознавание объектов, перевод, мгновенные пояснения; после — автоматическая редактура фото, создание постов, отчётов и видео. Истории реальных людей иллюстрируют, как это работает. Джан Ян (江阳) надевает AIочки и получает прямо в поле зрения навигацию и подсказки: где припарковать, как найти арендованную машину, распознавание экспонатов в музее с озвучкой и подсказками. Ли Ли (莉莉) использует приложения для распознавания фресок и скульптур в Юнган, предпочитая мгновенные пояснения искусственного интеллекта живому гиду, когда качество экскурсии в переполненных группах от случая к случаю. «AIочки» — массовый шаг к персональному гиду AIочки — не просто модная новинка: согласно исследованию более половины пользователей умных очков используют их именно для поездок. На рынке сегодня есть разные варианты: устройства ориентированы либо на перевод и офисную работу, либо на универсальные сценарии поездок (Quark, ROKID и др.). Несмотря на технологические ограничения — вес, автономность, проблемы с ярким солнцем и утечкой звука — пользователи уже отмечают практическую пользу: «ошибочные» советы и мелкие лаги не перекрывают удобства моментального доступа к информации. AIочки превращают любой городской поход в персональную экскурсию: распознавание экспоната, исторический контекст, локальные «пасхалки» — всё доступно мгновенно, без необходимости ждать гида или читать длинные таблички. При этом у повсеместного внедрения есть и обратная сторона. Частые ошибки и устаревшие данные — не редкость. В одном из примеров пользователь по рекомендациям AI пришёл в ресторан, который оказался закрыт на реконструкцию; модель извинилась и предложила альтернативы, но раздражение уже было. Такие случаи напоминают, что автоматические решения без надёжной актуализации данных остаются уязвимыми. Статистика по внедрению «умных» технологий в туризме внушительна: по данным Китайского института туризма, в 2025 году рынок «умного туризма» достиг 480 млрд CNY, на AIинвестиции приходится 57% от этого объёма; более 90% 5Aаттракций и свыше 70% 4Aплощадок уже внедрили AIгида или интеллектуальные сервисы. Потребительская осведомлённость превышает 90%, проникновение использования близится к 80%, а около 22.5% пользователей — регулярные активные пользователи. Это ведёт к трансформации ролей: традиционные гиды не обязательно полностью исчезнут, но их функции перераспределяются. Появляются новые профессиональные ниши — кураторы цифрового контента, операторы ARэкскурсий, модераторы AIпутеводителей, специалисты по локализации и верификации данных для моделей. Человеческий фактор остаётся важен там, где нужна эмпатия, глубокая интерпретация или нетипичные ответы. AI сделал туристическую информацию доступной и персонализованной в режиме реального времени — и в пиковые сезоны это часто оказывается важнее традиционной экскурсионной услуги. Экскурсоводы оказались первыми, чьи функции массово заменяются автоматизированными решениями, но картина полноценна не «исчезновением профессии», а её трансформацией: часть задач автоматизируется, часть остаётся за людьми, а часть даёт начало новым профессиям. Ключевые вызовы на ближайшие годы: обеспечить качество и актуальность данных у AIсервисов; сохранить в путешествиях место для спонтанности и человеческого контакта; выстроить новые модели занятости и переподготовки для тех, чьи функции смещаются в сторону автоматизации. Путешествие под контролем AI — это уже не футуризм, а повседневность. Вопрос в том, как сделать так, чтобы технология служила не только удобству, но и полноте переживаний, а люди, чьи навыки раньше были незаменимы, смогли адаптироваться и найти своё место в новой экосистеме туризма.

16Апр

В 2026 году крупные языковые модели перестали быть просто технологией — они стали фактором, который стирает границы между пользовательскими (To C) и корпоративными (To B) продуктами. Два разных коммерческих и организационных начала — поток массового спроса и глубинная корпоративная надёжность — теперь переплетаются. Это не только стратегия отдельных компаний вроде OpenAI и Anthropic, это вызов для организационной архитектуры, культуры и управления талантами. Исторически To C — скорость, вирусность и масштаб пользователей. To B — глубина, предсказуемость дохода и требования по безопасности и интеграции. С приходом больших моделей ситуация меняется по двум причинам: Технология даёт и тот, и другой эффект: To Cприложения быстро наращивают охват и собирают данные, нужные для улучшений; To Bрешения привлекают платежеспособных клиентов и приносят устойчивый ARR. Давление экономической эффективности: масштабные Cсервисы требуют огромных затрат на инфраструктуру; превращение пользовательского потока в платёжную модель Bуровня становится необходимостью для выживания. В результате крупные игроки стремятся одновременно удерживать обе оси: OpenAI масштабирует корпоративные предложения, Anthropic из Bкорня пробует выйти на Cрынок. Это не противоречие — это стратегическое переплетение. Переход к совместимости сопряжён с реальными рисками. Истории Amazon, Microsoft и GE показывают, что попытки «перепрыгнуть» в другую парадигму без перестройки культуры и процессов часто заканчиваются болезненными потерями. Типичные ловушки: недооценка сложности Bинтеграций у To C команд; потеря скорости и инновационной гибкости у To B команд при попытке стать продуктовоориентированными; конфликт KPI и мотиваций, когда короткие циклы экспримента рушат долгосрочные корпоративные сервисы. Успешные примеры (в тексте — ByteDance, Alibaba, Google и другие) демонстрируют общую формулу: разделение фронтов с объединённой инфраструктурой внизу. Ключевые практики: BUизоляция + автономия фронтенда Отделять продуктовые команды (To C) и клиентские подразделения (To B) как отдельные бизнесюниты с собственными метриками и полномочиями. Такой подход сохраняет скорость и фокус. Shared Service Platform (единственная «подводная» платформа) Общая техническая база (рекомендация, NLPсервисы, инфраструктура) даёт To B быстрое «выходное плечо», а To C — доступ к корпоративным возможностям без дублирования усилий. Управленческая философия Context, not Control Делиться контекстом и целями (OKR, прозрачность), а не жёстко контролировать процессы. Это позволяет разным культурам сосуществовать, сохраняя целостность организации. Внутренний рынок талантов Перемещения сотрудников между To C и To B командами (внутренние трансферы) переносят навыки пользовательского дизайна и аналитики в корпоративные продукты, и наоборот. «Двойная спираль» — это не абстракция, а практическая архитектура выживания и роста в AIэпоху. Тот, кто сможет выстроить совместимый технологический базис, поддержать его гибкой организацией и культом прозрачных целей, получит преимущество, которое в ближайшие годы определит лидеров рынка. В конце концов, AIинструменты — лишь мост; ценность создаёт не техника, а то, как люди и организации научатся через неё взаимодействовать.

16Апр

В интервью InfoQ Зико Колтер — директор департамента машинного обучения КарнегиМеллон и председатель комитета по безопасности OpenAI — дал системное объяснение, как внутри компании проверяют модели перед выпуском и почему сейчас главное не «научить модель не врать», а сузить и держать под контролем расширяющуюся поверхность атак, возникающую вместе с агентными (agentic) системами. Kolter входит в совет OpenAI и возглавляет Safety & Security Committee (SSC). Это надзорный орган: он не пишет код, но проверяет документацию, тесты и оценки команд безопасности. Перед крупными релизами SSC организует встречи, на которых команды (preparedness, alignment, model policy и др.) представляют результаты тестирования, внешние оценки и планы по защитам. По итогам комитет может потребовать дополнительной валидации или отсрочки релиза. OpenAI использует публичный Preparedness Framework — набор требований и порогов для моделей, особенно в отношении «катастрофических рисков» (bio, cyber, selfimprovement). Обсуждение рисков переходит от «что делает модель» к «что делает экосистема моделей»: агентные системы, интеграция с инструментами и предоставление реальных привилегий расширяют возможности злоупотреблений. Модель, интегрированная с инструментами (интернетдоступ, исполнение команд, доступ к ключам), делает классические проблемы безопасности гораздо серьёзнее — один удачный prompt injection вместе с правами доступа может привести к утечке или исполнению команд. Kolter предлагает делить риск на четыре класса: Ошибки модели (галлюцинации, неверные выводы, prompt injection как частный случай). Злоупотребления (модель думает хорошо — и это может помочь злоумышленникам). Социальноэкономические эффекты (влияние на рабочие процессы, доверие, поведение людей). Сценарии потери контроля (selfimprovement, автономное расширение возможностей). Более мощные модели не становятся автоматически более безопасными. Чтобы повысить безопасность, нужны целенаправленные технические меры: внешние классификаторы, мониторинг, многослойные защитные механизмы, специальные датасеты для обучения на безопасность. Многие улучшения в безопасности — результат инженерной работы, дополнительной подготовки и модульных защит, а не просто увеличения размера модели. Защита строится многослойно: inputклассификаторы, инструментконтейнеры, outputфильтры, поведенческий мониторинг аккаунтов и оперативная безопасность. Это классическая «швейцарская сырная» модель — отверстия на разных слоях не должны совпадать. Атаки тоже стали сложнее: злоумышленники тестируют границы классификаторов, комбинируют jailbreak для модели и обход внешних детекторов; часто такие атаки требуют большого количества запросов, которые можно детектировать. Агент, который читает внешние данные и принимает решения, потенциально может получить вредоносные инструкции из этих данных. Если у агента есть привилегии (почта, APIключи, доступ к БД), inject может привести к утечке или выполнению команд. Поэтому при проектировании агентов важны: строгое разграничение прав, песочницы, проверка доверия к источникам и анализ того, какие привилегии действительно необходимы. Kolter и коллеги внесли в сообщество методы систематического поиска jailbreak (например, GCG), показавшие, что некоторые атаки могут быть «переносимыми» между моделями. В ответ индустрия вводит внешние классификаторы, режимы рассуждения (reasoning models) и другие слои, которые усложняют прямые атаки. Kolter также считает, что механизмная интерпретируемость (mechanistic interpretability) получает новое дыхание: автоматизированные средства и агенты позволяют масштабно искать и объяснять внутренние механизмы модели, что делает исследования менее «адхокными» и более системными. Глобально появляются институты и практики: preparednessфреймворки у крупных лабораторий, национальные AIинституты, сотрудничество исследователей и регулирующих органов. Kolter критикует ярлыки «ускорители» vs «пессимисты»: большинство исследователей занимают прагматичный центр — поддерживают развитие, но требуют серьёзного внимания к безопасности. Kolter ожидает, что системы станут в целом безопаснее: появляются более зрелые слои защиты, улучшенные процессы релиза и подготовленности. Однако риск растёт параллельно с расширением «контроля» моделей — больше прав, больше интеграций, больше автоматизации. Поэтому задача — обеспечить, чтобы темп наращивания защитных мер хотя бы соответствовал темпу расширения возможностей моделей. Оригинальное видео беседы: YouTube.

16Апр

Международное энергетическое агентство (IEA) в своем специальном отчете «Энергия и ключевые вопросы ИИ» предупреждает: в ближайшие пять лет мировое энергопотребление датацентров может удвоиться. Это не просто цифры — это масштабное перераспределение инвестиций, логистики и энергетической политики, которое заставит технологические компании, производителей оборудования и энергетиков искать новые варианты совместной работы. IEA прогнозирует рост годового потребления электроэнергии датацентрами с примерно 485 TWh (2025) до ~950 TWh к 2030 году — около 3% от глобального спроса на электроэнергию. AIспециализированные датацентры вырастут ещё быстрее: с ~155 TWh (2025) до примерно 465 TWh к 2030му — более чем втрое. 2026–2030 гг. потребуют инвестиций порядка 3,9 трлн долларов в инфраструктуру датацентров и смежные секторы. Причины роста двойные и складываются вместе. Вопервых, масштаб расширяется: компании наращивают парки GPU/ASIC, подписывают PPA с возобновляемыми источниками и вкладывают сотни миллиардов долларов в вычислительную инфраструктуру (в 2025м крупные технологические игроки уже потратили свыше $400 млрд; в 2026м ожидается рост до ~$715 млрд). Однако этот рост сдерживают узкие места: дефицит высокоскоростной памяти, очереди на подключение к электросетям (в отдельных регионах — 5–10 лет) и цепочки поставок. Вовторых, растёт плотность мощности на единицу оборудования: если в 2020 году «типичный» фрейм имел мощность порядка 13 кВт, то современные архитектуры (Blackwell) уже достигают ~130 кВт/стойка, а перспективные проекты (Rubin) нацелены на 600 кВт/стойка и выше — вплоть до 1 МВт/стойка в более далёкой перспективе. То есть даже без масштабного увеличения площади датацентров суммарный спрос энергоёмкости увеличивается за счёт плотности оборудования. Один источник в одиночку не справится. IEA ожидает комбинированную модель снабжения к 2030 году: около 1/3 — возобновляемые (примерно 360 TWh), ~30% — природный газ (около 340 TWh, рост примерно вдвое по сравнению с сегодняшним уровнем), а доля ядерной энергии вырастет с ~75 TWh до ~120 TWh. Любопытная тенденция — технологические компании всё активнее переходят от чистого потребления к частичному производству электроэнергии: строительство локальных газовых турбин (включая аэродериватные установки) в кластерах датацентров позволяет сократить время ожидания подключения к сети и повысить устойчивость энергоснабжения. Также заключаются долгосрочные соглашения на покупку энергии от существующих АЭС (PPA на 7,1 GW по состоянию на отчёт). Возобновляемые источники остаются «витриной» устойчивости, но их интервальность делает невозможным полную автономию без гибких резервов, хранения и/или долгосрочных контрактов на базовую генерацию. На первый взгляд, AI становится всё более энергоэффективным: единичный текстовый запрос требует порядка 0,24–0,34 Wh. Но структура использования меняется — видеогенерация, сложные задачи вывода и многократные вызовы в рамках AIагентов тратят в сотни и тысячи раз больше энергии, чем простые текстовые запросы. Это классический случай парадокса Джевонса: повышение эффективности снижает цену использования вычислений и приводит к бурному росту объёма операций, поэтому суммарное потребление растёт. Отдельная проблема — несоответствие энергоэффективности и прикладной ценности: более «тяжёлые» модели не всегда даёт существенно лучший практический результат в рутинных задачах, но по инерции часто используются, хотя меньшие модели могли бы сократить энергозатраты. IEA оценивает совокупные инвестиции в инфраструктуру датацентров и сопутствующие секторы в ~$3,9 трлн за 2026–2030 гг. В выигрыше окажутся производители тяжёлых газовых турбин, поставщики трансформаторов и решений для распределения мощности, производители систем жидкостного охлаждения, накопителей энергии и компаний, выпускающих силовую электронику. Уже сегодня производители турбин и сетевого оборудования расширяют производственные мощности и отмечают рост заказов и ценовой дисциплины вследствие узких мест в цепочке поставок. IEA ставит перед нами чёткий выбор: путь, где цифровая революция поумному интегрируется с энергетикой, или сценарий, в котором спрос на электроэнергию для ИИ становится серьёзным источником напряжения для сетей и рынков. Решение будет комплексным: сочетание возобновляемой генерации, газа, ядерной энергии, локальных мощностей, хранения и — что не менее важно — широкого применения AI для оптимизации энергосистемы. Политика, инвестиции в инфраструктуру и развитие цифровых компетенций в энергетике определят, насколько устойчивым и управляемым окажется этот рост.

16Апр

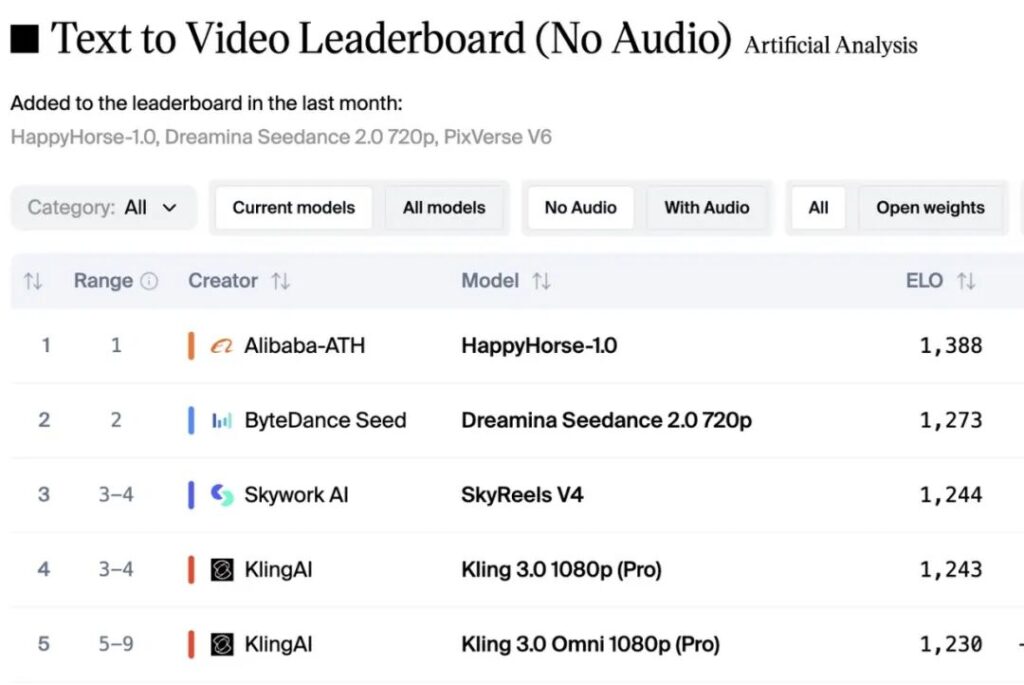
С апреля 2026 года видеомодели вновь стали одной из самых перегретых веток в AI — на старте подъёма оказались и гиганты, и стартапы. Китайские разработки (HappyHorse от Alibaba, Seedance от ByteDance, Kling от Kuaishou и др.) демонстрируют впечатляющие слепки качества и вирусный потенциал, но уход OpenAI с продуктом Sora поставил перед рынком грубую реальность: эффект «вау» не равен устойчивой прибыли. Главный вопрос для участников — как снизить операционные расходы, решить вопросы лицензирования и встроиться в производственные цепочки клиентов так, чтобы видеогенерация приносила реальный доход. На ранге blindbenchтестов (Artificial Analysis) лидируют три китайских игрока: Alibaba (HappyHorse1.0), ByteDance (Seedance 2.0) и Kuaishou (Kling). Но за рейтингами стоит разная бизнеслогика: Kuaishou (可灵) — акцент на коммерциализации. По открытым сообщениям, в декабре 2025го был месячный доход свыше $20 млн; ARR по состоянию на январь 2026 превысил $300 млн. Плюс есть встроенная экосистема создателей и большой объём пользовательского трафика — это реальный moat для массового потребления. ByteDance (Seedance) — акцент на «выход в массы» и распространение через экосистему. Seedance породил вирусные ролики с десятками миллионов просмотров, что даёт огромный охват и приток пользователей, но и сталкивается с серьёзными юридическими спорами (авторские права, использование лиц знаменитостей), которые вынудили приостановить глобальный релиз. Alibaba (HappyHorse) — демонстрирует выдающиеся показатели по слепым тестам и некоторую технологическую изысканность (высокая согласованность кадров, хорошая синхронизация звука), при этом у Alibaba нет «своего» крупного социального контентапула — компания ориентируется на бизнесклиентов: ecommerce, реклама, корпоративные материалы. Важно: в тестах качества разрыв между лидерами невелик, а ценность в бизнесе определяется не только визуальной реализацией, но скоростью, стоимостью, стабильностью, юридической безопасностью и экосистемной интеграцией. Во второй волне находятся стартапы, готовящие IPO или наращивающие продуктовые ниши: Vidu с фокусом на «referencetovideo» и миромоделью движения; PixVerse (爱诗科技) — платформа для создателей; MiniMax и Kunlun/ SkyReels — с разной продуктовой привязкой (корпоративные видео, внутренняя контентсеть, игровая продукция). Общее для второй волны — сильная вера в потенциал, но слабая гарантия окупаемости: высокие capex и opex на вычисления, неопределённость монетизации и риски юридических претензий по IP. Закрытие Sora от OpenAI стал жёстким напоминанием: демонстрационные возможности и техническое превосходство не равны экономической устойчивости. Открытые данные указывают на шоковую разницу: до закрытия Sora ежедневные расходы на inference оценивались в десятки миллионов долларов, а жизненный доход — в сотни тысяч. Это — о том, как быстро «вау» потребляет ресурсы. Факторы, серьёзно давящие на ROI: Высокая стоимость вычислений: генерация многокадрового, синхронизованного с аудио видео — это сотни тысяч токенов и большие GPUсессии. Масштаб и очереди: даже платные пользователи сталкиваются с длительным ожиданием; полный доступ часто доступен лишь крупным клиентам по дорогим контрактам. Лицензирование и персонализация: создание роликов с лицами знаменитостей, узнаваемыми брендами или охраняемым контентом приводит к рискам судебных исков и необходимости сложных договоров. Цена восприятия: пользователи ожидают дешёвых и быстрых генераций; повышение цен быстро снижает спрос и ведёт к росту оттока. Эти реалии объясняют, почему многие компании уже поднимают цены, вводят корпоративные пороги входа и ограничивают бесплатный доступ — иначе модель не масштабируется по сбалансированной экономике. Кто выиграет в следующем цикле Победителями станут те, кто сумеет не только показывать «красивые» demo, но и: Интегрировать модель в бизнеспроцессы клиентов (ecommerce, реклама, игровая и киносъёмочная цепочки), где можно конвертировать экономию времени в реальную денежную выгоду. Снизить себестоимость вывода: оптимизация inference, кеширование, сокращение количества кандидатов в генерации, адаптация разрешения/качества под реальные сценарии. Решить вопросы лицензирования и управления правами: прозрачные модели оплаты актёров/правообладателей, механизмы отзыва и контроля использования образов. Предоставить экосистему и каналы дистрибуции: у ByteDance и Kuaishou очевидное преимущество; у Alibaba — корпоративный доступ и интеграции в облачные сервисы. Видеомодели остаются одним из самых потрясающих приложений генеративного AI: они быстро производят «вау» и способны переформатировать медиапроизводство. Но переход от «демонстрации» к «бизнесу» требует решения непростых инженерных и коммерческих задач: балансирования затрат на inference, юридической выверки использования материалов и построения каналов монетизации. В 2026м году соревнование уже выходит в глубокую воду — побеждают не только лучшие в слепых тестах, а те, кто сумеет сделать сервис дешевым, законным и полезным в масштабируемой бизнеслогике.

16Апр

Shopify запустил интеграционный коннектор — AI Toolkit — который позволяет продавцам подключать к панели управления сторонние AIинструменты (Claude Code, Codex, Cursor и др.) и не просто получать подсказки, а поручать им напрямую выполнять задачи в бэкенде магазина: SEOаудит и массовое обновление метаданных, мониторинг конкурентов, изменение цен и скидок, управление запасами, правки в теме и даже автоматическое выкладывание страниц. Это уже не ассистентсоветчик — это исполнитель, имеющий доступ к операционной логике магазина. Как это работает (кратко) Продавец подключает к панели Shopify выбранный AIинструмент через AI Toolkit. Инструмент получает ограниченные APIправа (короткоживущие токены, стандартизированные интерфейсы) и может читать/модифицировать данные магазина в рамках предоставленных полномочий. Команда или владелец даёт «команду» в естественном языке — например, «оптимизируй SEO для всех товаров» — и AI сам делает аудит, генерирует метаданные и при необходимости массово обновляет карточки товаров. Некоторые действия реализуются полностью автоматически; для особенно критичных шагов могут оставлять ручную валидацию, но по умолчанию Toolkit упрощает полный цикл «анализ → действие». Конкретные сценарии, которые уже функционируют Автоматический SEOаудит: скан по всем товарам, выявление пустых метатегов, генерация и массовая подстановка заголовков и описаний, заполнение Altтегов. Массовые языковые локализации: генерация страниц на нескольких языках и автоматическая публикация в тему. Ценообразование и акции: массовая установка скидок, пометки «low stock», массовое обновление коллекций. Правка кода темы: автогенерация изменений и прямое внесение в файлы шаблона (что в одном из кейсов привело к исчезновению баннера на главной странице и потере заказов). Плюсы: почему многие продавцы уже включают AI Toolkit Огромная экономия времени и средств для рутинных и объёмных задач (SEO, локализация, массовые правки). Снижение потребности в дорогих внешних подрядчиках и платных плагинах (экономия месячных платежей $200–$500). Размывание барьеров технического входа: продавцу не требуется глубокий стек навыков для быстрого масштабирования витрины и маркетинга. Быстрая многовыборная адаптация: перевод, A/Bтесты контента, массовые теги и т.п. выполняются в разы быстрее, чем вручную. Минусы и риски: почему многие относятся к Toolkit с осторожностью Нет универсального механизма отката: массовые изменения сразу применяются в магазине и сложно вернуть всё назад одной кнопкой. Возможность ошибок, которые негативно влияют на трафик, конверсию и продажи (неправильные метаданные, некорректные цены, баги в шаблоне). Чёрный ящик решений: продавцу не всегда ясно, какие именно данные и в каком объёме были изменены. Риски блокировок и санкций: массовые SEOправки или некорректные атрибуты могут вызвать падение ранжирования в поиске или проблемы с платёжными/маркетплейс интеграциями. Безопасность и ответственность: хотя Shopify ограничивает доступ через стандартизованные интерфейсы и короткоживущие токены, критичные операции всё же требуют человеческой валидации. Практические рекомендации продавцам Не выполнять массовые операции «вслепую». Сначала попросите AI сгенерировать отчёт и просмотрите изменения до их применения. Всегда делайте бэкап: экспортируйте данные (CSV, темы) перед массовыми правками. Начинайте с тестовой подгруппы товаров: A/Bподход к обновлениям минимизирует риски. Настройте роль/права: давайте AIинструментам минимально необходимые права; критичные операции — с доп. подтверждением человека. Инструмент мониторинга: внедрите слежение по ключевым метрикам (трафик, CTR, позиции в выдаче, конверсия) и откатывайте изменения при ранних признаках ухудшения. Рассмотрите услуги «AIуправления» у сторонних провайдеров: агентства, которые будут контролировать и валидировать работу Toolkit вместо вас. Последствия для рынка и экосистемы Техническое выравнивание: базовые технические преимущества перестают быть дифференциатором; конкуренция смещается в плоскость коммерческой стратегии, качества продукта и брендинга. Давление на SaaSплагинрынок: массовая автоматизация рутинных функций (SEOплагины, bulkedit, переводчики) может привести к снижению спроса на часть платных расширений. Новые сервисы: появится спрос на AIоператоров, мониторингсервисы, инструменты валидации контента и «AIохрану» магазина (audit & rollback). Рост «один человек — несколько сайтов»: снижение порога входа приведёт к появлению множества мелких независимых магазинов; выиграют те, кто лучше выстроит коммерческую стратегию и логистику. Shopify усиливает барьер для конкурентов: интеграция AIфункций на уровне платформы повышает привлекательность экосистемы для продавцов. Shopify сделал очередной шаг к «демократизации» ecommerce: рутину можно поручить AI, масштабирование и локализация стали доступнее. Но «открытие задней двери» для AI одновременно подчёркивает, что технологии меняют не только инструменты, но и модели рисков и ответственности. Для успешной работы с AI Toolkit критичны процессы бэкапа, валидации, мониторинга и — что важнее — понимание долгосрочной коммерческой логики: инструменты могут выполнять операции, но стратегию и бренд остаётся за человеком.

16Апр

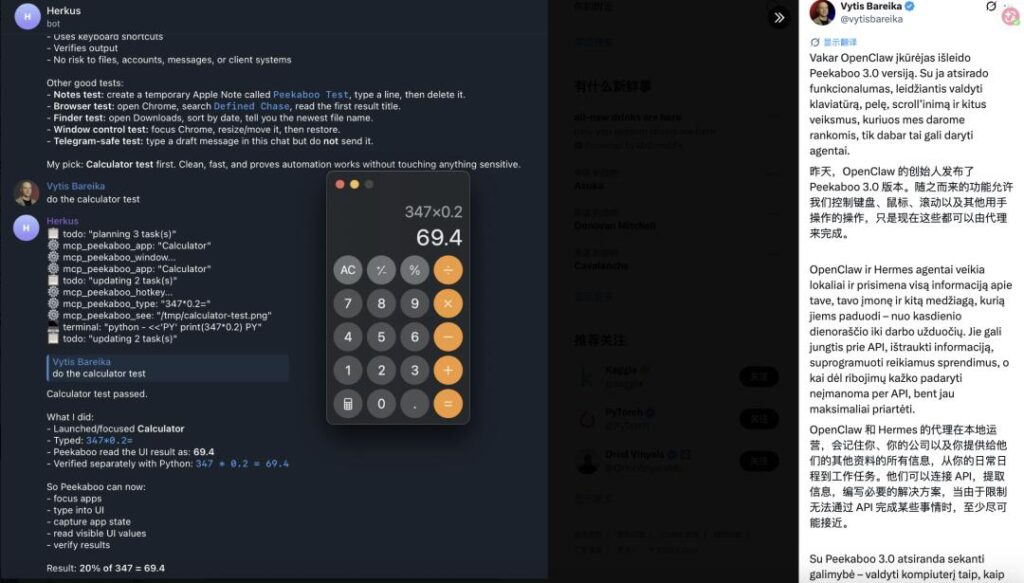
OpenClaw выпустил крупное обновление своего инструмента Peekaboo (v3), которое можно считать важной вехой в развитии «агентовисполнителей»: теперь агентам не нужно ограничиваться лишь симулированием действий — они умеют видеть экран и действительно управлять macOS как человек. Автор проекта — Peter, «отец лобстера», — реализовал набор возможностей, которые превращают Peekaboo из вспомогательного глаза в полноценные «глаза + руки» для AIагентов. Что нового в Peekaboo v3 Пиксельные скриншоты и распознавание UI: Peekaboo снимает как полноэкранные изображения, так и пиксельноточные фрагменты, а также получает информацию о каждом UIэлементе (позиция, тип, label). Полный набор действий «руки»: клик, ввод текста, нажатия горячих клавиш, скролл, draganddrop, переключение окон и рабочих столов, взаимодействие с Dock и системными диалогами. Натуральный язык как интерфейс команды: агент принимает задачи в свободной речи и выполняет цепочки действий на экране. Интеграция через MCP: Peekaboo может выступать как MCPсервер и «кормить» привычные AIинструменты (Claude Code, Cursor, Codex), что даёт бесшовный workflow — от обнаружения UIошибки до автокоррекции и валидации. Примеры из тестов: один пользователь показал сценарий, где агент запускает калькулятор, считывает результат с экрана, прогоняет проверку через Python и закрывает задачу — полностью автономный цикл, подтверждающий работоспособность концепта. Раньше агенты могли «помнить» и «планировать», но не могли надёжно выполнять мелкие, но критичные действия на десктопе. Peekaboo убирает этот барьер: теперь агенты могут не только инициировать процессы, но и доводить их до конца — от клика по кнопке до исправления UIбагов. Это усиливает такие сценарии, как автоматическое исправление ошибок разработки, UIтестирование, массовые правки контента на локальных интерфейсах и автоматизация ручных рабочих потоков. Peekaboo предлагает четыре пути запуска: Homebrew (CLI): brew install steipete/tap/peekaboo — для скриптовой автоматизации. MCPрежим (npx -y @steipete/peekaboo mcp) — интеграция с AIинструментами типа Cursor или Claude Code. Десктопприложение (GitHub Releases) — для пользователей без CLIопыта. Swift Package — встраивание в собственные macOSприложения. Инструкция и репозиторий доступны на GitHub и официальном сайте: peekaboo.sh и GitHub — openclaw/Peekaboo. Риски и ограничения Права доступа и безопасность: инструмент требует разрешений для скриншотов и управления интерфейсом — важно строгая модель прав и аудита, чтобы предотвратить нежелательные автоматические изменения. Надёжность: автоматические действия на UI зависят от стабильности интерфейса; мелкие изменения в приложении могут ломать сценарии. Этические и эксплуатационные вопросы: автоматическое изменение писем, публикаций или кода требует контроля, иначе возможны нежелательные последствия (например, отправка некорректного письма или публикация багнутого изменения). Peekaboo v3 — это существенный шаг в направлении реальных «десктопагентов», которые не только планируют, но и исполняют сложные действия. Для разработчиков и автоматизаторов это мощный инструмент; для индустрии — очередной сигнал, что агенты перестают быть абстрактной концепцией и становятся прагматичным рабочим ресурсом.

16Апр

OpenAI официально представила GPT-5.5 Instant и сделала ее новой моделью по умолчанию в ChatGPT, заменив предыдущую версию GPT-5.3 Instant. Речь идет не о нишевом обновлении: серия Instant — это основной «рабочий» слой ChatGPT для повседневного использования, через который ежедневно проходят сотни миллионов пользовательских запросов. Поэтому даже умеренное улучшение в такой модели означает очень заметный эффект в реальном масштабе. Судя по представленным данным, OpenAI сделала акцент на трех вещах: точность, лаконичность и персонализация. И именно это хорошо показывает, как меняется логика развития массовых ИИ-моделей: теперь важен уже не только уровень интеллекта как таковой, но и то, насколько модель удобна в реальной жизни — не многословна, не раздражает лишними уточнениями и лучше помнит контекст конкретного пользователя. Наиболее заметное улучшение OpenAI выделяет в областях с повышенной ценой ошибки: медицина, право и финансы. По внутренним тестам компании, уровень «галлюцинаций» в таких сценариях у GPT-5.5 Instant снизился на 52,5% по сравнению с предыдущей версией. Также на 37,3% сократилось количество ошибок в диалогах, которые пользователи ранее сами отмечали как проблемные. Это важный сигнал. До сих пор у массовых чат-ботов сохранялась фундаментальная проблема: они могли звучать уверенно даже там, где ошибались. Если OpenAI действительно смогла настолько заметно сократить ложные ответы именно в high-stakes-сценариях, это означает, что компания пытается сделать повседневную модель не просто «приятнее в общении», а ближе к уровню, где ей можно осторожнее доверять в практических задачах. Кроме того, улучшения коснулись: анализа изображений и фотографий; решения задач по математике и естественным наукам; понимания научных диаграмм; разбора документов; и способности самой модели лучше понимать, когда стоит вызывать веб-поиск. По опубликованным бенчмаркам, новая версия заметно прибавила именно в задачах, где требуется строгое рассуждение. Среди заявленных результатов: AIME 2025: 81,2 против 65,4 у GPT-5.3 Instant; GPQA: 85,6 против 78,5; MMMU-Pro: 76 против 69,2; CharXiv: 81,6 против 75; ошибка при разборе документов снизилась с 14,6% до 12,5%. OpenAI отдельно показала пример с алгебраической задачей: старая версия заметила, что один из ответов не подходит, и на этом остановилась, ошибочно заключив, что вещественных решений нет. GPT-5.5 Instant пошла дальше, нашла конкретную ошибку в промежуточных преобразованиях и довела решение до правильного ответа. Это тонкое, но важное отличие: модель не просто отбрасывает неверный вариант, а умеет лучше разбирать сам путь рассуждения. Второй крупный фокус обновления — стиль ответов. GPT-5.5 Instant сделали более короткой, более собранной и менее склонной к избыточному форматированию. OpenAI прямо подчеркивает, что модель теперь реже перегружает ответ лишней структурой, не злоупотребляет эмодзи и не задает ненужные уточняющие вопросы. Компания приводит бытовой пример: как вежливо дать понять слишком разговорчивому коллеге, что стоит говорить меньше. GPT-5.3 Instant выдала слишком «оформленный» ответ с несколькими стратегиями и списком того, чего делать не надо. GPT-5.5 Instant ответила на 30,2% короче по объему текста и на 29,2% короче по числу строк, при этом совет выглядел более естественным — как рекомендация от знакомого, а не как мини-гайд от корпоративного тренера. Это важное изменение, потому что для массового продукта качество общения все чаще определяется не только интеллектом, но и ритмом. Пользователю нужен не самый длинный ответ, а самый полезный ответ с минимальным когнитивным шумом. Третья ось обновления — персонализация. Для пользователей Plus и Pro OpenAI расширяет возможность использовать прошлые диалоги, загруженные файлы и даже связанный Gmail-контент, чтобы модель лучше понимала личный контекст пользователя и не требовала каждый раз объяснять одно и то же заново. В демонстрации с рекомендацией чайных мест GPT-5.3 Instant ограничилась общими вариантами в Сан-Франциско. GPT-5.5 Instant, напротив, смогла опереться на предыдущие разговоры пользователя: какие места он любит, какие напитки предпочитает, какой стиль ему ближе. За счет этого совет получился не просто географически релевантным, а по-настоящему персональным. По сути, OpenAI постепенно превращает ChatGPT из универсального собеседника в долговременного цифрового помощника, который не просто отвечает на запрос, а строит ответ с учетом накопленного профиля предпочтений и привычек. Еще одна важная новинка — функция Memory sources. Теперь, если модель использовала личный контекст или сохраненные воспоминания при формировании ответа, пользователь сможет увидеть, какие именно данные были задействованы. Это важный шаг к прозрачности: персонализация без объяснения источников быстро начинает вызывать тревогу. Например, если ChatGPT советует ужин на неделю, он может опираться на память о том, что пользователь тренируется к марафону, предпочитает легкую белковую еду и любит определенные продукты. В новом интерфейсе пользователь сможет увидеть эти «источники памяти», а также: отметить память как релевантную или нерелевантную; исправить устаревшую информацию; удалить отдельную запись; просмотреть весь список сохраненной памяти. OpenAI отдельно уточняет, что этот список источников не обязательно показывает вообще все, что модель могла учитывать, — пока это скорее наиболее релевантные элементы. Но направление очевидно: компания пытается сделать память модели не черным ящиком, а управляемым пользовательским инструментом. Для тех, кто не хочет, чтобы диалоги использовались для памяти, остается временный режим чата, в котором история не читается и не обновляется. GPT-5.3 Instant сохранится еще примерно на три месяца для платных пользователей, после чего будет окончательно выведена из эксплуатации. Персонализированные функции сначала запускаются для пользователей Plus и Pro на вебе, а позже должны появиться на мобильных устройствах и в других типах аккаунтов, включая бесплатные и корпоративные версии — в зависимости от региона и графика раскатки. Для разработчиков GPT-5.5 Instant уже доступна через API под именем chat-latest. На фоне релиза OpenAI добавила и фирменный PR-штрих: компания решила провести вечеринку по случаю запуска GPT-5.5, причем, по словам Сэма Альтмана, саму концепцию праздника он частично обсудил с моделью. ИИ якобы предложил, какой должна быть вечеринка: короткие выступления, тост от людей-создателей, минимум официоза, а также отдельный блок для сбора предложений по GPT-5.6. Даже время — 5:55 вечера 5 мая — было выбрано моделью. Место — штаб-квартира OpenAI в Сан-Франциско. Негородским гостям пообещали оплатить перелет и отель. Отбор приглашенных, как сообщается, делал Codex на основе ответов в соцсетях. За сутки зарегистрировались более 8000 человек, а тем, кто не прошел отбор, OpenAI в качестве утешения увеличила лимиты на использование Codex в десять раз. Отдельное внимание привлекла и шутка Альтмана о том, что Илон Маск тоже может прийти, если захочет, потому что «миру нужно больше любви». Учитывая нынешний конфликт Маска с OpenAI, реплика прозвучала как очевидный укол с улыбкой — легкий, но вполне рассчитанный на публичный эффект. Запуск GPT-5.5 Instant — это не просто очередной апдейт ChatGPT, а показатель того, куда движется

16Апр

В Сети появился «утёкший» материал о новой нативной видеомодели Google — Gemini Omni. Демонстрации вызвали взрыв интереса: реалистичные синтетические сцены, возможность редактировать видео «в диалоге», корректная подача рукописных математических формул — всё это заставило многих говорить о «видеоверсии Nano Banana». Утечка произошла как раз перед конференцией Google I/O (19 мая 2026), и если показанное подтвердится, рынок генеративного видео ждёт серьёзная встряска. Что именно показали в утечке Интерфейс в мобильном приложении Gemini с пунктом «Gemini Omni» и предложением «remix your videos / edit directly in chat / try templates». Поддержка мультимодальности: текст, изображение, аудио и видео на вход/выход. Технические параметры упомянуты в утечке: ролики до ~10 секунд, разрешение 1280×720 (по ID модели в утечке). Демки: профессор пишет и устно комментирует математические выкладки на классной доске — формулы выглядят корректно и связно; анимации и эффекты в других примерах демонстрируют высокую плавность и согласованность между кадрами. Модель умеет править видео «в реальном времени»: удалять водяные знаки, заменять объекты с сохранением света и маскировки перекрытий, выполнять стилизацию кадров (анимеэффекты и т. п.). В ранних тестах отмечается высокая скорость расхода квот/кредитов (cost/compute). Проблемы, которые Omni, кажется, решает Текстовая согласованность в видео долгое время оставалась «ахиллесовой пятой» генеративных видеомоделей: рукописные формулы и читаемый текст в кадре — редкое достижение. Демо с профессором, где формулы верны и пошагово объясняются, — важный маркер качества модели. Реальное видеоредактирование через «диалог» (описал — модель поменяла) значительно снижает порог создания и монтажа контента: не нужно знать таймкод, умело маскировать и вручную рисовать коррекции — модель делает это сама. Интеграция в экосистему Gemini (включая другие модальности) даёт модели преимущества в понимании контекста и связности действий — то, что отличает экспериментальные «генераторы видео» от действительно «встроенных в рабочие процессы» инструментов. Google может попытаться решить не только качество, но и интеграцию в продукты (мобильные приложения, экосистему Gemini), что позволит распределить стоимость и найти пути монетизации через сервисы и инструменты, а не только через дорогие облачные inferenceзадачи. Gemini Omni — гипотетическое появление «видеоприставки» к семейству больших моделей — выглядит как следующая крупная веха в генеративных медиа: от качественной генерации к инструментам «вмешательства и редактирования» в диалоге. Если всё подтвердится, индустрия генеративного видео получит мощный толчок, но вместе с ним — новые социальные, правовые и экономические вызовы. Устойчивость таких продуктов будет зависеть не только от качества синтеза, но и от решений по стоимости вычислений, модерации контента и интеграции в рабочие процессы.

16Апр

Anthropic и Amazon заключили одну из самых масштабных сделок в истории ИИ: компания собирается направить более $100 млрд на вычислительные мощности AWS в течение десяти лет, а общая доступная Anthropic мощность может достигнуть 5 гигаватт. Это сопоставимо с энергопотреблением крупной энергетической инфраструктуры и показывает, что гонка в ИИ всё больше превращается не только в борьбу моделей, но и в борьбу за электричество, чипы и дата-центры. Для Claude это означает серьезный запас для дальнейшего роста. По данным, выручка Anthropic за короткое время выросла с $1 млрд в годовом выражении до $30 млрд, а спрос на Claude со стороны компаний, разработчиков и обычных пользователей продолжает быстро увеличиваться. Особенно заметно растет направление Claude Code, ставшее одним из главных драйверов бизнеса. Для Amazon эта сделка тоже стратегически выгодна. Компания не просто инвестирует в Anthropic, но и закрепляет за AWS роль ключевой платформы для обучения и запуска Claude. В условиях, когда крупнейшие ИИ-компании наращивают потребление вычислительных ресурсов, облачная инфраструктура становится не менее важной, чем сами модели. Эта история хорошо показывает, как меняется рынок: сначала конкурировали языковые модели, затем — продукты и интерфейсы, а теперь главным полем битвы становится инфраструктура. ИИ-компании постепенно превращаются в гигантских потребителей энергии, а их успех всё сильнее зависит от того, кто сможет обеспечить им больше мощности и быстрее масштабироваться.

Если у вас есть инновационная идея, мы будем рады реализовать ее для Вас!

Специалисты нашей кампании и наши разработки для вас!