Новости

Социальные сети

Узнайте больше о рынке It и новейших технологиях.
СТАТЬИ
16Апр

За последний год стоимость использования больших языковых моделей заметно снизилась. Однако, как отмечают эксперты отрасли, настоящая борьба за удешевление искусственного интеллекта разворачивается вовсе не между разработчиками моделей, а на уровне инфраструктуры. Каждый AI-запрос требует вычислительных ресурсов, а значит — электроэнергии, охлаждения, высокопроизводительных серверов и современных дата-центров. По словам представителей китайской компании UCloud, именно стоимость электричества в конечном итоге определяет цену каждого обработанного токена. Поэтому новые центры обработки данных всё чаще строят в регионах с дешёвой электроэнергией и холодным климатом, где проще снизить расходы на охлаждение оборудования. Но инфраструктура — лишь часть задачи. Для бизнеса всё важнее становится эффективное использование ИИ. Компании начинают анализировать, какие модели действительно необходимы для конкретных задач, когда можно использовать более дешёвые решения, а также контролировать расход токенов сотрудниками. Всё большую роль играет грамотная маршрутизация запросов: сложные задачи отправляются мощным моделям, а рутинные — более экономичным. Одновременно растёт и общий спрос на вычисления. Генерация кода, изображений, видео, корпоративные помощники, интеллектуальные устройства и автономные агенты потребляют всё больше ресурсов. Поэтому снижение стоимости отдельных моделей не означает уменьшения расходов — объём использования ИИ продолжает быстро увеличиваться. Эксперты считают, что следующим этапом развития отрасли станет конкуренция не только между моделями, но и между поставщиками вычислительной инфраструктуры. Победят те компании, которые смогут эффективнее превращать каждый киловатт электроэнергии в полезные вычисления, обеспечивая высокую загрузку оборудования и минимальную стоимость обработки запросов. Таким образом, экономика искусственного интеллекта постепенно смещается от соревнования алгоритмов к оптимизации всей цепочки — от электросетей и дата-центров до корпоративного управления использованием ИИ. Именно эта эффективность в ближайшие годы станет одним из ключевых факторов конкурентоспособности отрасли.

16Апр

Пока все обсуждают чат-ботов и AI-агентов, начинается следующий этап развития искусственного интеллекта — его интеграция в робототехнику. Как отмечает Harvard Business Review, генеративный ИИ становится «мозгом» нового поколения сервисных роботов. Главное отличие таких роботов от предыдущих поколений заключается в том, что они больше не работают по жестко заданным сценариям. Благодаря большим языковым моделям (LLM) они способны понимать естественную речь, поддерживать диалог, учитывать контекст и принимать решения в нестандартных ситуациях. Дополняют их агентные системы, которые самостоятельно планируют и выполняют последовательность действий, а также большие поведенческие модели (Large Behavior Models), обучающие роботов физическим навыкам — от безопасного перемещения до работы с предметами. Авторы статьи отмечают, что первые успешные применения уже выходят за рамки лабораторий. В качестве примеров приводятся беспилотные автомобили Waymo, сервисный робот Robin в больницах США и человекоподобные роботы Figure, тестируемые на производстве BMW. По мнению исследователей, наибольший эффект генеративные роботы принесут в сферах с хронической нехваткой персонала: гостиничном бизнесе, здравоохранении, логистике, розничной торговле и общественном питании. При этом речь идет не о полной замене сотрудников, а о передаче роботам рутинных задач, чтобы люди могли сосредоточиться на более сложной и требующей эмпатии работе. Вместе с новыми возможностями появляются и новые вызовы: защита персональных данных, безопасность, контроль за обучением роботов и предотвращение нежелательного поведения. Поэтому авторы подчеркивают, что успешное внедрение таких систем требует не только технологий, но и продуманного управления. Генеративный ИИ постепенно выходит за пределы компьютеров и начинает работать в реальном мире. Следующая волна развития искусственного интеллекта будет связана уже не только с цифровыми агентами, но и с физическими роботами, способными взаимодействовать с людьми и окружающей средой.

16Апр

Рынок искусственного интеллекта сделал еще один шаг к повседневному использованию. Практически одновременно компании OpenClaw и Cursor представили собственные мобильные приложения, позволяющие работать с полноценными AI-агентами прямо со смартфона. Если раньше подобные системы были привязаны к браузеру или компьютеру, то теперь ими можно управлять из любой точки мира. Главная идея обоих продуктов заключается в том, что пользователь больше не обязан постоянно находиться за рабочим столом. Искусственный интеллект может самостоятельно выполнять длительные задачи, а человек подключается только тогда, когда требуется принять решение или утвердить результат. OpenClaw выпустил нативное приложение для iOS и Android, которое позволяет подключаться к собственному AI-шлюзу и управлять персональным агентом в режиме реального времени. Пользователь получает доступ к чатам, может запускать фоновые задачи, отслеживать работу агентов и подтверждать их действия прямо с телефона. Приложение также поддерживает использование аппаратных возможностей смартфона — камеры, GPS, галереи, календаря, контактов и других системных функций, при этом владелец самостоятельно определяет, какие разрешения предоставить. Разработчики делают ставку на архитектуру local-first: данные, ключи доступа и настройки остаются под контролем пользователя, а сама платформа позиционируется как решение без централизованного сбора персональной информации. В бесплатной версии доступны ограниченные возможности общения с ИИ, тогда как платная подписка открывает неограниченное использование сервиса. Вместе с тем разработчики признают, что подобные системы требуют широких системных разрешений и, как любые современные AI-агенты, остаются потенциально уязвимыми для атак через вредоносные инструкции (prompt injection). Практически одновременно с OpenClaw компания Cursor представила публичную бета-версию собственного приложения для iPhone. В отличие от OpenClaw, ориентированного на универсальные задачи, Cursor сосредоточен на разработке программного обеспечения. Мобильное приложение позволяет запускать облачных AI-агентов, которые самостоятельно анализируют код, исправляют ошибки, тестируют изменения и готовят pull request, пока пользователь занимается другими делами. Работа организована по двум сценариям. В первом случае агент полностью выполняет задачи в облачной виртуальной среде, независимо от компьютера пользователя. Во втором — приложение становится удаленным пультом управления агентом, уже работающим на домашнем или рабочем компьютере. Особое внимание уделено мобильному взаимодействию. Пользователь получает уведомления на экран блокировки, когда агент завершил работу, требует подтверждения изменений или подготовил код к объединению. Проверить внесенные изменения, оставить комментарии или принять pull request можно непосредственно со смартфона. Одновременный запуск мобильных приложений OpenClaw и Cursor отражает более глубокую тенденцию развития отрасли. AI постепенно перестает быть инструментом, которым человек управляет исключительно вручную. Вместо этого появляются автономные цифровые помощники, способные самостоятельно выполнять продолжительные задачи, пока пользователь находится вне рабочего места. Фактически меняется сама модель взаимодействия человека с искусственным интеллектом. Если раньше пользователь постоянно контролировал каждое действие системы, то теперь его роль все чаще сводится к постановке задачи и финальному утверждению результата. Такой подход особенно востребован в программировании, анализе документов, автоматизации рабочих процессов и управлении цифровыми сервисами, где многие операции могут выполняться без постоянного участия человека. Появление мобильных версий OpenClaw и Cursor показывает, что следующий этап развития искусственного интеллекта связан не столько с ростом мощности моделей, сколько с изменением способов их использования. Смартфон постепенно превращается в универсальный центр управления AI-агентами, которые продолжают работать в облаке или на локальном сервере независимо от местонахождения владельца. Человек получает возможность запускать сложные процессы, контролировать их выполнение и принимать ключевые решения буквально на ходу. Если этот подход станет массовым, привычная модель работы с искусственным интеллектом изменится так же радикально, как когда-то переход от стационарных компьютеров к мобильным устройствам. AI перестает быть инструментом, привязанным к рабочему месту, и становится постоянным цифровым помощником, доступным в любой момент и практически в любом месте.

16Апр

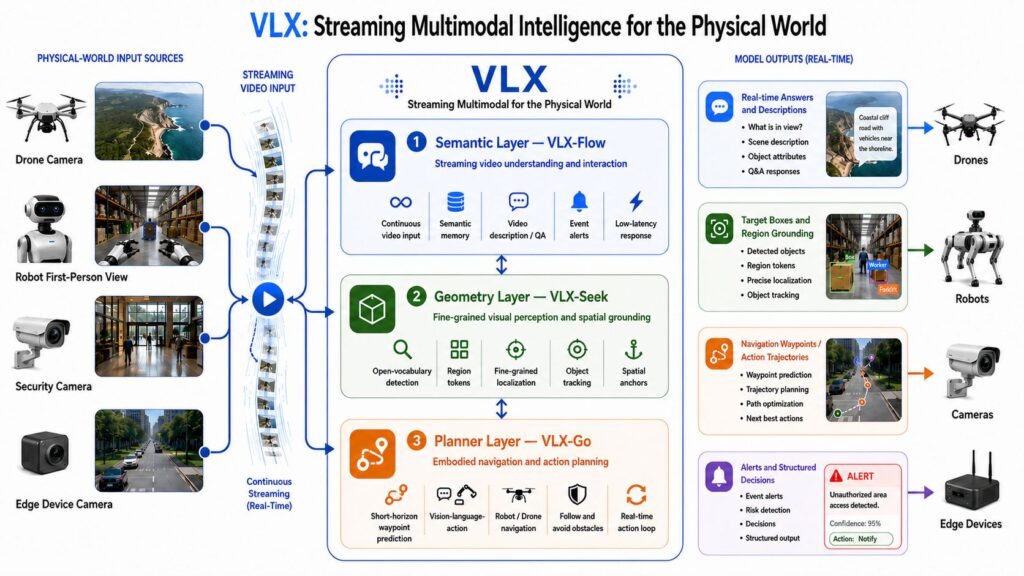
Китайская компания Om AI анонсировала семейство моделей VLX, которое позиционируется как первая в мире потоковая мультимодальная система, разработанная специально для работы на конечных устройствах в физическом мире. В отличие от традиционных моделей, анализирующих заранее записанные видео, VLX способна непрерывно обрабатывать видеопоток в режиме реального времени и практически мгновенно реагировать на изменения окружающей среды. Платформа состоит из трех взаимосвязанных компонентов. VLX-Flow отвечает за постоянное восприятие окружающего пространства, непрерывно анализируя видеопоток без остановок на обработку отдельных кадров. VLX-Seek обеспечивает точное определение объектов и их местоположения, используя новый подход, основанный на выборе наиболее подходящей области изображения вместо вычисления координат. VLX-Go превращает результаты анализа в конкретные команды движения, позволяя роботам, дронам и другим устройствам самостоятельно следовать маршруту, обходить препятствия и выполнять навигацию. По словам разработчиков, архитектура изначально создавалась для работы непосредственно на устройствах, а не является упрощённой версией облачной модели. Благодаря этому удалось добиться минимальной задержки — до 0,06 секунды, а также обеспечить поддержку моделей различного размера — от 0,6 до 10 млрд параметров. Главное отличие VLX заключается в изменении самого принципа работы искусственного интеллекта. Если традиционные мультимодальные модели реагируют только после получения запроса пользователя, то новая система постоянно наблюдает за происходящим, анализирует изменения и при необходимости самостоятельно принимает решения. Такой подход особенно востребован в робототехнике, беспилотном транспорте, промышленных инспекционных системах, интеллектуальных камерах и других устройствах, которым необходимо работать в постоянно меняющейся реальной среде. В Om AI считают, что именно подобные потоковые модели могут стать одной из ключевых технологий следующего поколения физического искусственного интеллекта, где важны не только понимание информации, но и способность непрерывно воспринимать окружающий мир, быстро принимать решения и сразу выполнять необходимые действия.

16Апр

Anthropic готовит крупное обновление Claude Code, которое меняет сам подход к AI-программированию. Теперь дочерние AI-агенты смогут автоматически выполнять задачи в фоновом режиме, пока разработчик продолжает обсуждать проект с основным ассистентом. Идея проста: вместо ожидания завершения одной операции пользователь сможет параллельно вести диалог, а AI тем временем рефакторит код, запускает тесты, анализирует проект и готовит pull request. При необходимости любую задачу можно вывести на передний план. Это продолжение стратегии Anthropic по превращению Claude Code из обычного чат-бота в полноценную платформу управления рабочими процессами. Ранее компания уже представила Routines для автоматического запуска задач по расписанию и Dynamic Workflows, позволяющие распределять сложные проекты между десятками специализированных AI-агентов. Эффективность такого подхода подтверждают реальные компании. В Spotify, где кодовая база превышает 20 миллионов строк, AI уже участвует примерно в 73% всех pull request. Инженеры одновременно запускают несколько сессий Claude Code, а сами сосредотачиваются на принятии решений и проверке результатов, а не на ручном написании кода. По словам создателя Claude Code Бориса Черны, он уже несколько месяцев практически не пишет код самостоятельно, управляя вместо этого тысячами AI-агентов. Главный вывод заключается в том, что роль разработчика постепенно меняется. Если раньше главным навыком было умение писать код, то теперь все больше ценится способность правильно формулировать задачи, проектировать архитектуру и принимать инженерные решения, оставляя большую часть рутинной работы искусственному интеллекту.

16Апр

До недавнего времени главным эффектом развития искусственного интеллекта считался рост производительности. Новые модели быстрее пишут код, помогают создавать контент и автоматизируют интеллектуальную работу. Однако к 2026 году становится заметен другой, менее очевидный эффект: AI начинает менять экономику целых городов. Хороший пример — Сан-Франциско. Еще несколько лет назад годовой доход в $180–200 тысяч считался очень высоким даже по американским меркам. Сегодня сотрудники крупных технологических компаний с такой зарплатой все чаще жалуются, что не могут позволить себе комфортное жилье. Причина заключается не в снижении их доходов, а в появлении новой категории сверхбогатых работников. Компании вроде OpenAI и Anthropic оцениваются в сотни миллиардов долларов и готовятся к выходу на биржу. Помимо высоких зарплат, их сотрудники получают крупные пакеты акций, стоимость которых после IPO может многократно вырасти. Эти деньги начинают поступать на рынок недвижимости, повышая спрос и подталкивая вверх стоимость аренды и покупки жилья. В результате меняется сама структура рынка. Если раньше цены определялись доходами обычных инженеров и специалистов IT, то теперь все большее влияние оказывают сотрудники наиболее успешных AI-компаний. Для остальных работников технологического сектора жизнь в городе становится заметно дороже, несмотря на то что их собственные зарплаты остаются весьма высокими. Этот процесс отражает более широкую тенденцию. AI перестает быть исключительно программной индустрией и все сильнее влияет на реальную экономику. Растет спрос на дата-центры, электроэнергию, высокоскоростную память, графические процессоры и недвижимость. Выигрывают не только разработчики моделей, но и владельцы инфраструктуры, обеспечивающей работу искусственного интеллекта. История показывает, что подобные изменения сопровождают практически каждую технологическую революцию. Во времена золотой лихорадки больше всего заработали не старатели, а поставщики оборудования и владельцы земли. Во время интернет-бума ключевыми бенефициарами стали компании, контролировавшие цифровую инфраструктуру. В эпоху AI похожую роль начинают играть производители вычислительного оборудования, операторы дата-центров, энергетические компании и крупнейшие разработчики моделей. Сан-Франциско, вероятно, лишь первым столкнулся с этими изменениями. По мере развития искусственного интеллекта похожие процессы могут проявиться и в других мировых технологических центрах. AI уже меняет не только способы работы людей, но и стоимость жизни, рынок недвижимости и экономическую структуру городов. Это означает, что влияние искусственного интеллекта выходит далеко за пределы программного обеспечения и становится фактором, способным менять устройство современной экономики.

16Апр

В США разгорается очередной спор вокруг надёжности систем, определяющих, был ли текст написан с помощью искусственного интеллекта. Поводом стала история студента одного из частных университетов штата Нью-Йорк, который утверждает, что его дипломная работа была ошибочно признана «на 98% созданной ИИ». По словам студента, на подготовку 30-страничной выпускной работы он потратил около шести месяцев. Однако после проверки университетской системой контроля академической честности преподаватели сообщили, что алгоритм практически полностью отнес текст к категории сгенерированных искусственным интеллектом. В результате университет начал официальное расследование. Если обвинения будут подтверждены, студенту может грозить неудовлетворительная оценка за дипломную работу, дисциплинарное отстранение и потеря ежегодной стипендии в размере 45 тысяч долларов, которая покрывает большую часть стоимости обучения. Студент попытался доказать свою невиновность, представив историю редактирования документа в Google Docs. По его словам, журнал изменений подробно фиксирует весь процесс написания работы: от первых набросков до многочисленных исправлений и переработок текста. Однако, как утверждает автор публикации, дисциплинарная комиссия отказалась рассматривать эти материалы, сославшись на результаты автоматической проверки. История вызвала широкий резонанс в социальных сетях. Многие пользователи поделились похожими случаями, когда системы ошибочно определяли как созданные ИИ тексты, написанные задолго до появления современных языковых моделей. Один из комментаторов рассказал, что научная статья, опубликованная им еще в 1976 году, также получила высокий «процент генерации ИИ» при проверке современным сервисом. Исследования также подтверждают существование подобных ошибок. Ранее ученые Стэнфордского университета выяснили, что популярные детекторы ИИ нередко ошибочно классифицируют как машинные тексты, написанные людьми, особенно если авторы используют грамотный академический стиль или являются иностранными студентами, пишущими на английском языке. На фоне подобных проблем ряд университетов уже пересматривает свою политику использования таких инструментов. Разработчики системы Turnitin, одной из самых популярных платформ для проверки академических работ, неоднократно подчеркивали, что результаты ИИ-детекторов не должны использоваться как единственное доказательство нарушения академической честности. Аналогичную позицию заняли и некоторые американские университеты, включая Вандербильт, Корнелл и Дьюк, ограничив применение автоматических проверок. Эксперты отмечают, что проблема выходит далеко за рамки технической точности алгоритмов. Современные ИИ-детекторы работают как «черный ящик»: они выдают вероятностную оценку, но не объясняют, каким образом пришли к своему выводу. В результате судьбоносные решения могут приниматься на основе непрозрачных алгоритмов, которые сами разработчики не считают абсолютно надежными. История американского студента вновь поставила перед образовательным сообществом сложный вопрос: если искусственный интеллект используется для выявления текстов, созданных ИИ, то какими способами человек сможет убедительно доказать, что его работа действительно написана самостоятельно?

16Апр

Первым, кто дал инструмент для управления хаосом, был Якоб Бернулли. Закон больших чисел –идеологический фундамент любого бизнеса, основанного на обслуживании. Мы не можем предсказать поведение одного клиента, мы точно можем предсказать поведение ста тысяч. Когда количество независимых случайных событий увеличивается, среднее значение стремится к математическому ожиданию. Для руководителя колл-центра это означает переход от гадания к инженерии. Если у вас 10 клиентов, бизнес –лотерея. Если 10 миллионов – статистика. Закон больших чисел позволяет понять, что завтра в 10:00 утра поступит именно 450 звонков, плюс-минус три процента, хотя каждый звонящий принимает решение о наборе номера абсолютно самостоятельно. Этот принцип лежит в основе прогнозирования спроса и управления очередями. Настоящий прорыв в массовом обслуживание случился, когда математики начали изучать точность стрельбы и ввели понятие «коридора». Когда снаряд вылетает из пушки, на него действуют тысячи случайных факторов: влажность, колебания ствола, микроскопические примеси в порохе. Снаряды ложатся не в одну точку, а образуют фигуру рассеивания. Так появилось понятие доверительного коридора. В колл-центре — коридор ожидания. Если понимаем распределение Гаусса, можем рассчитать, какой процент клиентов попадёт в интервал времени ожидания. Коридор попадания превратился в Service Level – главный показатель, определяющий, сколько ресурсов готовы потратить, чтобы удержать качество в заданных границах. Показатель устанавливает связь между статистической вероятностью события и операционной реальностью. Теория массового обслуживания (ТМО) родилась из технологического тупика. В начале XX века телефонные сети Дании столкнулись с кризисом: количество абонентов росло, а соединительных линий было ограничено. Нельзя было проложить провод к каждому дому от каждой станции. Агнер Краруп Эрланг, работая в Копенгагенской телефонной компании, решил эту задачу через математическое моделирование. Понял, что телефонная сеть – не просто провода, а живой организм, где заявки на соединение конкурируют за ограниченный ресурс (коридор). Учёный первым вывел формулы, которые позволили рассчитать вероятность отказа в обслуживании. Erlang B и Erlang C – до сих пор являются «золотым стандартом» планирования и основой для расчёта размеров колл-центров, служб поддержки и нагрузки серверных систем. Великий математик Хинчин дополнил картину, создав модель поиска ожиданий. Показал, что случайный процесс в системе можно описать через «память» системы. Концепция позволила инженерам учитывать не только мгновенный входящий сигнал, но и накопленную инерцию. Которая продолжает влиять на скорость обслуживания даже после того, как пик нагрузки прошёл. Понимание связи критически важно для настройки параметров задержек, так как объясняет, почему система не возвращается в норму мгновенно после кратковременного сбоя. Гнеденко развил методы расчёта потерь, доказав, что при высокой загрузке каналов всплеск нагрузки приводит к лавинообразному росту отказов. Добавление всего одной случайной заявки может стать «последней каплей», вызывающей каскадное падение всех сервисов. Однако, как верно заметил Хевенг, в теории массового обслуживания главными являются не сухие цифры, а понимание физики процесса. ТМО – искусство находить баланс между экономикой (не держать лишних сотрудников/серверов) и качеством (не заставлять клиентов ждать). Чтобы построить эффективный колл-центр, необходимо декомпозировать работу на элементарные частицы: заявка, задача и поток. Без чёткой терминологии расчёт нагрузки превращается в гадание. Все начинается с заявки, в телефонии входящий вызов, в мессенджере –HTTP-запрос/сообщение. Когда заявка попадает в систему, должна быть решена определённая задача. Задача – повторяющаяся активность: авторизация пользователя, поиск данных в базе, ответ на вопрос или перевод звонка. Последовательность заявок образует поток — реку, которая течёт через колл-центр. Потоки бывают разными. Регулярный поток предсказуем: например, если вы договорились с клиентами, что будете обзванивать их строго каждые 5 минут. Здесь нет ТМО, здесь есть расписание. Случайный поток – реальность. Заявки приходят в неопределённый моменты времени, и не имеют контроля. Вступает в силу распределение Пуассона, описывающее вероятность прихода определённого количества заявок за интервал времени. Канал – то, что потребляет заявку. В классическом колл-центре канал – оператор. В цифровом сервисе каналом может выступать поток процессора (goroutine) или открытое TCP-соединение. Процесс обслуживания – время от момента, когда канал взял заявку, до момента освобождения. Здесь кроется критическая ловушка: время обслуживания почти всегда является случайной величиной. Один клиент решит вопрос за минуту, другой за сорок. Среднее время удобно для отчётов, но дисперсия (разброс) времени обслуживания напрямую влияет на длину очереди. Если все каналы заняты, заявка попадает в очередь. Очередь – буфер, который сглаживает пики нагрузки. Однако очередь не живёт сама по себе. Существует дисциплина обслуживания – набор правил, по которым система выбирает, кого обслужить следующим: FIFO (First In, First Out) – кто первый пришёл, тот первый обслужен. Приоритетное обслуживание – когда VIP-клиент или экстренный вызов обходит очередь. Приоритеты могут быть статичными (по типу клиента) или динамичными (когда приоритет растёт по мере ожидания). LIFO – редкий случай, когда последняя пришедшая заявка обрабатывается первой (часто встречается в некоторых компьютерных стеках). Уровень терпимости — самый сложный параметр для расчёта в ТМО. Человек не пакет данных, у него есть предел ожидания. Если очередь слишком длинная, клиент вешает трубку или закрывает приложение. Ограничения характеризуются как «система с ограниченным временем ожидания». Задача архитекторов – рассчитать систему так, чтобы время ожидания не превышало порог терпимости основной массы пользователей. Иначе будут тратиться ресурсы на обслуживание «разозлённых» клиентов, которые уже не лояльны или потеря клиентов с высокой маржой. В зависимости от того, как настроены правила, колл-центр может превратиться в одну из следующих систем: Системы с отказом (Loss Systems): если свободного канала нет, заявка просто исчезает. Клиент слышит короткие гудки. Это самая простая и самая жёсткая модель. Здесь считается вероятность того, что клиент вообще не дозвонится. Системы с ожиданием (Queue Systems): С неограниченной очередью: теоретическая модель, где клиент готов ждать вечно. В реальности это приводит к коллапсу системы, если интенсивность прихода заявок выше интенсивности обслуживания. С ограниченным ожиданием: когда мы принудительно разрываем соединение через 5 минут или когда клиент сам уходит. Марковские системы: системы с «отсутствием памяти». Вероятность того, что произойдёт переход из одного состояния в другое (например, из «все свободны» в «один занят»), зависит только от текущего состояния, а не от того, что было час назад. Немарковские системы: здесь важна предыстория. Если операторы устают к концу смены, время обслуживания начинает расти. Системы с предпосылками, и их расчёт требует сложных имитационных моделей. Для прогнозирования нужно понимать ключевые показатели производительности. Нельзя просто сказать «нам нужно 100 человек». Мы должны знать: Среднее число заявок, обслуженных за единицу времени — пропускная способность Средняя доля времени простоя. Если операторы заняты 100% времени, очередь будет расти до бесконечности. Здоровая система всегда имеет «запас тишины» Пропущенные циклы

16Апр

Судебные разбирательства вокруг авторских прав в сфере искусственного интеллекта выходят на новый уровень. Если раньше основное внимание уделялось разработчикам моделей, то теперь истцы пытаются привлечь к ответственности и компании, обеспечивающие технологическую инфраструктуру для обучения ИИ. 25 июня 2026 года газета The New York Times подала обновлённый иск против OpenAI и Microsoft. По мнению издания, Microsoft не просто предоставила облачные мощности, а сыграла активную роль в создании специализированной вычислительной инфраструктуры для обучения моделей OpenAI. Речь идет о суперкомпьютере, включающем более 285 тысяч процессорных ядер и 10 тысяч графических ускорителей. Параллельно почти 400 американских региональных газет также обратились в суд с иском против Microsoft и OpenAI. Они утверждают, что их статьи без разрешения использовались для обучения ChatGPT и Copilot. Кроме того, истцы заявляют, что при обработке текстов удалялись сведения об авторах и уведомления об авторских правах, что, по их мнению, нарушает положения американского Закона об авторском праве в цифровую эпоху (DMCA). Главный вопрос этих процессов выходит далеко за рамки традиционного спора о том, кто непосредственно обучал модель. Суду предстоит определить, может ли компания, предоставляющая специализированную инфраструктуру, коммерческую поддержку и интеграцию технологий в собственные продукты, нести ответственность как соучастник возможного нарушения авторских прав. Особенность положения Microsoft заключается в ее тесной связи с OpenAI. Компания не только является одним из крупнейших инвесторов разработчика, но и предоставляет вычислительные мощности Azure, а также интегрировала модели OpenAI в Copilot, Bing, Microsoft 365 и другие сервисы. Это усложняет аргумент о том, что Microsoft выступает лишь нейтральным поставщиком облачных услуг. Для издателей проблема выходит за рамки самого факта использования материалов для обучения ИИ. Они опасаются изменения всей экономической модели отрасли. Если пользователи получают краткие ответы и пересказы непосредственно от чат-ботов, то посещаемость сайтов СМИ, подписки и рекламные доходы могут существенно сократиться. В результате расходы на создание журналистского контента остаются у редакций, тогда как основную коммерческую выгоду получают разработчики ИИ. Отдельное внимание в новых исках уделяется возможному удалению информации об авторских правах во время подготовки данных для обучения моделей. Если суд признает такие действия нарушением DMCA, это может стать дополнительным основанием для ответственности, выходящим за рамки обычных претензий о незаконном копировании контента. Несмотря на это, OpenAI и Microsoft, вероятно, продолжат строить защиту на принципе добросовестного использования (fair use), утверждая, что модели не копируют произведения, а анализируют закономерности языка и знаний. Однако издатели настаивают, что использование новостных материалов напрямую влияет на их бизнес и снижает ценность оригинального контента. Эксперты отмечают, что эти судебные процессы могут определить новые правила для всей индустрии искусственного интеллекта. Компании, работающие с ИИ, все чаще будут обязаны не только подтверждать законность источников данных, но и документировать весь процесс их обработки, распределяя ответственность между разработчиками моделей, поставщиками инфраструктуры и владельцами контента.

16Апр

Несмотря на ожидания рынка, OpenAI, вероятно, не выйдет на биржу в 2026 году. По данным американских СМИ, руководство компании рассматривает возможность переноса IPO на 2027 год. Главная причина — стремление добиться оценки не менее 1 трлн долларов. По информации источников, генеральный директор OpenAI Сэм Альтман не готов соглашаться на более низкую капитализацию. Консультанты предлагали провести размещение уже сейчас, пусть и с меньшей оценкой, однако руководство предпочитает дождаться более благоприятного момента. Одним из факторов стала ситуация вокруг SpaceX. После громкого IPO компания столкнулась со снижением стоимости акций, что стало сигналом для инвесторов: публичный рынок сегодня гораздо осторожнее оценивает даже крупнейшие технологические компании. Для OpenAI это означает необходимость не только демонстрировать высокие темпы роста, но и убедить рынок в долгосрочном лидерстве в сфере искусственного интеллекта. Компания рассчитывает укрепить свои позиции за счет новых моделей ИИ, дальнейшего роста корпоративной выручки и усиления конкурентных преимуществ перед такими игроками, как Anthropic. Если Anthropic действительно выйдет на биржу раньше, именно она может стать ориентиром для оценки всего сектора генеративного ИИ. Перенос IPO уже оказывает влияние на рынок. После появления соответствующих сообщений снизились котировки японской SoftBank — одного из крупнейших инвесторов OpenAI, а также компаний, связанных с развитием ИИ-инфраструктуры. Инвесторы лишились ожидаемого ориентира стоимости одного из самых дорогих стартапов мира. При этом OpenAI продолжает активно расходовать средства на развитие дата-центров, исследования и привлечение специалистов. Оставаясь частной компанией, она сохраняет свободу от давления публичного рынка, однако одновременно откладывает раскрытие своей финансовой отчетности, которая станет доступна инвесторам только после выхода на биржу. Таким образом, решение отложить IPO связано не столько с поиском более высокой цены, сколько со стремлением выйти на рынок в момент, когда компания сможет подтвердить свое технологическое и коммерческое лидерство. Для OpenAI оценка в один триллион долларов — это не просто амбициозная цель, а важный инструмент для привлечения капитала, лучших специалистов и сохранения стратегической независимости в условиях стремительно растущей конкуренции на рынке искусственного интеллекта.

Если у вас есть инновационная идея, мы будем рады реализовать ее для Вас!

Специалисты нашей кампании и наши разработки для вас!